الصناديق مقابل الأقنعة: متى تحتاج فعلًا إلى التجزئة
قِس ما يضيفه القناع إلى الصندوق على صورة حقيقية، وحدّد ما إذا كان مشروعك يحتاج إلى الشكل استنادًا إلى النظام الذي يستهلك المخرجات.
الأقنعة هي ما يتخيله معظم الناس عند التفكير في الرؤية بالذكاء الاصطناعي، وهي المجال الذي تنفق فيه الفرق أكبر ميزانيات وسم البيانات. يحدّد القناع الشكل الدقيق للكائن؛ أما الصندوق فلا يحدد سوى موقعه. وقد يحسم هذا الفرق قرار بعض المنتجات تمامًا، بينما لا يغيّر شيئًا في معظمها.
عملي
ما الذي يضيفه القناع؟#
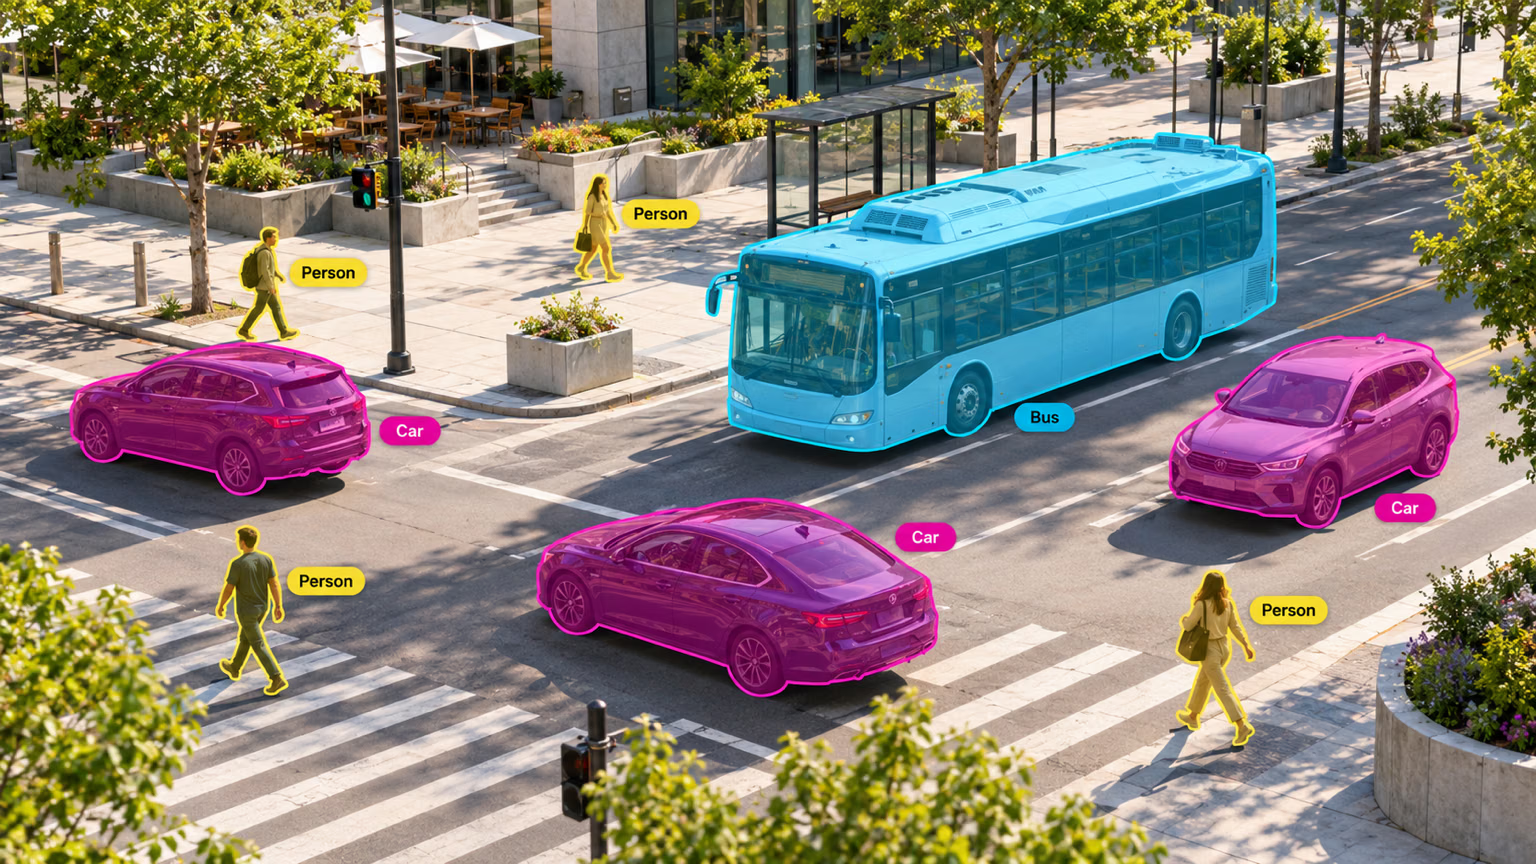
تعيد مهمة التجزئة لكل كائن كل ما يعيده الكاشف — الفئة والصندوق والثقة — بالإضافة إلى البكسلات التي تنتمي إلى الكائن؛ لذا تحصل كل سيارة أعلاه على حدّ خاص بها، منفصل عن الحافلة والمشاة. اقرأ القناع على هيئة مضلع (masks.xy) أو صورة ثنائية (masks.data).
إلى أي حد يغيّر الشكل الأرقام؟ قارن مساحة صندوق كل كائن بمساحة قناعه:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)لا تشغل الحافلة سوى 62% من صندوقها، ويشغل أحد الأشخاص 31% فقط من صندوقه. وأي قيمة تُحسب من الصناديق وحدها — مثل المساحة المطلية أو حجم الانسكاب أو مقدار الرف الفارغ — ستخطئ بهذه النسبة. إذا كان منتجك يعرض قيمة من هذا النوع، فأنت تحتاج إلى الأقنعة. أما إذا كان يكتفي بالعدّ أو تحديد المواقع، فلن تضيف البكسلات الزائدة شيئًا.
العَرَض: مساحات الأقنعة تبدو أصغر بمقدار 3–4× من مساحات المربعات. السبب: يُرجع masks.data افتراضيًا الأقنعة بحجم الاستدلال (هنا 640×480)، بينما تكون المربعات بوحدات بكسلات الصورة الأصلية (1080×810). الحل: مرّر retina_masks=True كما سبق، أو احسب التحجيم بنفسك.
اتخذ القرار بناءً على النظام المستهلك، لا العرض التوضيحي#
| الاحتياج اللاحق | هل تكفي الصناديق؟ | السبب |
|---|---|---|
| عدّ الكائنات أو التحقق من وجودها | نعم | الموقع هو الإجابة كاملة |
| إصدار تنبيه عند دخول كائن إلى منطقة | نعم | يكفي عبور صندوق لخط |
| تتبّع الكائنات عبر الإطارات | نعم | تربط أدوات التتبع بين الصناديق |
| اقتصاص صورة لمصنّف ثانٍ | نعم | لا يحتاج الاقتصاص إلا إلى الصندوق |
| قياس المساحة أو التغطية (الأعشاب الضارة، والصدأ، والانسكابات) | لا | تجعل الأشكال غير المنتظمة مساحة الصندوق بلا معنى |
| قصّ الكائن (إزالة الخلفية، والواقع المعزز) | لا | تحتاج إلى الحافة الدقيقة |
| التحقق من الخلوص أو التلامس (إمساك الروبوت، والاصطدام) | لا | تُظهر مساحة الصندوق الكائن أكبر مما هو عليه |
| فصل الكائنات المتلامسة وغير المنتظمة | غالبًا لا | يطمس تداخل الصناديق تحديد البكسلات التي تنتمي إلى كل كائن |
إذا كانت إجابة كل صف يحتاج إليه منتجك هي «نعم»، فاعتمد كاشفًا. ولا تلجأ إلى تجزئة YOLO26 إلا عندما تكون معرفة الشكل ذات قيمة فعلية.
تجزئة الكائنات مقابل التجزئة الدلالية#
تمنح تجزئة الكائنات كل كائن قناعه الخاص، لذا تظل السيارات الثلاث المتداخلة ثلاث سيارات. أما التجزئة الدلالية فتُسنِد فئة إلى كل بكسل ولا تقدّم شيئًا آخر: تصبح كل بكسلات السيارات منطقة واحدة باسم «سيارة»، ويضيع العدد. استخدم تجزئة الكائنات لعدّ الكائنات الفردية — مثل الخلايا والفاكهة والعيوب — أو قياسها. واستخدم التجزئة الدلالية لقياس تغطية المناطق — مثل الطريق مقابل الرصيف، أو المحاصيل مقابل التربة.
تكلفة وسم الأشكال#
يتطلب الصندوق نقرتين. وقد يستغرق رسم مضلع جيد عشرات النقرات، كما أن كل حافة موضع محتمل للاختلاف بين المعلّقين: هل تُعد الحقيبة جزءًا من الشخص؟ وهل يُعد الظل جزءًا من السيارة؟ قِس تكلفتك بنفسك بدلًا من الاعتماد على قاعدة تقريبية: احسب زمن وسم 20 كائنًا على هيئة صناديق، ثم الكائنات العشرين نفسها على هيئة مضلعات، واضرب الفرق في حجم مجموعة البيانات.
تقلّص الأدوات المدعومة بالذكاء الاصطناعي الفارق إلى حد كبير. تقترح أدوات التعليق الذكي ووضع العلامات على دفعات قناعًا انطلاقًا من نقرة أو صندوق، فيصحّح المعلّقون الحواف بدلًا من تتبّعها — لكن لا يزال على أحدهم مراجعة كل حدّ.
حدّدوا كيفية التعامل مع الحجب، والأجسام الشفافة، والظلال، والأجسام التي تقطعها حافة الإطار، والعناصر الملحقة (الحقائب والمقابض والحمولات) قبل بدء وضع التسميات، وامنحوا العاملين على التعليقات التوضيحية والمراجعين الصفحة نفسها. يشرح أفضل ممارسات وضع التعليقات التوضيحية كيفية تطبيقها؛ وتُظهر مجموعة بيانات COCO-Seg أقنعة متسقة على نطاق واسع.
عند أخذ عينات لفحص الأقنعة، ابحث عن التسرّب (امتداد القناع إلى ما وراء الحافة)، والثقوب (مناطق مفقودة داخل الكائن)، والحواف الوهمية (اتباع القناع لأثر ناتج عن ضغط JPEG)، والأجزاء الملتبسة (هل يُدرج مقبض الحقيبة ضمن قناع الحقيبة؟).
عرض الحل
لنفترض أن منتجين يشتركان في كاميرا الحافلة: عداد أشخاص وتقرير إشغال الشارع الذي يبيّن مقدار ما تغطيه المركبات من المشهد. قِس الإجابتين من التشغيل نفسه:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- عداد الأشخاص ← الصناديق. العدد هو 4 في الحالتين؛ فالأقنعة تزيد تكلفة وسم البيانات ولا تغيّر شيئًا.
- تقرير الإشغال ← الأقنعة. تفيد الصناديق بأن الحافلة تغطي 47% من المشهد، بينما تغطيه فعليًا بنسبة 29%. وسيكون التقرير المعتمد على الصناديق مخطئًا بأكثر من النصف.