التعليق التوضيحي الذكي وإسناد التسميات على دفعات
اختر نموذجًا لإسناد التسميات وحدًّا للثقة بقياس حجم عمل المراجعة، ثم شغّل التعليق التوضيحي على دفعات وتحقق من النتيجة بمعدل التعديلات.
قد لا يتجاوز رسم الصناديق يدويًا 100 صورة في الساعة؛ أما مراجعة التسميات الأولية الجيدة فقد تكون أسرع بعدة مرات. لكن استخدام نموذج لإسناد التسميات مع حدّ ثقة غير مناسب قد يضيف عملًا أكثر مما يوفر، وترك نتائجه من دون مراجعة يعلّم نموذجك التالي أخطاء النموذج نفسه. يقيس هذا الدرس عمل المراجعة عند كل حدّ على بيانات حقيقية عليها تسميات، لتختار الحدّ بناءً على الأرقام لا التخمين.
عملي
ثلاث طرق لإسناد التسميات الأولية#
في محرر التعليقات التوضيحية، يكون وضع Draw (V) يدويًا، بينما يتيح وضع Smart (S) للنموذج اقتراح التسميات:
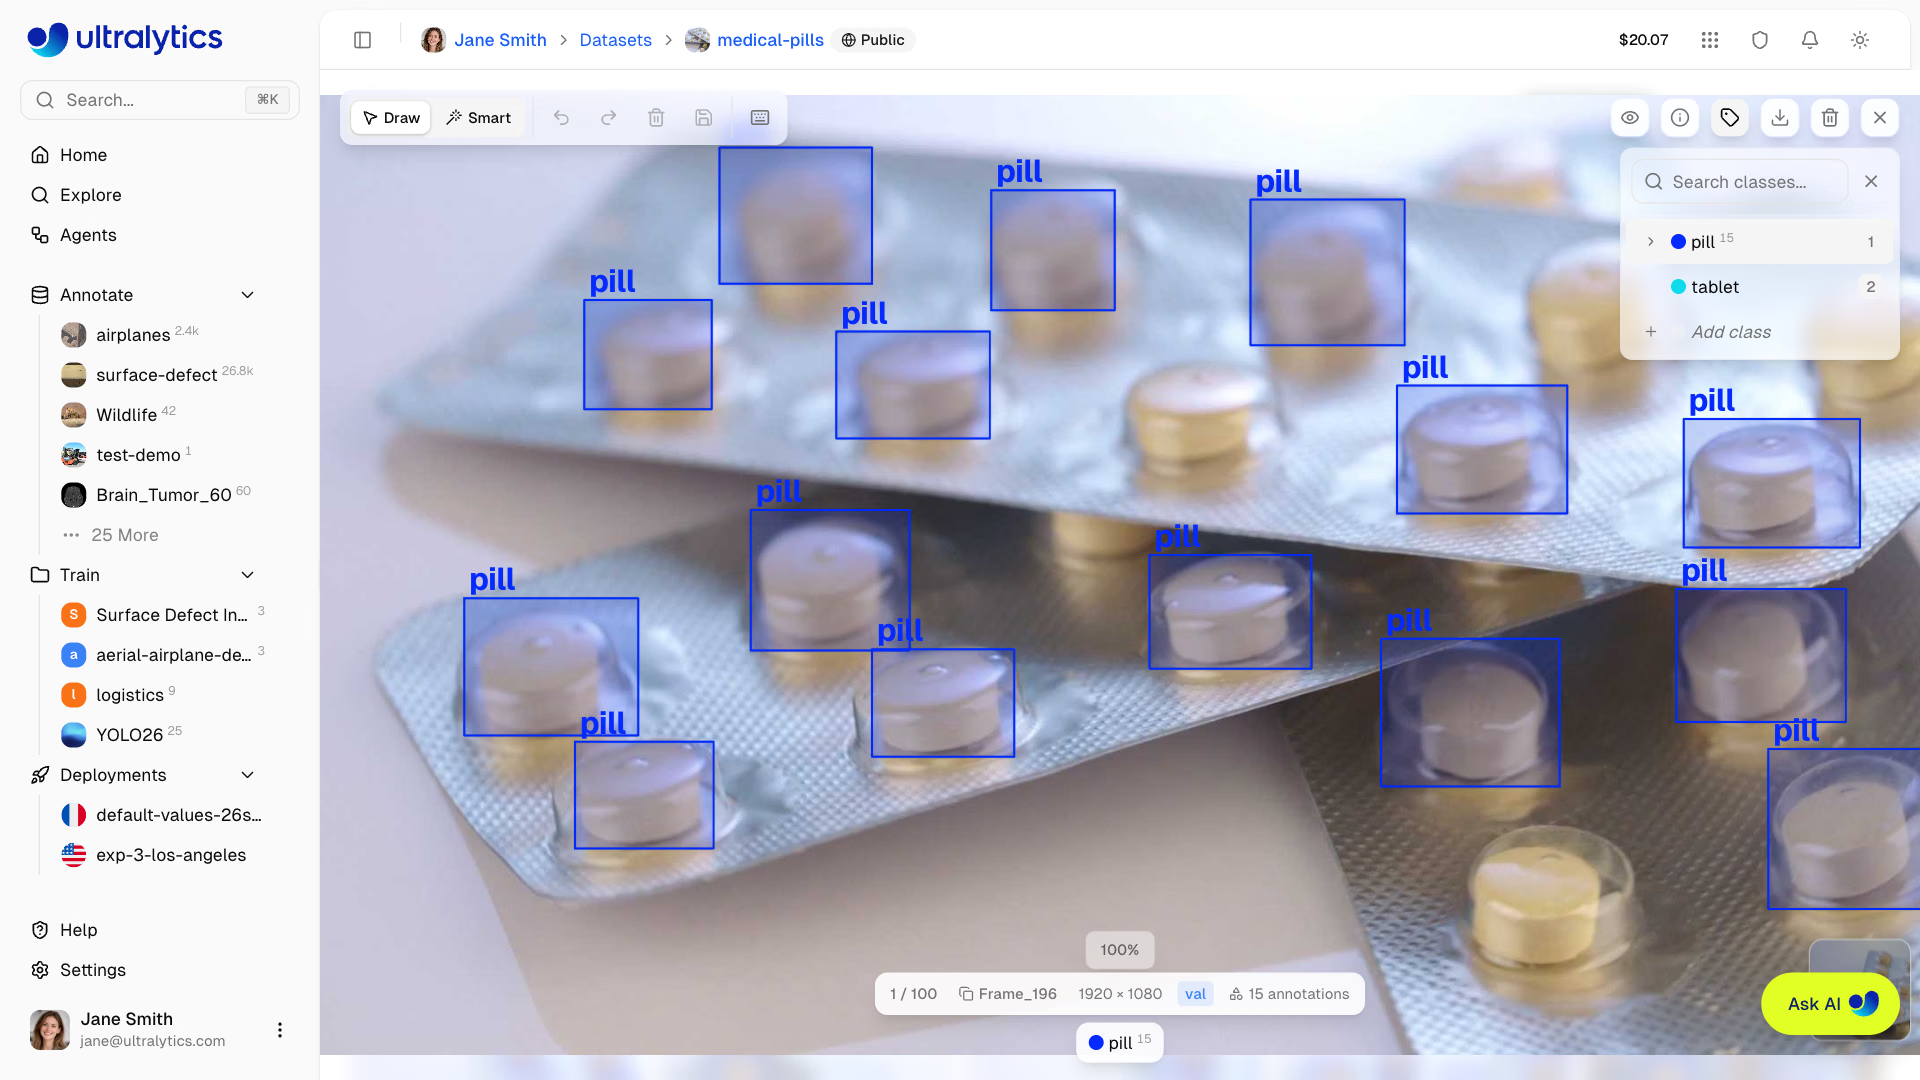
| العائلة | آلية العمل | المهام | التكلفة |
|---|---|---|---|
| SAM (SAM 2.1 من Tiny إلى Large، وSAM 3، وSAM 3.1 افتراضيًا) | انقر على عنصر لإنشاء قناع؛ وانقر خارجه للإضافة، أو داخله للطرح؛ ويتحكم A في التفعيل التلقائي | الكشف، والتجزئة، والدلالي، وOBB | Free |
| YOLO (النماذج الرسمية أو نماذجك الخاصة) | يضيف Predict اكتشافات النموذج؛ وتُحاذي Map classes بين فئات النموذج وفئات مجموعة البيانات؛ ويُتجاوز التكرار عند IoU 0.7 فأعلى | الكشف، والتجزئة، والدلالي، وOBB، وتقدير الوضعية | مجانًا في المحرر |
| النماذج المعتمدة على الفئات (Moondream 3.1 افتراضيًا، وYOLOE-26x، وSAM 3 Text، وغيرها) | يعثر على أسماء فئات مجموعة البيانات في الصورة؛ وتعمل نماذج المزوّدين المدفوعة باستخدام مفتاح API الخاص بك | مجموعات بيانات الكشف التي تضم من 1 إلى 200 فئة | النماذج المستضافة مجانية |
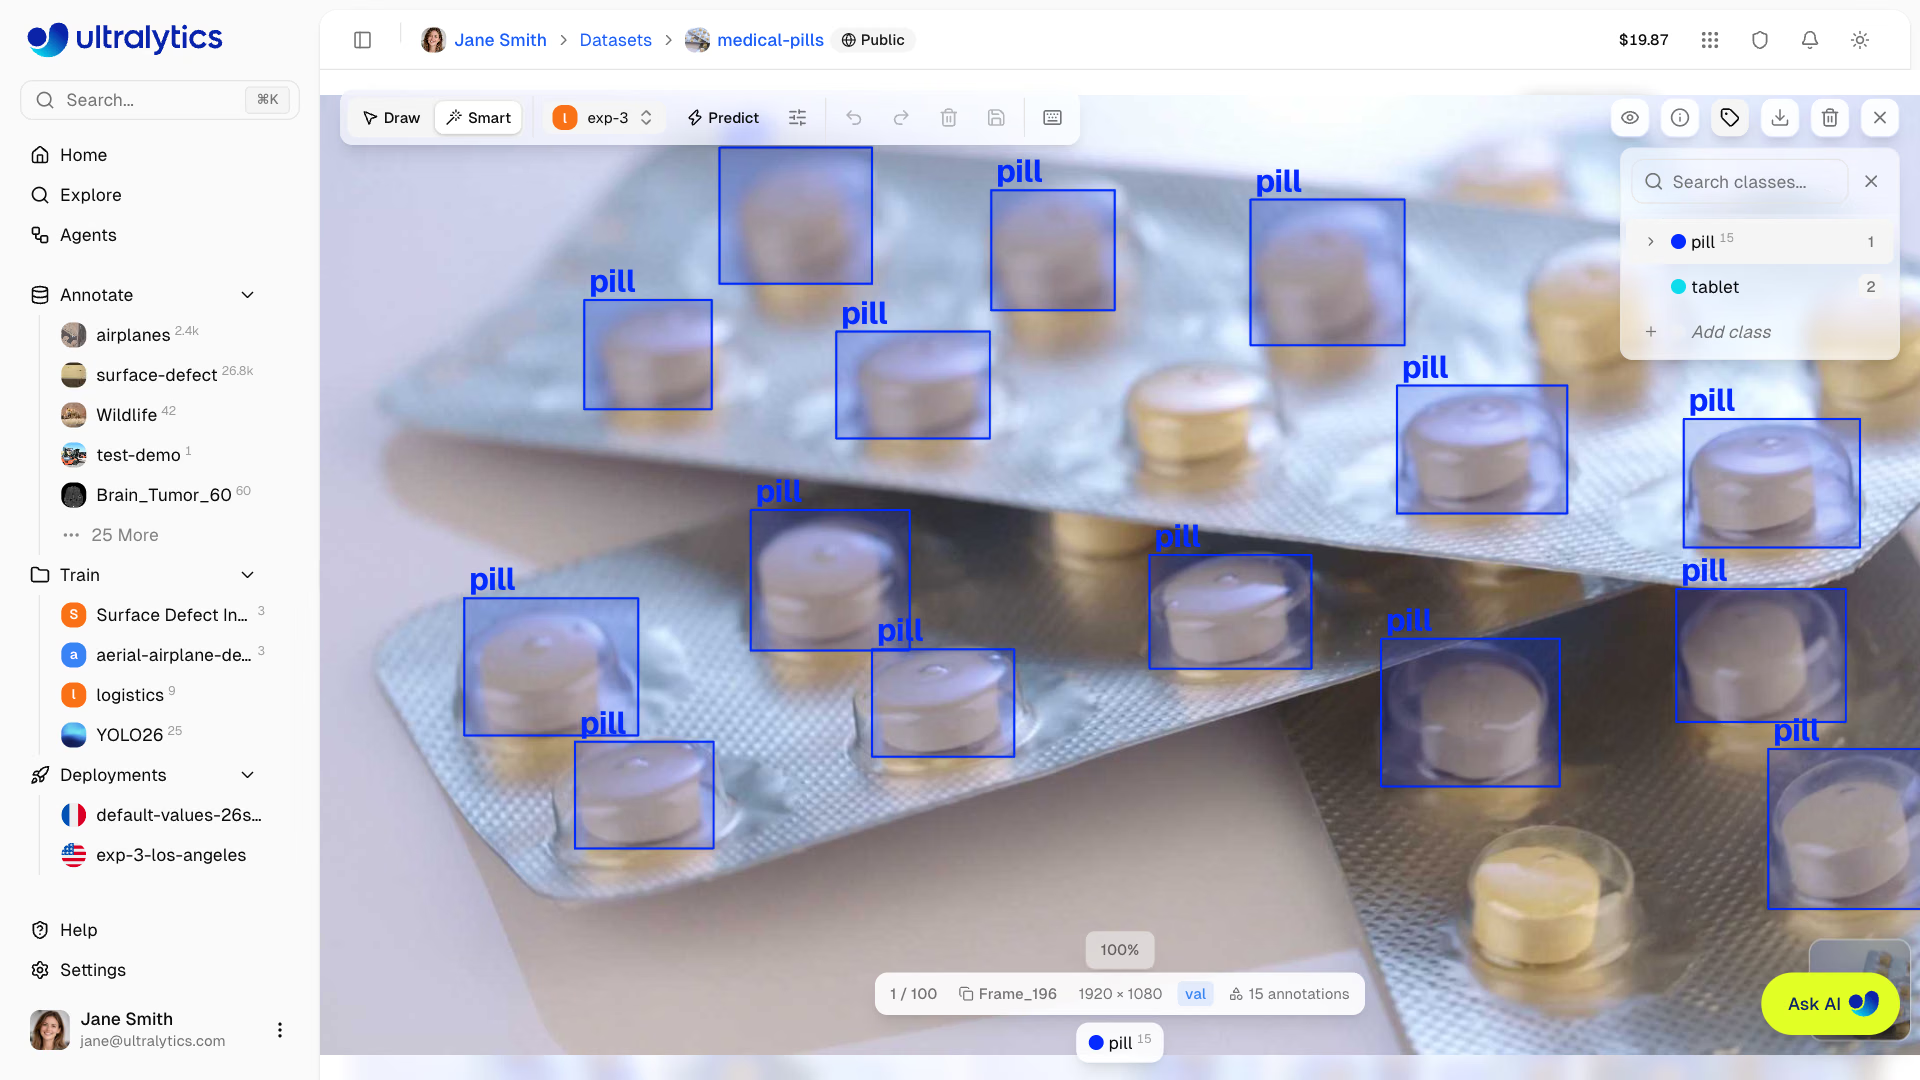
يتطلب SAM نقرة لكل عنصر ويعطي أدق الأشكال. أما توقعات النموذج فتتطلب نقرة واحدة لكل صورة، وتعتمد جودتها على النموذج؛ لذا يركز بقية هذا الدرس على اختيار النموذج وضبطه.
اختر نموذج إسناد التسميات#
يتفوق نموذج v0 ضعيف، دُرّب على 100–200 تسمية يدوية، على البدء من الصفر بالرسم، وبحلول v1 يكون عادةً شريكًا مفيدًا في التعلم النشط. يختلف أداء النماذج المعتمدة على الفئات كثيرًا باختلاف المجال: فبعضها يعثر على كل شيء تقريبًا في الصور اليومية، لكنه يفوّت معظم العناصر في صور لوحات الدارات المطبوعة أو الأشعة السينية أو البيع بالتجزئة؛ لذا افحص عشرة توقعات قبل الوثوق بأحدها.
مثال تطبيقي: قياس عمل المراجعة عند كل حدّ#
يحدد حدّ الثقة المهام التي يقضي المراجعون وقتهم فيها: إذا كان منخفضًا جدًا، حذفوا الصناديق الإيجابية الكاذبة؛ وإذا كان مرتفعًا جدًا، رسموا الصناديق التي أغفلها النموذج. قِس ذلك على صور تحمل تسميات صحيحة بالفعل؛ وفي هذا المثال نستخدم الصور الـ128 التي تحمل تسميات من COCO128، مع YOLO26n مُدرّب مسبقًا بوصفه نموذج إسناد التسميات:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5آلية العمل وما توضحه النتائج:
- يُجري النموذج التوقع مرة واحدة عند قيمة منخفضة لـ
conf=0.05؛ ثم يرشّح كل حدّ التوقعات نفسها، لذا يكون الاختبار سريعًا. - يطابق
review_workكل توقع مع صندوق الحقيقة الأساسية من الفئة نفسها عند IoU يبلغ 0.5 أو أكثر. التوقعات غير المطابقة هي صناديق يحذفها المراجع؛ والعناصر غير المطابقة في الحقيقة الأساسية هي عناصر يرسمها المراجع. - يصل عدد التعديلات لكل صورة إلى أدنى مستوى له عند 0.25–0.4 (4.7). ودون هذا النطاق، تتزايد عمليات الحذف بشدة؛ وفوقه، تكثر العناصر التي يفوتها النموذج.
- حتى عند أفضل حدّ، يرسم المراجعون نحو 3.6 صندوقًا لكل صورة، لأن ذيل COCO الطويل من العناصر الصغيرة يصعب على نموذج نانو اكتشافه.
قواعد اتخاذ القرار: اختر الحدّ الذي يحقق أقل عدد من التعديلات لكل صورة. إذا كانت عمليات الرسم هي الغالبة عند كل حدّ، فنموذج إسناد التسميات أضعف من أن يلائم البيانات؛ لذا استخدم نموذجًا أكبر أو نموذجك المحسّن بدقة. وإذا كانت عمليات الحذف هي الغالبة حتى عند 0.5، فالنموذج يخلط بين الفئات المتشابهة؛ لذا افحص مصفوفة الالتباس قبل إسناد مزيد من التسميات. في مشروعك، نفّذ الاختبار باستخدام نموذجك المحسّن بدقة على 50–100 صورة سبق أن وضعت لها تسميات.
شغّل التعليق التوضيحي على دفعات#
يشغّل التعليق التوضيحي على دفعات نموذج YOLO واحدًا أو نموذجًا معتمدًا على الفئات على مجموعة البيانات بأكملها. افتحه من المزيد من الإجراءات > التعليق التوضيحي على دفعات، أو اختر إضافة تسميات توضيحية إلى الكل في الإشعار المنبثق بعد إجراء توقع في المحرر:
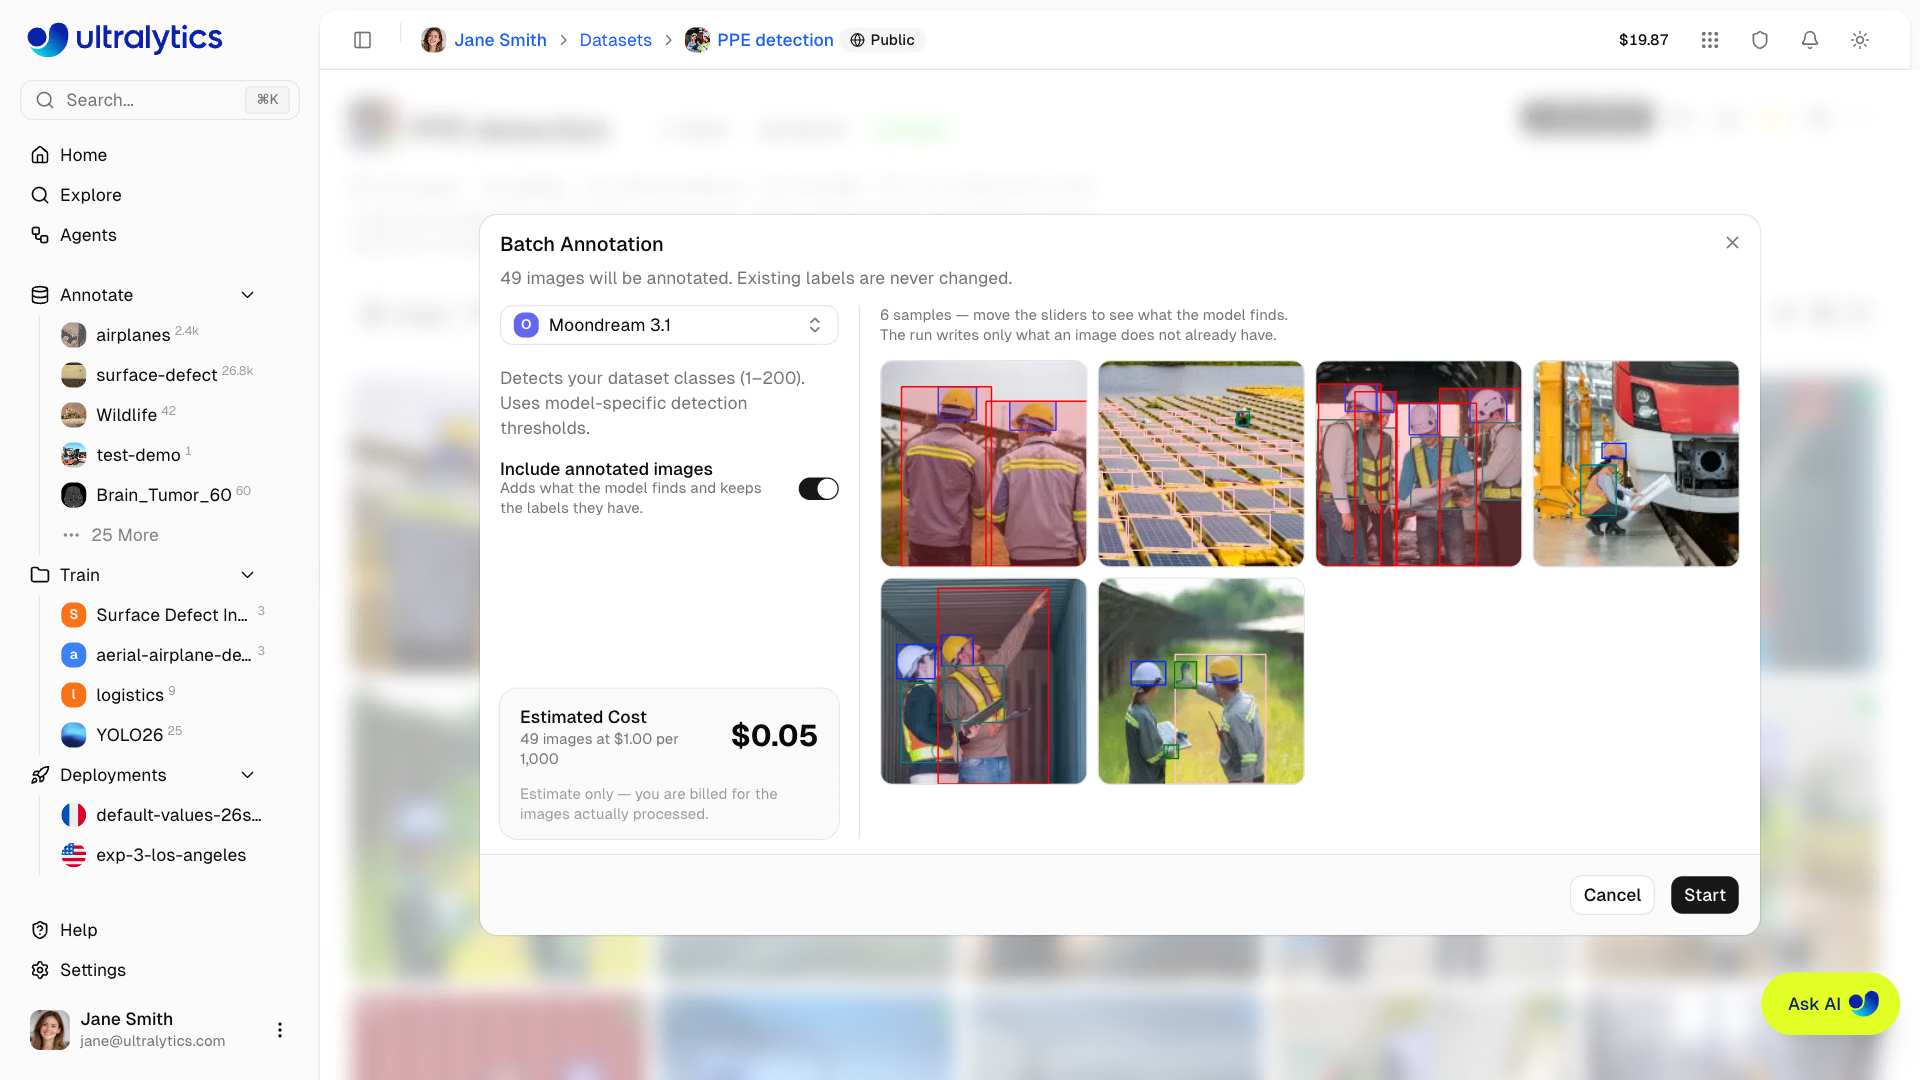
- اختر النموذج. تفتح مجموعات بيانات الكشف مع تحديد Moondream 3.1؛ بدّله بنموذجك المحسّن بدقة أو نموذج YOLO.
- لنموذج YOLO، عيّن قيمة الثقة إلى الحدّ الذي اخترته في الاختبار (الافتراضي هو
0.25) وقيمة IoU (0.7)، ثم افحص معاينات العينات. - اترك Include annotated images غير مفعّل لإسناد التسميات إلى الصور التي لا تحمل تسميات فقط.
- تحقق من التكلفة المقدّرة (1.00 دولار لكل 1,000 صورة، بحد أدنى 0.01 دولار)، ثم انقر على Start.
يؤدي بدء التشغيل إلى حفظ إصدار من مجموعة البيانات أولًا، لتتمكن من استعادة الحالة السابقة للتشغيل. ويحتفظ Stop بالصور التي عولجت حتى ذلك الوقت، وتُحتسب تكلفتها.
راجع النتائج، ثم قِس معدل التعديلات#
تُضاف التوقعات باعتبارها تعليقات توضيحية عادية، لذا لا توجد علامة تشير إلى أنها لم تُراجع. رشّح النتائج حسب الفئة للتحقق من الفئات النادرة أولًا، ورتّب حسب التعليقات التوضيحية تصاعديًا (لاحتمال وجود عناصر فائتة) وتنازليًا (للمشاهد المزدحمة التي قد تندمج فيها الصناديق). ثم أنشئ إصدارًا، وافتح مقارنة الإصدارات في علامة التبويب Versions، واختر v_auto بوصفه إصدار From:
| العدد | المعنى |
|---|---|
| المضافة | العناصر التي أغفلها النموذج، مضافًا إليها النسخة المصححة من كل صندوق جرى إصلاحه |
| المحذوفة | الإيجابيات الكاذبة، مضافًا إليها النسخة الأصلية من كل صندوق جرى إصلاحه |
| معدل التعديلات | (المضاف + المحذوف) ÷ التعليقات التوضيحية في v_auto؛ وهو حد أعلى لأن الصندوق المصحح يُحتسب مرتين |
تابع معدل التعديلات لكل دفعة. فارتفاع المعدل إنذار مبكر بأن الصور الجديدة قد ابتعدت عن نطاق ما يعرفه نموذج إسناد التسميات. ويتناول درس أفضل ممارسات التعليق التوضيحي أدلة إسناد التسميات وتوافق المراجعين.
مواطن الخلل#
العَرَض: تحقق كل إعادة تدريب الدرجة نفسها تقريبًا، وتُفوَّت الأجسام نفسها دائمًا. الحل: يؤدي اعتماد التسميات الأولية غير المراجعة إلى ترسيخ الأخطاء المنهجية لنموذج وضع التسميات في مجموعة البيانات بوصفها حقائق: فئة شبيهة، أو حافة صندوق فضفاضة باستمرار، أو أجسام لا يكشفها مطلقًا. راجع كل صورة قبل إدراجها في إصدار تدريبي.
العَرَض: يكتمل التعليق التوضيحي الدفعي، وتظل معظم الأجسام بلا تسميات. الحل: شغّل النموذج في المحرر على عشر صور تمثيلية أولًا. وإذا أخفق في اكتشاف أكثر من بضعة أجسام، فأنشئ مجموعة أولية بالتوسيم اليدوي ودرّب إصدار v0 بدلًا من ذلك.
العَرَض: تحمل الصناديق المتوقعة أسماء الفئات الخاطئة. الحل: عندما تختلف فئات النموذج عن فئات مجموعة البيانات، تربط خطوة Map classes كل فئة في النموذج بفئة في مجموعة البيانات أو تتجاوزها. أجرِ الربط بعناية؛ فالربط الخاطئ يعيد تسمية كل صندوق من تلك الفئة.
عرض الحل
مثال تطبيقي: يختار المسح القيمة 0.35 لضبط دقيق لفحص الحبوب. يحفظ Batch Annotation الإصدار v4 الذي يحتوي على 1,240 تعليقًا توضيحيًا. بعد المراجعة، يعرض Compare versions v4 → v5 إضافة 96 تعليقًا وإزالة 152، لذا يكون معدل التعديل (96 + 152) ÷ 1,240 = 20%. تجاوز عدد العناصر المحذوفة عدد العناصر المضافة، ما يشير إلى الإفراط في التنبؤ: ويُظهر فحص المربعات المحذوفة أن النموذج يضع علامات على انعكاسات الضوء في عبوات الأقراص على أنها حبوب. وينتج عن ذلك إجراءان: ارفع مستوى الثقة خطوة واحدة (0.35 → 0.45) للدفعة التالية وتأكد من انخفاض المعدل، وأضف 30 صورة لعبوات لامعة تمت مراجعتها إلى إصدار التدريب التالي كي يتعلم الضبط الدقيق التمييز بينها.