تدريب عمليات التشغيل وقراءة نتائجها وضبطها الدقيق
ابدأ عملية تشغيل سحابية ضمن ميزانية محددة، وقيّم التشغيل من منحنياته لكل حقبة، وأجرِ الضبط الدقيق من دون أن يتجاهل المحسّن الافتراضي معدل التعلّم.
تُحاسبك وحدة GPU سحابية عن كل دقيقة يستمر فيها تشغيل محكوم عليه بالفشل، أما أكثر أخطاء الضبط الدقيق شيوعًا فلا يكلف شيئًا، لكنه يهدر وقت التشغيل بصمت: المحسّن الافتراضي يتجاهل معدل التعلّم الذي تحدده. يدرّب هذا الدرس نموذجًا حقيقيًا على مجموعة بيانات medical pills، ويقرأ منحنياته وفق قاعدة لاتخاذ القرار، ثم يجري ضبطًا دقيقًا يضمن تطبيق إعداداتك فعلًا.
عملي
بدء عملية تشغيل#
انقر New Model في صفحة مشروع أو مجموعة بيانات. ترشدك علامة التبويب Cloud Training خلال هذه الإعدادات:
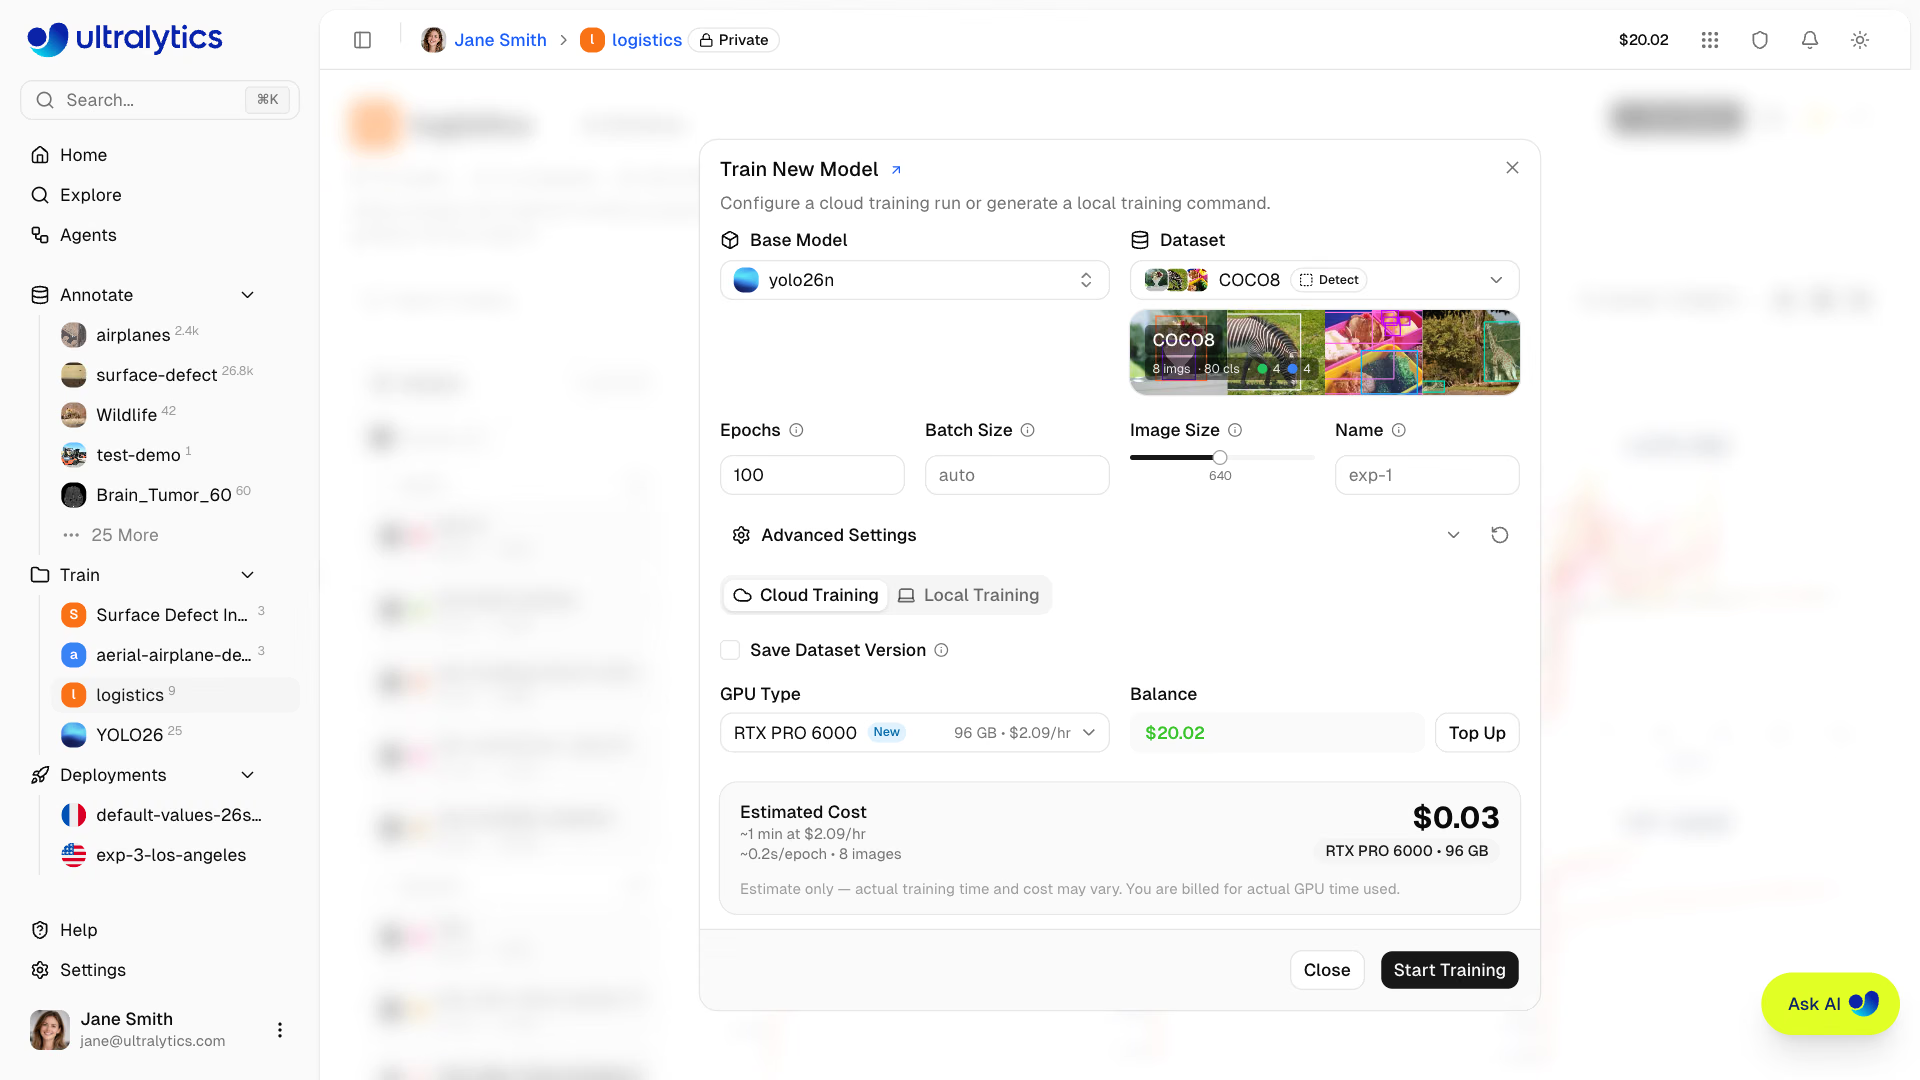
| الإعداد | افتراضي | متى تغيّره |
|---|---|---|
| النموذج الأساسي | اختر من Official (يُوصى بـ YOLO26) | لإجراء ضبط دقيق، اختر عملية التشغيل السابقة ضمن My Models |
| مجموعة البيانات | — | فعّل Save Dataset Version دائمًا لربط عملية التشغيل ببياناتها |
| الحقب | 100 | اختبار تشغيل (10–20 حقبة) أو مجموعات بيانات ضخمة جدًا |
| حجم الدفعة | -1 (يضبط نفسه تلقائيًا ليتوافق مع ذاكرة GPU) | تحتاج إلى عمليتي تشغيل لتكون المقارنة بينهما دقيقة تمامًا |
| حجم الصورة | 640 | الأجسام صغيرة: ارفع الحجم (يتوقف شريط التمرير عند 1280؛ ويقبل محرر YAML حتى 4096) |
| الإعدادات المتقدمة | الإعدادات الافتراضية | أكثر من 50 وسيطة model.train() في YAML، تشمل المحسّن ومعدل التعلّم وزيادة البيانات |
الوسيطات هي نفسها التي يقبلها model.train(...) محليًا، وتعرض صفحة النموذج لاحقًا أمر yolo train قابلًا للنسخ، مع القيم غير الافتراضية.
اختيار وحدة GPU وتحديد ميزانية التشغيل#
| الفئة | أمثلة (ذاكرة VRAM، السعر لكل ساعة) | مناسب لـ |
|---|---|---|
| اقتصادي | RTX 2000 Ada (16 GB، $0.24)، RTX A5000 (24 GB، $0.27)، RTX 4090 (24 GB، $0.69) | اختبارات التشغيل والنماذج النانوية والصغيرة |
| متوسط | L40S (48 GB، $0.86)، RTX 5090 (32 GB، $0.99)، A100 SXM (80 GB، $1.49) | النماذج المتوسطة وأحجام الدفعات الأكبر |
| افتراضي | RTX PRO 6000 (96 GB، $2.09) | معظم المهام |
| متقدم | H100 SXM (80 GB، $3.29)، H200 SXM (141 GB، $4.39) | مجموعات البيانات الكبيرة عندما يكون الوقت عاملًا مهمًا |
| Pro وEnterprise | B200 (180 GB، $5.89)، B300 (288 GB، $7.39) | أكبر المهام |
تقدّر بطاقة التكلفة المدة والسعر قبل البدء: نحو $0.23 مقابل 1,000 صورة × YOLO26n × 100 حقبة على RTX PRO 6000 الافتراضي، ونحو $1.56 مقابل 5,000 صورة × YOLO26s × 100 حقبة على H100 SXM، الذي يدرّب بسرعة تزيد بنحو 3.4× على RTX 4090. تُحتسب الفوترة وفق وقت GPU الفعلي: تُفرض رسوم على عمليات التشغيل المكتملة والملغاة والفاشلة بمجرد بدء GPU، ويحتاج التشغيل إلى رصيد يغطي تقديره (15 دقيقة على الأقل من وقت GPU)، كما تتوقف عمليات التشغيل النشطة إذا أصبح الرصيد سالبًا؛ لذا فعّل إعادة الشحن التلقائي في Settings > Billing للمهام الطويلة. قد يؤدي اختيار GPU أرخص من RTX PRO 6000 إلى ترقية مجانية إليه عندما تكون السعة التي تديرها Ultralytics خاملة، مع استمرار احتساب الفاتورة وفق السعر الذي اخترته.
قواعد اتخاذ القرار: اختبر مجموعة بيانات جديدة مبدئيًا باستخدام 10–20 حقبة على GPU الافتراضي. انتقل إلى H100 أو H200 عندما يستغرق التشغيل ساعات ويكون هناك من ينتظره. اختر GPU أرخص لا أسرع عندما يظل استخدام GPU منخفضًا.
راقب التشغيل#
تعرض علامة التبويب Train في صفحة النموذج ثلاثة علامات تبويب فرعية لبث البيانات. تعرض Charts المقاييس وخسائر التدريب والتحقق ومعدل التعلّم لكل حقبة؛ وتحتفظ Console بآخر 2,000 سطر وتوقف التشغيل فورًا عند ظهور تتبّع خطأ أو خطأ نفاد ذاكرة CUDA؛ أما System فتعرض استخدام GPU والذاكرة ودرجة الحرارة:

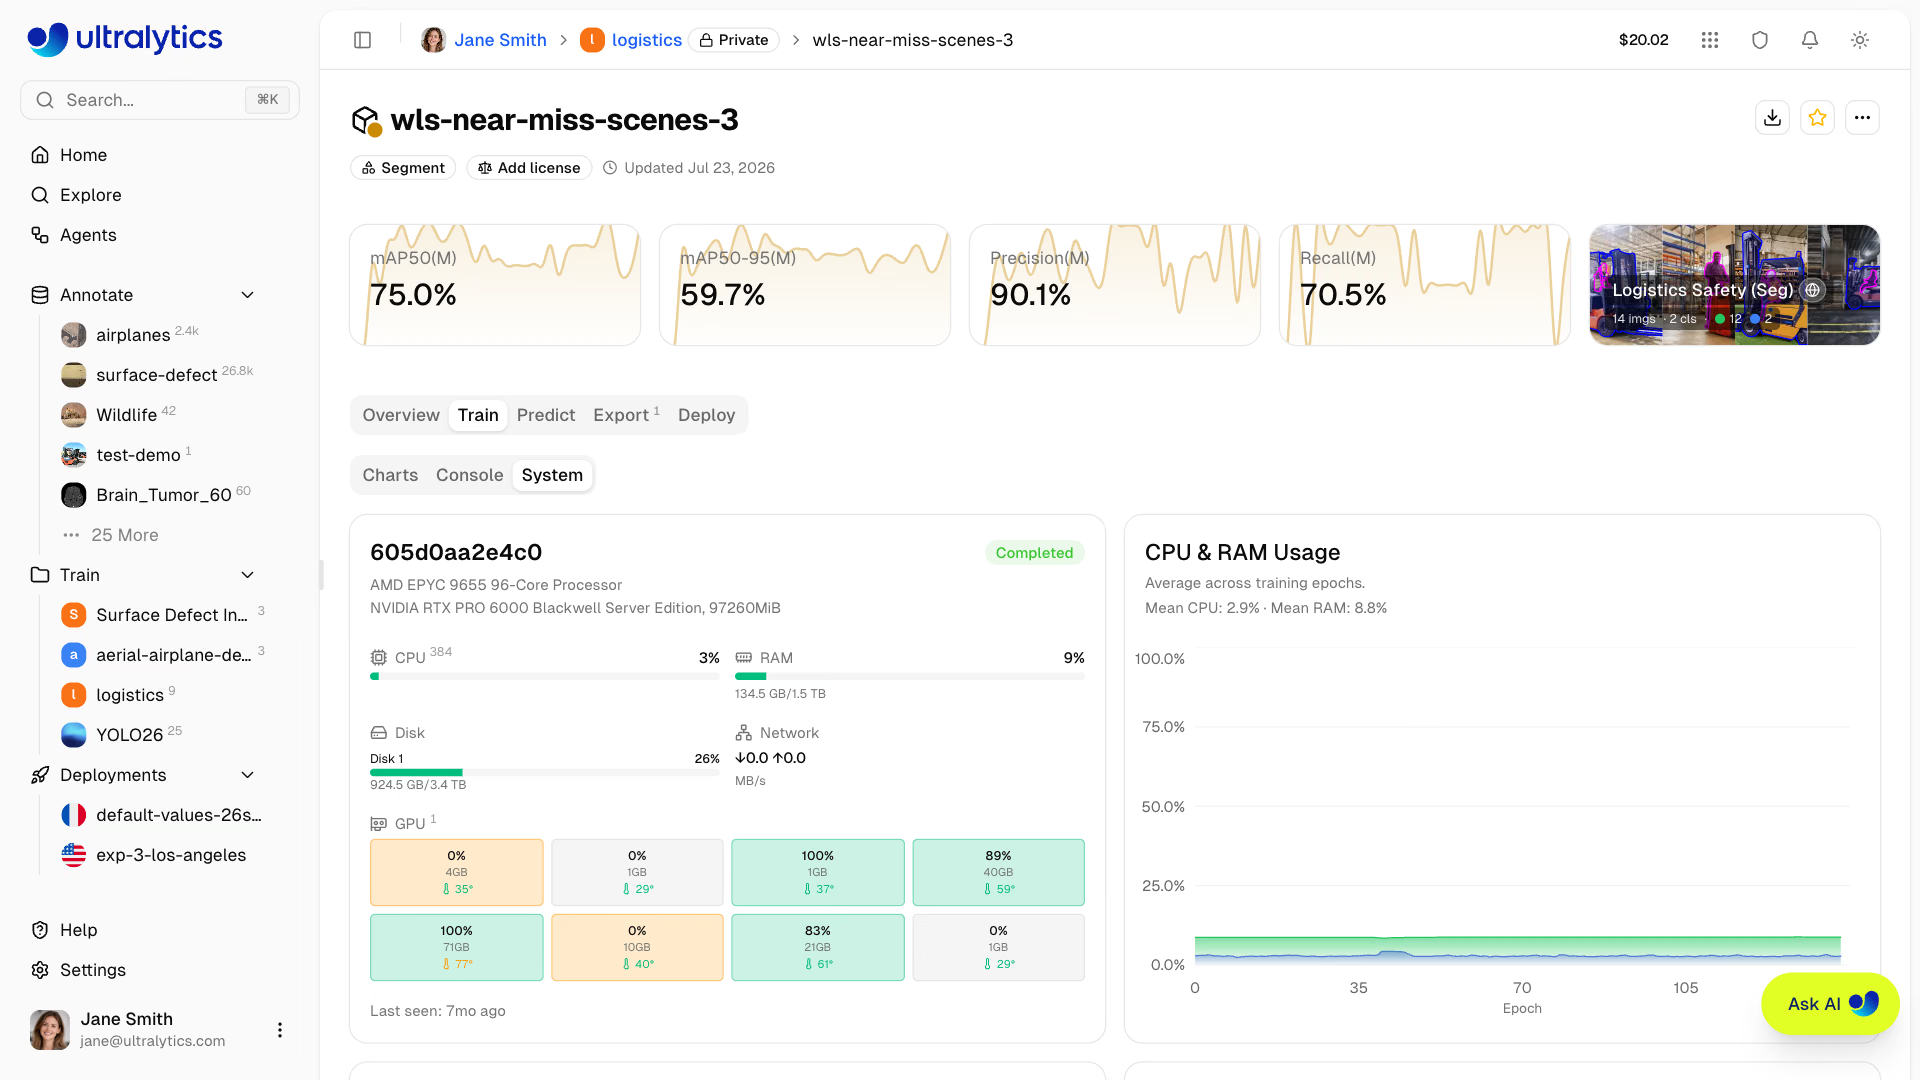
يُعلَّم التشغيل بالفشل إذا لم يُبلغ عن أي شيء لمدة 4 ساعات. تُرفع أفضل نقطة تحقق دوريًا، لذا يحتفظ التشغيل الملغى بأفضل حقبة وصل إليها حتى ذلك الحين، ويمكن أن تخبرك تنبيهات Slack عند اكتمال عمليات التشغيل أو فشلها.
مثال عملي: تدريب تشغيل وبثه وقراءته#
يمكنك التدريب في أي مكان مع الاستمرار في تتبّع التشغيل في Platform. بعد تصدير مفتاح API من Settings > API Keys بوصفه ULTRALYTICS_API_KEY، يبث project بالشكل username/project المخططات ووحدة التحكم وأفضل نقطة تحقق إلى ذلك المشروع:
from ultralytics import YOLO

# export ULTRALYTICS_API_KEY="..." first to stream this run into your Platform project
model = YOLO("yolo26n.pt")
results = model.train(data="medical-pills.yaml", epochs=10, imgsz=320, project="username/pill-inspection", name="v1-baseline")
print(f"mAP50-95 {results.box.map:.3f}, best checkpoint: {model.trainer.best}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 23 399 0.97 0.957 0.977 0.659
mAP50-95 0.659, best checkpoint: .../runs/detect/username/pill-inspection/v1-baseline/weights/best.ptيعمل الأمر نفسه على وحدات GPU في Platform عند النقر على New Model؛ أما محليًا، فقد استغرق أقل من دقيقتين على CPU محمول باستخدام imgsz=320. يحتوي results.csv الخاص بالتشغيل على السلاسل الزمنية لكل حقبة التي تعرضها علامة التبويب الفرعية Charts، لذا تحوّل بضعة أسطر عبارة "راقب المنحنيات" إلى قاعدة:
import pandas as pd

df = pd.read_csv("results.csv")  # the per-epoch metrics behind the Charts subtab
df.columns = df.columns.str.strip()
m = df["metrics/mAP50-95(B)"]
best_epoch = int(df.loc[m.idxmax(), "epoch"])
recent_gain = m.iloc[-1] - m.iloc[-4]  # change over the last 3 epochs
val_loss = df["val/box_loss"]
print(f"epochs={len(df)} best mAP50-95={m.max():.3f} at epoch {best_epoch}")
print(f"gain over last 3 epochs: {recent_gain:+.3f}")
print(f"val box loss: {val_loss.iloc[0]:.3f} -> {val_loss.iloc[-1]:.3f}")
if recent_gain < 0.005 and val_loss.iloc[-1] >= val_loss.iloc[-4]:
    print("verdict: plateaued - stop, and fix the data before training longer")
elif best_epoch == len(df):
    print("verdict: still improving at the last epoch - more epochs should help")
else:
    print("verdict: converged - keep best.pt")
epochs=10 best mAP50-95=0.659 at epoch 10
gain over last 3 epochs: +0.028
val box loss: 1.367 -> 1.045
verdict: still improving at the last epoch - more epochs should helpأفضل حقبة هي الأخيرة، وارتفع mAP50-95 بمقدار 2.8 نقطة خلال الحقبات الثلاث الأخيرة، وما زالت خسارة التحقق تنخفض: توقف هذا التشغيل بعد 10 حقبات مبكرًا، وسيفيد تشغيل أطول أو ضبط دقيق. استخدم الإشارات الثلاث نفسها في علامة التبويب الفرعية Charts لأي تشغيل على Platform: موضع أفضل حقبة، ومقدار التحسن الأخير، واتجاه خسارة التحقق.
اضبط النموذج بدقة انطلاقًا من نموذج سابق#
اختر نموذجك السابق ضمن My Models ليكون النموذج الأساسي؛ فتنشئ Platform نموذجًا جديدًا يبدأ من نقطة التحقق هذه وتُبقي النموذج القديم دون تغيير. تنصح التوصية المعتادة باستخدام معدل تعلّم أقل، لكن التدريب باستخدام optimizer: auto الافتراضي يختار المحسّن ومعدل التعلّم بنفسه ويتجاهل lr0. وتوضح وحدة التحكم ذلك في الأسطر الأولى:
optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and determining best 'optimizer' and 'lr0' automatically...
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 114 weight(decay=0.0), 126 weight(decay=0.0005), 126 bias(decay=0.0)
عيّن optimizer صراحةً في Advanced Settings ليُعتمد هذا الإعداد. يسجل الضبط الدقيق لنموذج الحبوب لمدة 5 حقبات إضافية باستخدام optimizer: SGD وlr0: 0.001 ما يلي:
optimizer: SGD(lr=0.001, momentum=0.937) with parameter groups 114 weight(decay=0.0), 126 weight(decay=0.0005), 126 bias(decay=0.0)
                   all         23        399      0.969      0.962      0.983      0.687
ارتفع mAP50-95 من 0.659 إلى 0.687. ستُخضع هذا النموذج المرشح لبوابة ترقية في الدرس التالي.
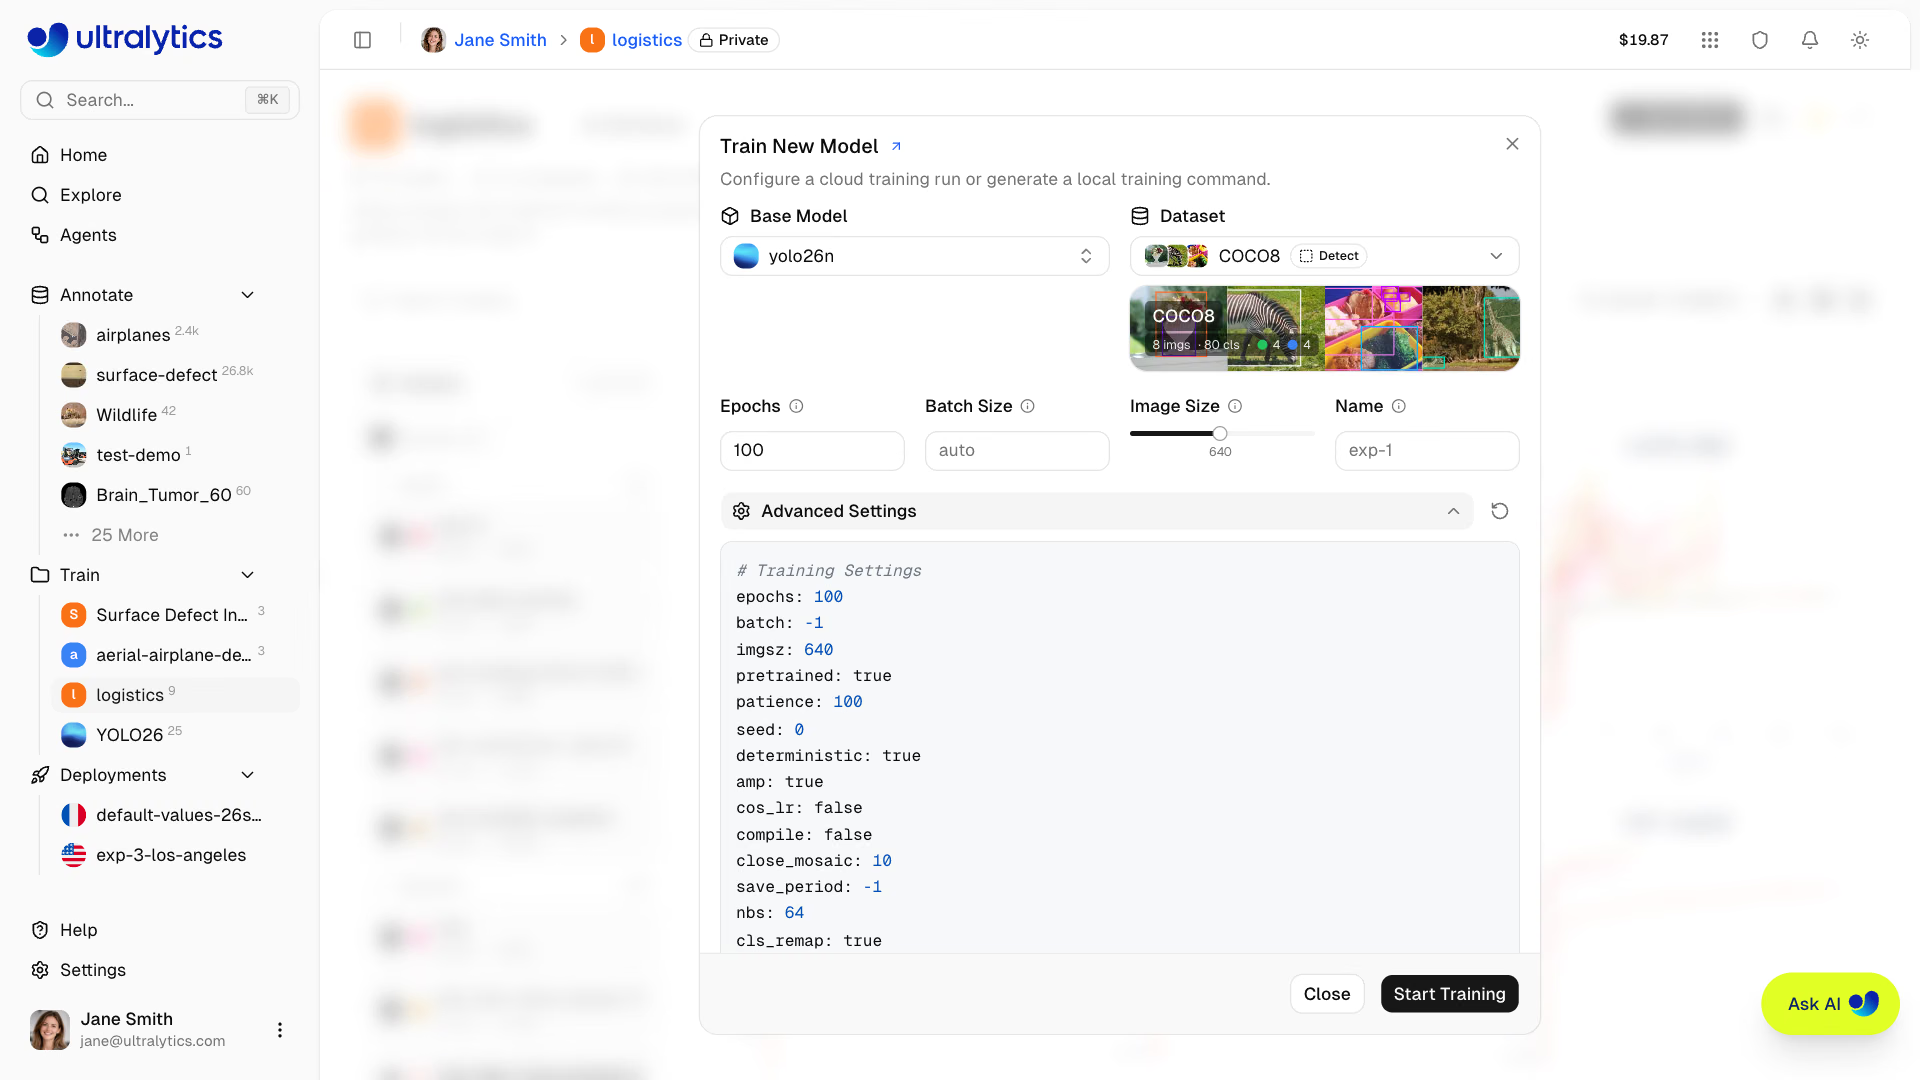
لإعادة تشغيل سابق، افتح جدول Training Configuration في صفحة النموذج، واختر Copy JSON، ثم الصقه في Advanced Settings. يتناول دليل الضبط الدقيق تجميد الطبقات، ويتناول دليل ضبط المعلمات الفائقة عمليات المسح المنهجية.
مواطن الخلل#
العَرَض: تضبط lr0: 0.001، وتعرض وحدة التحكم ignoring 'lr0=...'. الحل: مع optimizer: auto، يختار التدريب المحسِّن ومعدل التعلّم بنفسه. اضبط optimizer على SGD أو AdamW إلى جانب lr0، ثم تحقّق من سطر optimizer: في وحدة التحكم.
العَرَض: تعرض علامة التبويب الفرعية System استغلالًا لوحدة GPU أقل بكثير من 80% طوال مدة التشغيل. الحل: عنق الزجاجة هو تحميل البيانات، لا وحدة GPU، لذا لن يؤدي استخدام وحدة GPU أسرع إلا إلى زيادة التكلفة. اختر وحدة GPU أرخص، أو زِد حجم الدفعة إذا كانت الذاكرة تسمح بذلك.
العَرَض: بقيت قيمة mAP50-95 للتحقق ثابتة طوال 10 عصور، بينما أخذت خسارة التحقق ترتفع تدريجيًا. الحل: ألغِ التدريب. ستُحفظ أفضل نقطة تحقق حتى الآن، وسيأتي التحسن التالي من البيانات (الدرسان 3 و4)، لا من زيادة عدد العصور.
عرض الحل
الإجابة العملية على نموذج الحبوب الطبية: يبلغ خط الأساس، الذي استمر 10 حقبات، ذروته عند الحقبة 10 مع mAP50-95 يبلغ 0.659، بزيادة قدرها +0.028 خلال الحقبات الثلاث الأخيرة، بينما انخفضت خسارة مربعات التحقق من 1.367 إلى 1.045؛ لذا فالقرار هو «المتابعة». بدلًا من إعادة التدريب من الصفر، أجرِ ضبطًا دقيقًا: النموذج الأساسي v1-baseline ضمن My Models، و5 حقبات، وإعدادا Advanced Settings optimizer: SGD وlr0: 0.001. تؤكد وحدة التحكم SGD(lr=0.001, momentum=0.937)، ويصل mAP50-95 إلى 0.687. تبلغ التكلفة على GPU الافتراضي بضعة سنتات؛ وتعرض بطاقة التكلفة التقدير قبل النقر على Start Training، فيما يعرض Settings > Billing الرسوم الفعلية بعد ذلك.