قارن عمليات التشغيل واختر الأفضل
قارن عمليات التشغيل في مشروع على Platform، وسجّل سبب وجود كل تشغيل، وحدد ما إذا كان النموذج المرشح سيُطلق باستخدام بوابة ترقية مبرمجة.
عادةً ما تتفوق النماذج الأكبر في المقياس الرئيسي، ثم تخفق في فئة لم يتحقق منها أحد. ومن دون قاعدة مقررة مسبقًا، يكون التشغيل الذي يُطلق هو ما يفضله أحدهم أكثر من غيره. يسجل هذا الدرس كل تشغيل لتسهيل العثور على مبرراته لاحقًا، ويحوّل سؤال «هل هو أفضل؟» إلى نص بوابة يعيد PASS أو FAIL.
عملي
قارن عمليات التشغيل في مشروع#
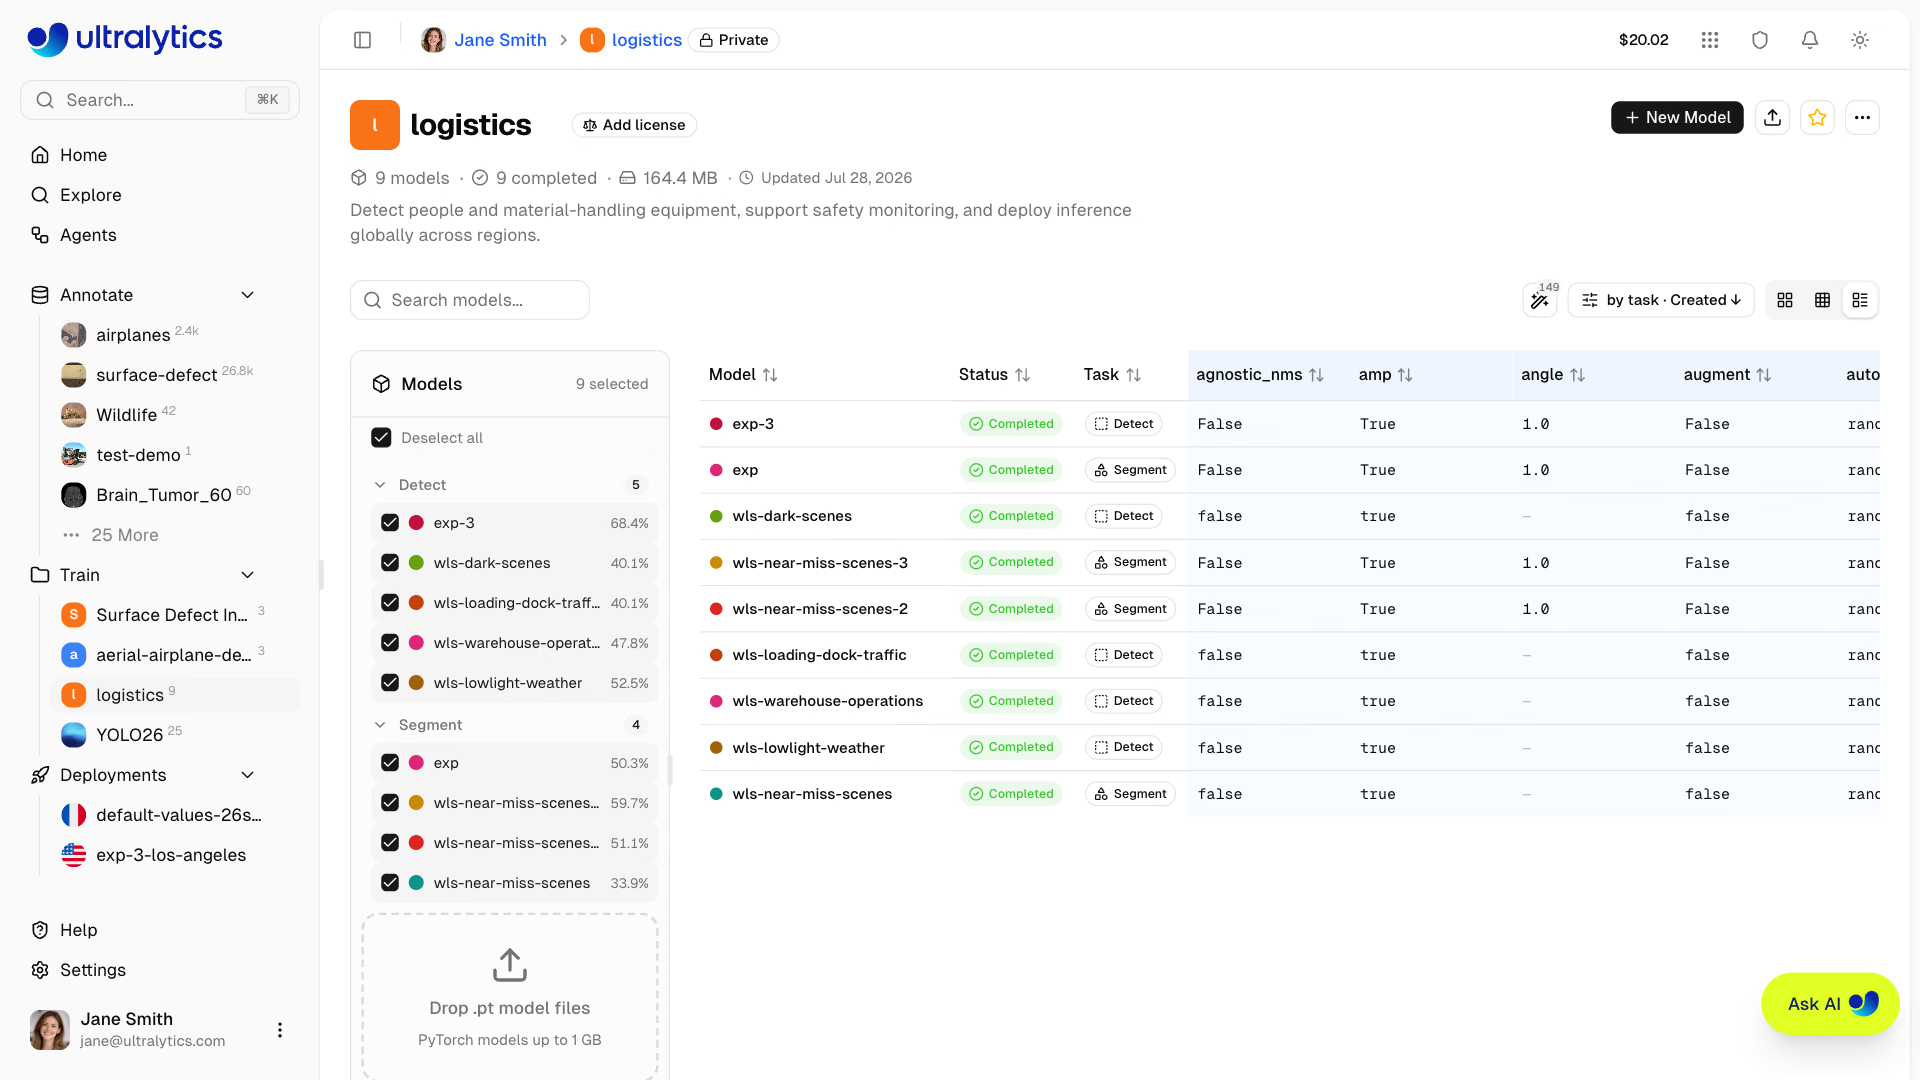
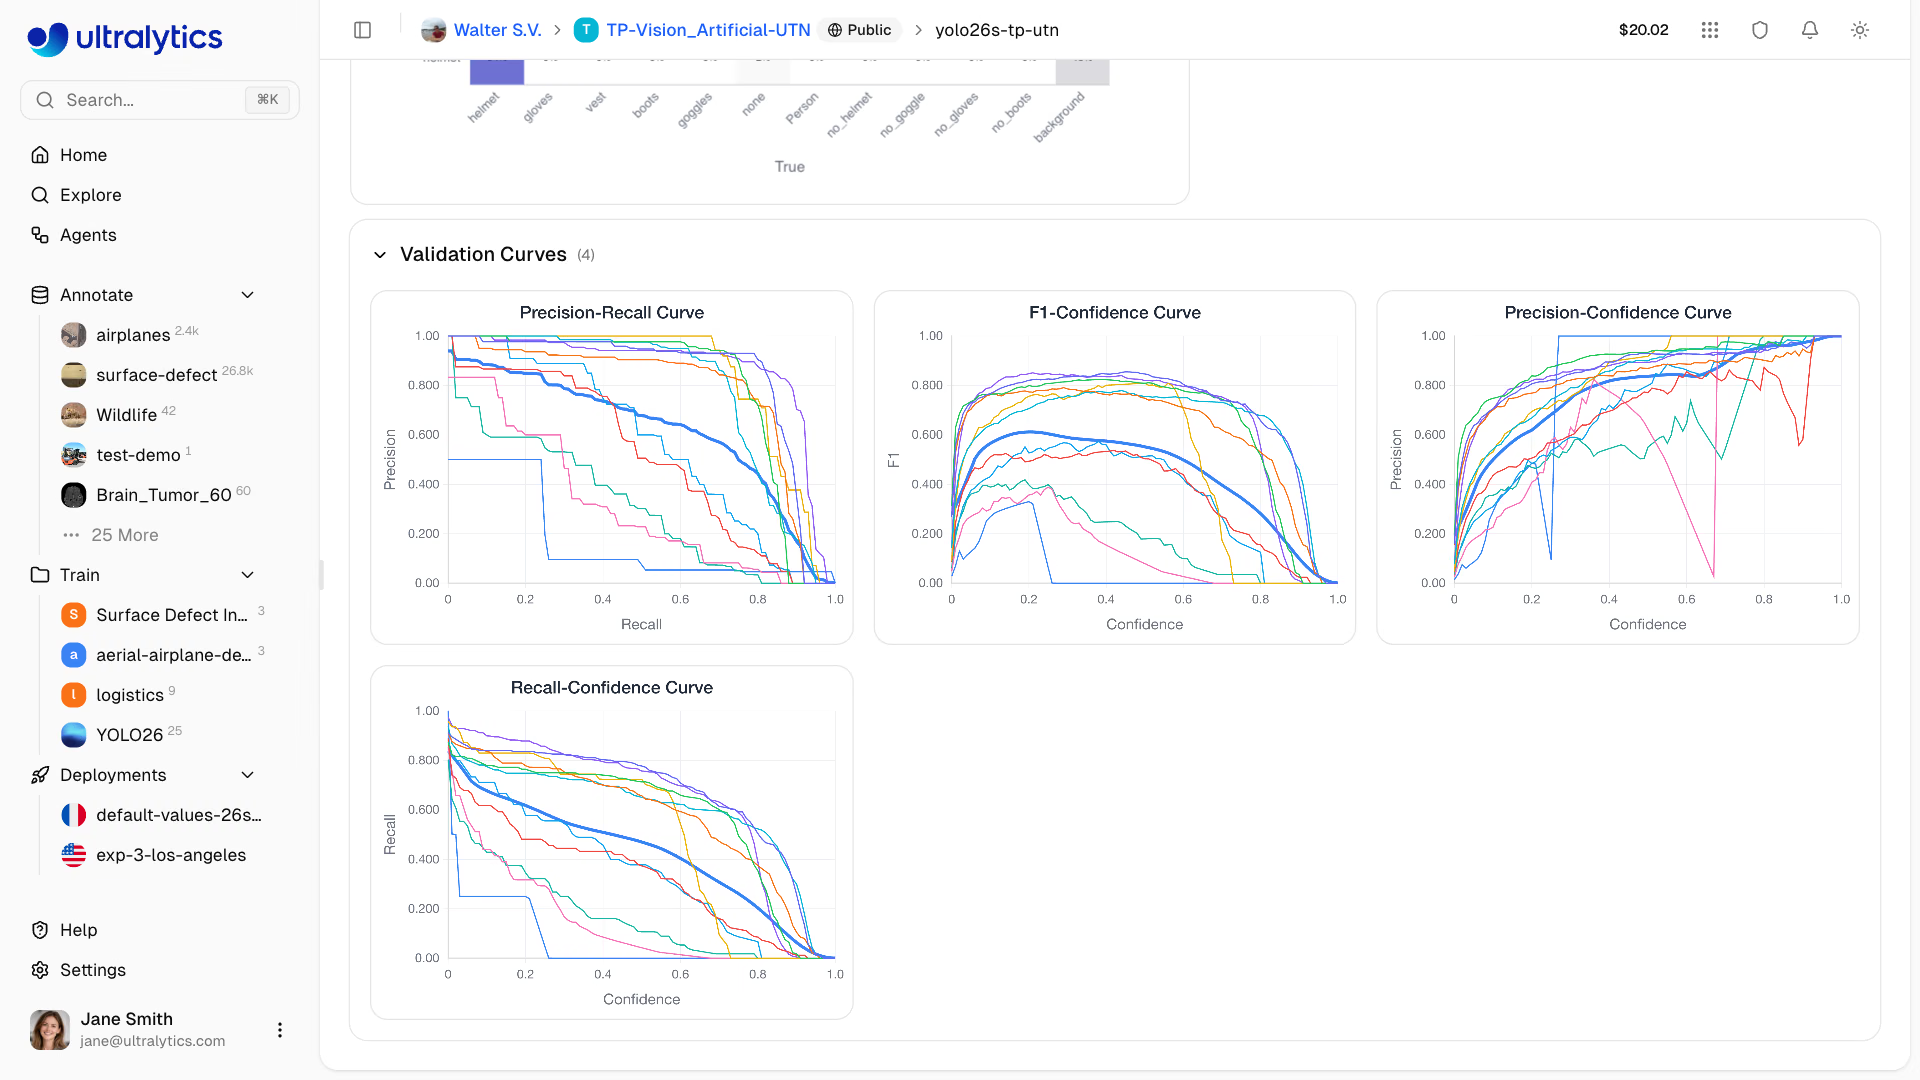
يعرض المشروع نماذجه مع مربعات اختيار. تظهر النماذج المحددة معًا في لوحة Charts؛ ويرتب عرض Table وسيطات التدريب والمقاييس النهائية جنبًا إلى جنب، بينما يخفي Diff الأعمدة المتطابقة لتلاحظ سريعًا أن عمليتي تشغيل تختلفان فقط في imgsz. تجري المقارنة داخل مشروع واحد، لذا اجمع التجارب المرتبطة معًا (يمكن قص النماذج ولصقها بين المشاريع). عند قراءة المنحنيات، قارن القيمة النهائية، وسرعة وصول كل تشغيل إليها، ومدى سلاسة ذلك.

عند وجود نموذجين مكتملين أو أكثر، يطلب Compare with AI من Ask AI تلخيص الاختلافات واقتراح التجربة التالية. تعامل مع الاقتراح باعتباره فرضية لتشغيلك التالي، لا حكمًا نهائيًا.
اجعل كل تشغيل قابلًا للتفسير#
تحمل الأسماء دلالتها: run_5 لا يعني شيئًا، بينما يوضح v3_pallets_added وv4_imgsz1024 إصدار مجموعة البيانات وما تغيّر. لتوثيق المبررات، افتح More actions > Information في صفحة النموذج واحفظ ملاحظة JSON ضمن Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
تسجل Platform بقية التفاصيل: تعرض بطاقة Run Information وحدة GPU ومعدل الساعة والتكلفة الإجمالية وإصدار ultralytics والمضيف والنموذج الأصل وإصدار مجموعة البيانات المثبّت وإيداع Git عند توفره، إضافةً إلى أمر yolo train القابل للنسخ. لا تكون المقارنة منصفة إلا بين عمليات التشغيل على إصدار مجموعة البيانات نفسه، ولذلك ينبغي تثبيت إصدار لكل تشغيل.
اختر المقياس والبوابات قبل الاطلاع على النتائج#
| المقياس | متى يكون الخيار المناسب |
|---|---|
| mAP50-95 | الخيار الافتراضي لمهام detect وsegment وpose وOBB: يكافئ دقة إحكام المربعات، وهو مستقر بما يكفي للمقارنة |
| mAP50 | الأجسام الكبيرة والمتباعدة بوضوح، حيث لا تهم دقة إحكام المربع كثيرًا |
| AP لكل فئة على حدة | عندما تحدد فئة واحدة القيمة التجارية |
| الاسترجاع عند دقة ثابتة | أنظمة السلامة والإنذار |
| زمن استدلال النموذج المستهدف | دائمًا، بوصفه حدًا صارمًا |
يشرح دليل مقاييس أداء YOLO كل مقياس. لا يُطلق النموذج المرشح إلا إذا اجتاز جميع البوابات:
مثال عملي: نص بوابة للترقية#
نزّل ملفات best.pt للنماذج المتأهلة، وقيّمها على البيانات نفسها باستخدام الشيفرة نفسها. يستخدم هذا المثال نقطتي تحقق رسميتين ليعمل في أي بيئة:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsما حدث: يتفوق النموذج الأكبر إجمالًا بمقدار 2.4 نقطة، لكنه يخسر أكثر من 10% من AP في فئتين، لذا يفشل. هذا هو التراجع الذي تخفيه المقارنة بالمقياس الرئيسي. يأتي قاموس الفئات من ap_class_index وap، وهما لا يغطيان سوى الفئات الموجودة في البيانات؛ ويُقاس زمن الاستجابة على الجهاز الذي يشغّل النص، لذا شغّل البوابة على جهاز يشبه عتاد النشر لديك. لا تضم COCO8 سوى 8 صور تحقق، وهي قليلة جدًا لاتخاذ قرار حقيقي. استخدم مجموعة محجوبة تضم بضع مئات من الصور على الأقل، ومرّر split="test" مرة واحدة بالضبط لاتخاذ القرار النهائي.
تعمّق في الصور التي تعاني من ضعف الأداء#
في عمليات الكشف المدرّبة باستخدام إصدار محفوظ من مجموعة البيانات، يضيف عرض Validation قسم Validation insights: الصور الأسوأ والأفضل أداءً بحسب F1 لكل صورة، مع رسم الحقيقة الأرضية؛ ومستكشفًا للخصائص يربط F1 بحجم الصورة ونسبة أبعادها وعدد الحالات؛ والفئات الأكثر ارتباطًا بالإخفاقات. يضيف خيار Find similar في الصور الأسوأ صورًا مشابهة إلى مجموعة التدريب دون تسميات، محولًا إخفاق البوابة إلى مهمة بيانات ملموسة.
مواطن الخلل#
العَرَض: قيمة mAP المُعلنة للاختبار ممتازة، لكن أداء الإنتاج أسوأ. الحل: أجرِ الضبط على مجموعة التحقق. إذا قارنت عشر عمليات تشغيل على مجموعة الاختبار، فقد استُخدمت للضبط وأصبحت نتيجتها متفائلة. قيّم المرشحين النهائيين على مجموعة الاختبار مرة واحدة، في النهاية تمامًا.
العَرَض: «تفوز» عملية تشغيل بفارق 4 نقاط، ولا يستطيع أحد تفسير السبب وإعادة إنتاجه. الحل: تحقّق من إصدار مجموعة البيانات المثبّت في بطاقة Run Information لكل عملية تشغيل. إذا اختلف الإصداران، فأعِد تشغيل خط الأساس على الإصدار الجديد قبل المقارنة.
العَرَض: يتغير الفائز في كل مرة تعيد فيها التدريب باستخدام بذرة جديدة. الحل: الفروق التي تقل عن نحو 0.5 نقطة mAP تُعد ضوضاء بين عمليات التشغيل في معظم مجموعات البيانات. أبقِ عتبة الضوضاء في بوابة التقييم، واستخدم مجموعة تحقق مستبعدة أكبر عندما تكون النتائج متقاربة إلى هذا الحد.
عرض الحل
الإجابة العملية لنموذج الحبوب: خط الأساس v1-baseline (10 حقبات) مقابل النموذج المرشح v2-finetune (5 حقبات إضافية، SGD، lr0 0.001). عيّن DATA = "medical-pills.yaml" والأوزان الاثنين في gate.py. المخرجات: PASS mAP50-95 0.659 -> 0.687 beats noise وPASS every class keeps 90% of its AP (weak: none) وPASS inference 4.0 ms within 100 ms، والقرار «إطلاق النموذج المرشح». Custom Metadata على v2: الفرضية «كان v1 لا يزال يتحسن عند الحقبة 10»، والتغيير «ضبط دقيق لمدة 5 حقبات، SGD lr0 0.001»، والنتيجة «mAP50-95 0.659 -> 0.687». ملاحظة ينبغي تدوينها في البيانات الوصفية: وجّهت مجموعة التحقق medical-pills التدريب أيضًا، لذا تحقّق من النموذج على مجموعة محجوبة منفصلة قبل الإنتاج.