تنظيم البيانات وإزالة التكرارات وتقسيمها
اكتشف التكرارات بين التقسيمات وفجوات الفئات باستخدام نصين برمجيين قصيرين، وقسّم البيانات وفق الوحدة المهمة، ثم جمّد إصدارًا مدققًا من مجموعة البيانات.
لا يكون تقييم التحقق صادقًا إلا بقدر نزاهة التقسيم. تستخدم COCO128، وهي مجموعة بيانات تجريبية شائعة، الصور الـ128 نفسها للتدريب والتحقق عن قصد؛ وإذا حدث ذلك عرضًا في بياناتك، فستحصل على نموذج «رائع» يفشل عند استخدام الكاميرا التالية. يتضمن هذا الدرس تدقيقين على بيانات حقيقية: فحص التكرارات، وتدقيق الفئات في كل تقسيم، ثم تقسيم البيانات حسب الكاميرا وتجميد إصدار اجتاز كليهما.
عملي
مثال تطبيقي: اكتشاف الصور المشتركة بين التقسيمات#
تحتفظ المنصة بنسخة واحدة من الصورة في كل تقسيم، وتطلب منك تحديد كيفية التعامل مع حالات التعارض عند الرفع، لكن لا شيء يمنع الصورة أو المشهد نفسه من الظهور في مجموعتي التدريب والتحقق. تحقّق قبل الرفع، ومرة أخرى بعد دمج مجموعات البيانات:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']كل صورة تحقق في COCO128 هي أيضًا صورة تدريب. وهذا مقصود في مجموعة بيانات لاختبار التشغيل، وهو بالتحديد سبب عدم دلالة mAP للتحقق فيها على التعميم. في بياناتك، أي عدد غير صفري يعني وجود تسرب: انقل نسخة واحدة من كل صورة أو احذفها قبل التدريب.
اكتشاف التكرارات المتقاربة باستخدام Clustering#
لا تكشف التجزئات إلا البايتات المتطابقة. تختلف إطارات الفيديو المتتالية والصور المتتابعة والنسخ المعاد ترميزها ببضعة بكسلات. افتح أيقونة المخطط المبعثر في شريط أدوات المعرض، ثم انقر Analyze Dataset (من 20 إلى 200,000 صورة، لمجموعات البيانات التي رُفعت فقط):
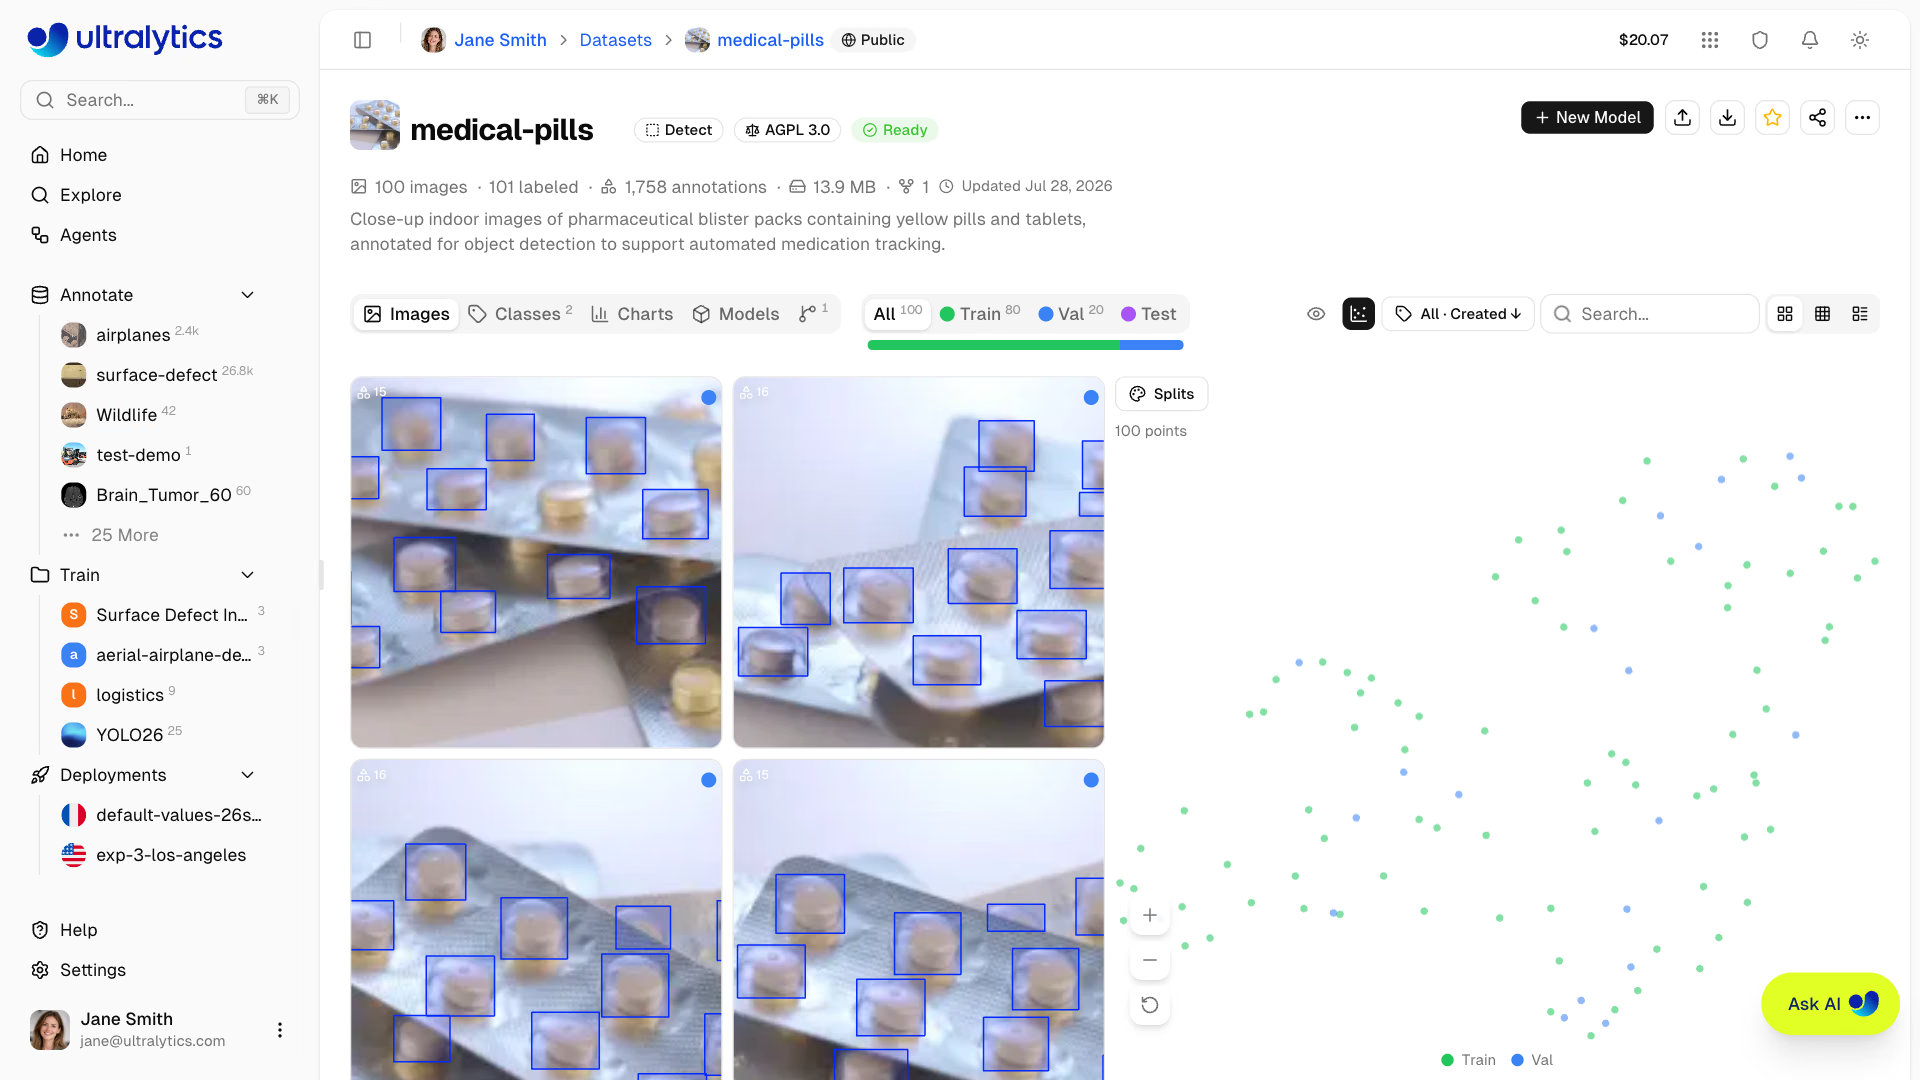
- التلوين حسب التقسيمات: تشير مجموعة نقاط متقاربة تضم نقاطًا من التدريب والتحقق إلى تسرب بسبب التكرارات المتقاربة.
- التلوين حسب المجموعات أو الفئات: تكشف مجموعة ضخمة من فئة واحدة ما تمثّله مجموعة البيانات أكثر من اللازم؛ أما النقاط المعزولة فهي حالات شاذة (كاميرا خاطئة أو إطار تالف أو صورة موسومة خطأً).
- حدّد منطقة باستخدام اللاسو أو انقر عليها لتصفية المعرض وعرض تلك الصور (حتى 1,000 صورة)، ثم احذفها أو انقلها أو أعد وسمها.
تُستخدم التضمينات نفسها في Find similar images ضمن قائمة سياق الصورة، وتضيف صورًا شبيهة من مجموعات البيانات العامة ومجموعات الفريق إلى train كصور غير موسومة: وهي أسرع طريقة لسد فجوة يكشفها التدقيق أدناه.
مثال تطبيقي: تدقيق الفئات في كل تقسيم#
نزّل تصدير NDJSON من ترويسة مجموعة البيانات أو علامة التبويب Versions. يمثّل كل سطر بعد الترويسة صورة واحدة مع تقسيمها ووسومها، لذا تكفي بضعة أسطر من Python لإحصاء كل فئة في كل تقسيم. يطبّق المثال هنا على تصدير COCO8 العام:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valلقراءة النتائج: يحتوي سطر الترويسة على class_names؛ وكل مربع كشف هو [class, x, y, w, h]. تعني غير موجودة في التدريب أن النموذج لا يستطيع تعلم الفئة مطلقًا، وستكون قيمة AP لها في التحقق صفرًا. وتعني عدد قليل جدًا في التحقق أن قيمة AP ستتذبذب بشدة بين عمليات التشغيل: فوجود 7 منصات تحميل في مجموعة التحقق يعني أن تفويت منصة واحدة يغيّر AP للمنصات بنحو 14 نقطة. COCO8 اختبار تشغيل يتألف من 8 صور، لذلك لا تجتاز أي فئة الاختبار؛ أما إصدارك المخصص للإنتاج، فينبغي ألا يُظهر أي تنبيهات. عالج الفجوات بجمع مزيد من الأمثلة، لا بضبط الإعدادات.
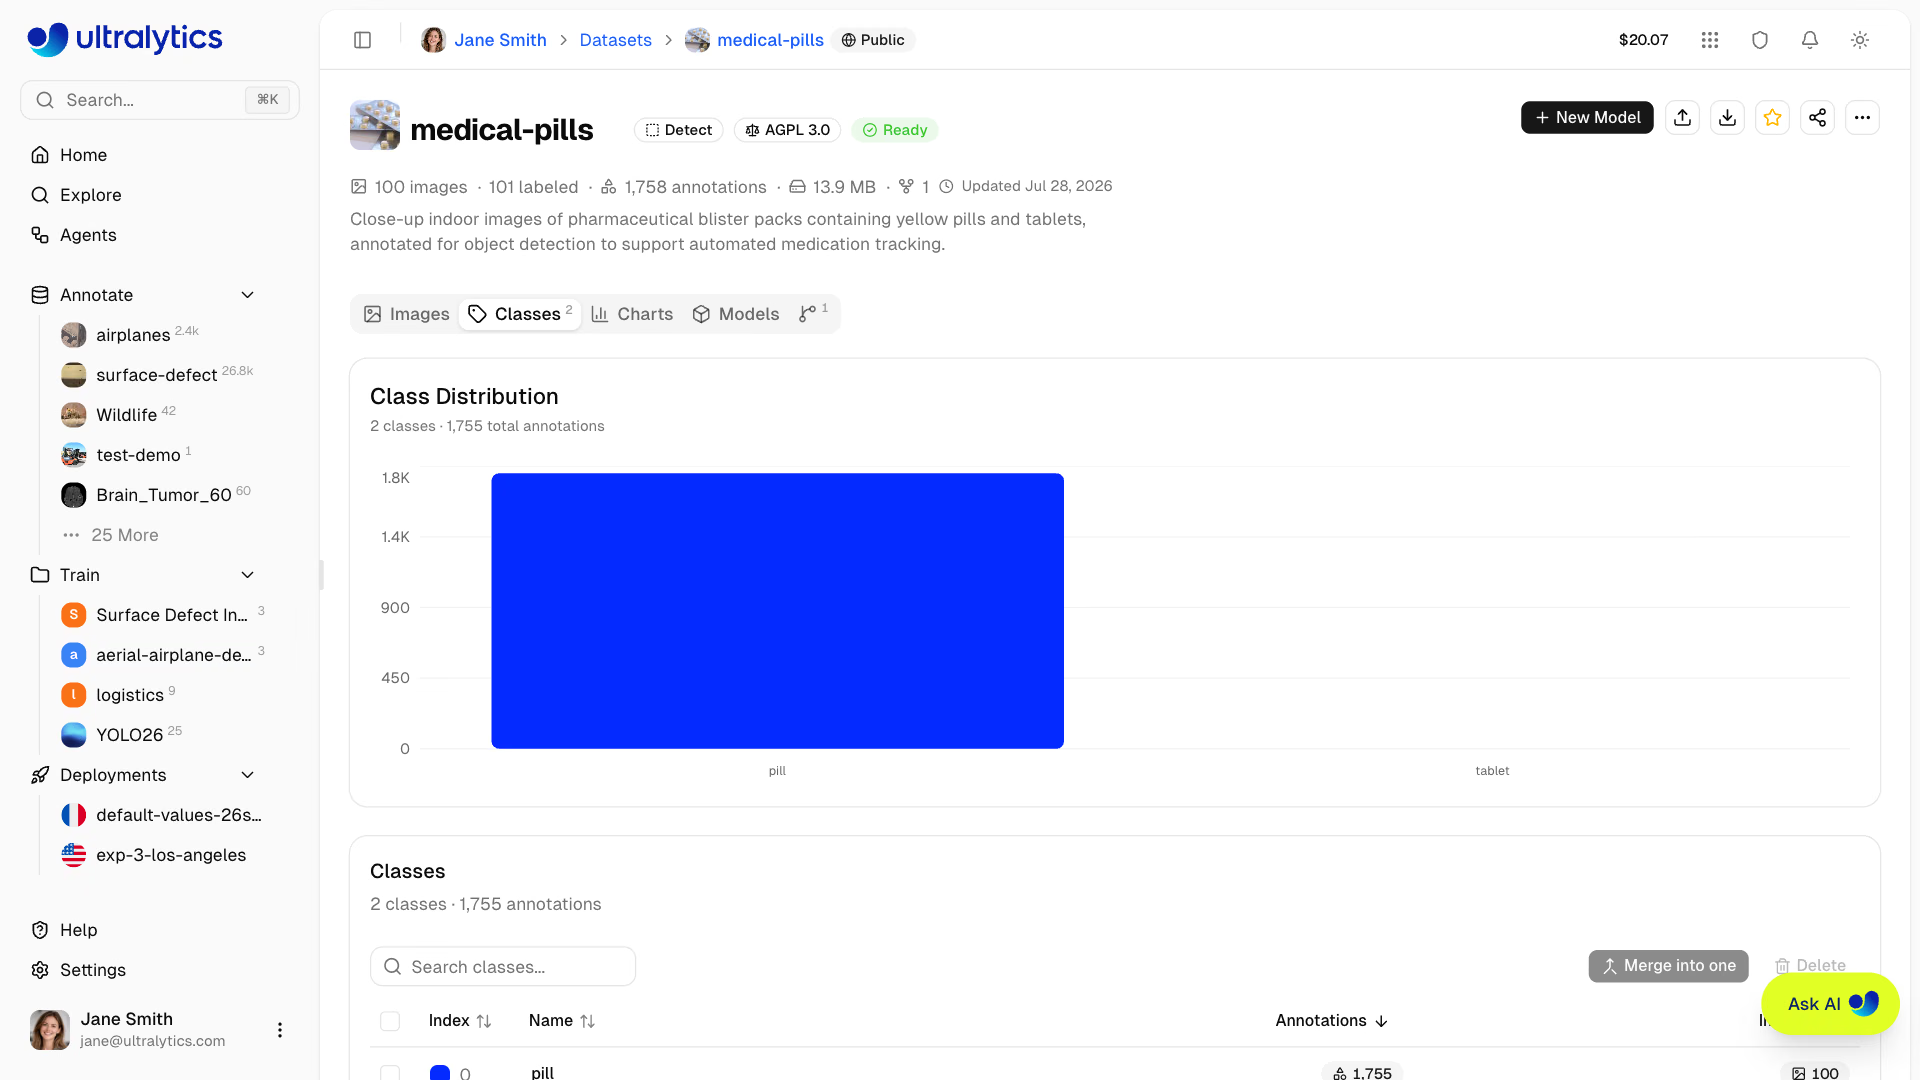
تعرض علامة التبويب Classes الأعداد نفسها لمجموعة البيانات المباشرة، مع خيار مقياس لوغاريتمي للبيانات غير المتوازنة. يدمج Merge into one الفئات المكررة مثل car وautomobile وvehicle في فئة واحدة من دون فقدان التعليقات التوضيحية؛ أما Delete فيحذف فئة وكل التعليقات التوضيحية التابعة لها.
قسّم البيانات وفق الوحدة التي تريد التعميم عليها#
ترتبط الإطارات الملتقطة بالكاميرا أو الجلسة أو اليوم نفسه بعضها ببعض. وإذا ظهرت في مجموعتي التدريب والتحقق، فسيُقيّم النموذج على مشاهد سبق أن رآها. احجز وحدات كاملة لكل ما يتغير في بيئة الإنتاج: إذا كانت الكاميرات جديدة، فاحجز كاميرات كاملة؛ وإذا كانت الكاميرات نفسها تُستخدم في أيام جديدة، فاحجز أيامًا كاملة.
تختلف أدوات التقسيم في المنصة تحديدًا في هذا الجانب:
| الأداة | آلية التعيين | الاستخدام |
|---|---|---|
مجلدات train/ وval/ وtest/ في عملية الرفع | يحتفظ بتعيينك | تقسيمات المجموعات المُعدّة دون اتصال |
| تعيين مرشح التقسيم قبل الرفع | تُنقل كل الملفات في عملية الرفع إلى التقسيم المحدد | رفع كاميرا واحدة لكل تقسيم |
| Move to split في عرض Table | ينقل الصور المحددة | إصلاح صور بعينها |
| شريط التقسيم، Redistribute Splits | يعيد تعيين كل الصور عشوائيًا | الصور المستقلة فقط |

يتناول درس تقسيم مجموعة البيانات على نحو صحيح اختيار الوحدة؛ وبالنسبة إلى مجموعات البيانات الصغيرة جدًا، يتيح التحقق المتقاطع k-fold استخلاص إشارة أكبر. للتحقق من المجموعات بعد الرفع، أضف مفتاح مجموعة إلى تدقيق الفئات (مثل record["file"].split("_")[0] للملفات المسماة cam07_000123.jpg، أو حقل camera في بيانات الصورة الوصفية)، وأبلغ عن أي مجموعة تظهر في تقسيمين.
تجميد إصدار اجتاز التدقيق#
يتطلب التدريب لقطة ثابتة. في علامة التبويب Versions، أدخل وصفًا («v5: حُجزت cam07، +80 صورة لمنصات التحميل») وانقر New Version. كل إصدار لقطة NDJSON مرقّمة وغير قابلة للتغيير، ويمكنك تنزيلها أو مقارنتها أو استعادتها؛ كما تنفّذ Save Dataset Version في مربع حوار التدريب الأمر نفسه عند بدء التدريب، وتعيد استخدام إصدار مطابق إذا لم يتغير شيء. لا تتوفر الإصدارات لمجموعات البيانات السحابية المتصلة أو مجموعات البيانات المحلية في On Premise.
مواطن الخلل#
العَرَض: بعد النقر على Auto بنسبة 80/20، تقفز قيمة mAP للتحقق، بينما لا تتحسن الدقة في الإنتاج. الحل: تعيد ميزة Redistribute Splits تعيين كل صورة عشوائيًا (وتزيل التكرارات المطابقة تمامًا أثناء ذلك)، فتضع إطارات متجاورة في مجموعتي التدريب والتحقق. استخدم مجلدات الرفع أو Move to split للبيانات المجمعة.
العَرَض: يبدأ تصدير قديم أو تنبؤات نموذج فجأةً في حمل أسماء فئات خاطئة. الحل: معرّفات الفئات موضعية، لذا يؤدي دمج فئة أو حذفها إلى إنقاص كل فهرس أعلى منها. أنشئ إصدارًا قبل أي تغيير في الفئات، وأعِد التدريب بدلًا من إعادة استخدام ملفات التسميات القديمة.
العَرَض: تسجل عملية تشغيل جديدة نتيجة أقل بخمس نقاط، مع عدم تغيير أي شيء آخر. الحل: لا يمكن مقارنة المقاييس إلا على التقسيم نفسه. عند تغيير التقسيم، دوّن ذلك في وصف الإصدار وأعِد تشغيل خط الأساس على الإصدار الجديد قبل إجراء أي مقارنة.
عرض الحل
إجابة نموذجية لمجموعة بيانات رافعات شوكية تضم 8 كاميرات. يكشف فحص التكرارات 41 صورة متطابقة بين التدريب والتحقق، وجميعها من مجلد أُعيد رفعه؛ احذف نسخ التحقق. ويُظهر التدقيق، بعد توسيعه باستخدام group = record['file'].split('_')[0]، وجود cam02 في التدريب والتحقق معًا؛ لذا حدد صورها في مجموعة التحقق ضمن عرض Table، واختر Move to split > Train. كما يضع علامة على pallet: train 63, val 7, too few in val: استخدم Find similar images على صورتين لمنصات التحميل لإضافة 40 صورة شبيهة غير موسومة، ووسمها، ثم انقل 15 صورة لمنصات التحميل من cam07 إلى مجموعة التحقق كي تبقى cam07 ضمن مجموعة واحدة. أعد التشغيل: 0 تكرار، و0 مجموعات متسربة، و22 منصة تحميل في مجموعة التحقق. لا يُظهر Clustering الملوّن حسب التقسيم أي مجموعات مختلطة. احفظ v5: cam07 val, cam08 test, +40 pallets.