قسّم مجموعة البيانات بشكل صحيح
قِس مدى تسرّب البيانات في التقسيمات العشوائية، وقسّم المجموعات الكاملة مثل المقاطع أو الكاميرات أو الأيام باستخدام برنامج نصي، وتحقّق من تغطية الفئات، وثبّت مجموعة الاختبار.
يؤدي التقسيم غير المدروس إلى مقياس تثق به لكنه غير صحيح. عندما تقع إطارات فيديو متجاورة في مجموعتي التدريب والتحقق، يقيس mAP التحقق التذكّر بدلًا من القدرة على التعميم، ولا تظهر الفجوة إلا عند التشغيل الفعلي. يرتبط كل رقم تبلّغ عنه عن النموذج بهذا التقسيم، لذا اختره بعناية مرة واحدة وأبقِه ثابتًا.
عملي
ثلاثة تقسيمات، وثلاث مهام#
| التقسيم | الحصة المعتادة | المهمة |
|---|---|---|
| التدريب | 70% | يتعلّم النموذج أوزانه منها |
| التحقق | 15% | اختيار أفضل حقبة، ومقارنة عمليات التشغيل، وضبط الإعدادات |
| الاختبار | 15% | قرار قبول أو رفض نهائي واحد وفقًا لاختبار القبول |
تحدّد إرشادات Ultralytics النطاق بنسبة 70–80% للتدريب و10–20% لكل من التحقق والاختبار: يقترح مراحل مشروع الرؤية الحاسوبية تخصيص 10–15% لكل منهما، بينما يستخدم دليل المعالجة المسبقة تقسيمًا بنسبة 70/20/10. احسب الحصص وفق عدد الكائنات وكذلك الصور، إذ قد تحتوي صورة مزدحمة واحدة على تسميات أكثر من عشر صور قليلة العناصر. أهمية النسب المئوية الدقيقة أقل بكثير من أهمية الغرض من كل تقسيم.
تسرّب التقسيمات العشوائية البيانات المترابطة#
الإطاران 124 و125 من المقطع نفسه متطابقان تقريبًا. إذا وقع أحدهما في التدريب والآخر في التحقق، فسيُقيَّم النموذج في التحقق باستخدام صور سبق أن شاهدها فعليًا. قِس ذلك على مجموعة التدريب العملي من جمع بيانات عالية الجودة وممثّلة، التي تبدأ أسماء ملفاتها بمفتاح مجموعة للكاميرا واليوم:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainتظهر كل مجموعة للكاميرا واليوم في التحقق وكذلك في التدريب. في اللقطات الواقعية، يعني ذلك أن إطارات التحقق تشترك مع إطارات التدريب في الإضاءة والخلفية، وغالبًا في العناصر نفسها تمامًا؛ لذا يبدو mAP التحقق ممتازًا، بينما لا يكون mAP التشغيل الفعلي كذلك.
اختر وحدة التقسيم#
اختر المجموعة التي تتوافق مع متطلبات التعميم في بيئة النشر:
عند الشك، قسّم وفق أعمّ وحدة يمكنك تحمّلها؛ فهي تعطي النتيجة الأكثر صدقًا. لا تكون التقسيمات العشوائية على مستوى الصور آمنة إلا عندما تكون كل صورة ملتقطة بصورة مستقلة، مثل صور المنتجات الملتقطة على مدى أسابيع.
قسّم حسب المجموعة باستخدام الشيفرة#
يسند هذا البرنامج النصي المجموعات كاملةً إلى التقسيمات حتى يصل كل تقسيم إلى حصته البالغة 70/15/15، ويكتب قوائم الملفات التي يقبلها ملف YAML للبيانات، ويعرض تغطية الفئات:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingطريقة قراءته:
- لا تعبر أي مجموعة حدود التقسيم، وذلك بحكم طريقة الإنشاء. وهكذا يُعالج التسرّب.
- يضم التحقق مجموعتين ويفتقد 36 فئة، لذا لا يمكن قياس AP لها. ومع وجود 71 فئة في 128 صورة، لن يعالج أي بذرة هذا النقص؛ والحل الحقيقي هو إضافة مزيد من المجموعات (كاميرات أو أيام إضافية)، كما هو الحال في مجموعة بيانات تشغيل فعلية تضم أكثر من 1,500 صورة لكل فئة.
- يفتقد التدريب 5 فئات لا تظهر إلا في التحقق أو الاختبار. لا يمكن للنموذج تعلّمها مطلقًا من هذا التقسيم.
قاعدة اتخاذ القرار: عندما تغيب فئة عن أحد التقسيمات، أضف أو انقل مجموعات كاملة تحتوي عليها، ولا تنقل إطارات مفردة مطلقًا، لأن ذلك سيعيد إدخال التسرّب. وجّه مفاتيح train وval وtest في ملف YAML للبيانات إلى ملفات .txt الثلاثة؛ ويتناول كتابة ملف YAML لمجموعة البيانات بقية الملف.
وازن الفئات بين التقسيمات#
في مهام التصنيف، تحافظ train_test_split(..., stratify=labels) في scikit-learn على تساوي نسب الفئات بين التقسيمات باستخدام وسيط واحد. تحتوي صور الكشف على عدة فئات في الوقت نفسه، لذا وازنها على مستوى المجموعة بدلًا من ذلك: بعد group_split.py، قارن أعداد كل فئة بين التقسيمات وبدّل مجموعات كاملة حتى تقع كل فئة ضمن نحو ±20% من حصتها المتوقعة.

في Ultralytics Platform، تعيد إعادة توزيع التقسيمات تعيين الصور عشوائيًا، ويضبط تلقائي التقسيم الموصى به 80/20 للتدريب/التحقق (وثائق التقسيم). وتزيل الصور المكررة تمامًا أثناء ذلك، لكنها لا تتعرّف على مجموعاتك؛ لذا استخدمها للقطات المستقلة، وحمّل تقسيمات مجمّعة لبيانات الفيديو أو البيانات متعددة الكاميرات.
تابع مجموعتي تحقق على نحو منفصل#
غالبًا ما تحتاج إلى مجموعتي تحقق: مجموعة انحدار منتقاة ومستقرة، ومجموعة تحاكي ظروف التشغيل الفعلية وتتغير مع الإطارات المجمّعة حديثًا. يقبل ملف YAML للبيانات قائمة بمجلدات التحقق، لكنه يدمجها في مجموعة تحقق واحدة ذات نتيجة واحدة:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
للاطلاع على نتيجة كل مجموعة، احتفظ بملف YAML للبيانات لكل مجموعة تحقق (مع استخدام train وnames نفسيهما، وتغيير val) وتحقّق من الأوزان المدرّبة باستخدام كل مجموعة:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
يشير الانخفاض في المجموعة المنتقاة إلى تراجع في الأداء؛ أما الانخفاض في مجموعة التشغيل الفعلي فيشير إلى تحوّل المجال.
ثبّت مجموعة الاختبار#
أعلى أخطاء التقسيم تكلفةً هو مقارنة عشرة نماذج مختلفة على مجموعة الاختبار. ما إن يؤثر الاختبار في أي قرار، حتى تصبح النتيجة النهائية متفائلة. أجرِ جميع عمليات الضبط ومقارنة التشغيل على مجموعة التحقق، ونفّذ اختبار القبول على مجموعة الاختبار مرة واحدة في النهاية.
يرتبط كل مقياس تنشره بهذا التقسيم. إعادة الخلط لاحقًا تغيّر كل الأرقام وتجعل مقارنة عمليات التشغيل القديمة والجديدة مستحيلة. احتفظ بوحدة التقسيم والبذرة وقوائم الملفات الثلاث مع مجموعة البيانات.
التحقق المتقاطع بطريقة K-fold لمجموعات البيانات الصغيرة#
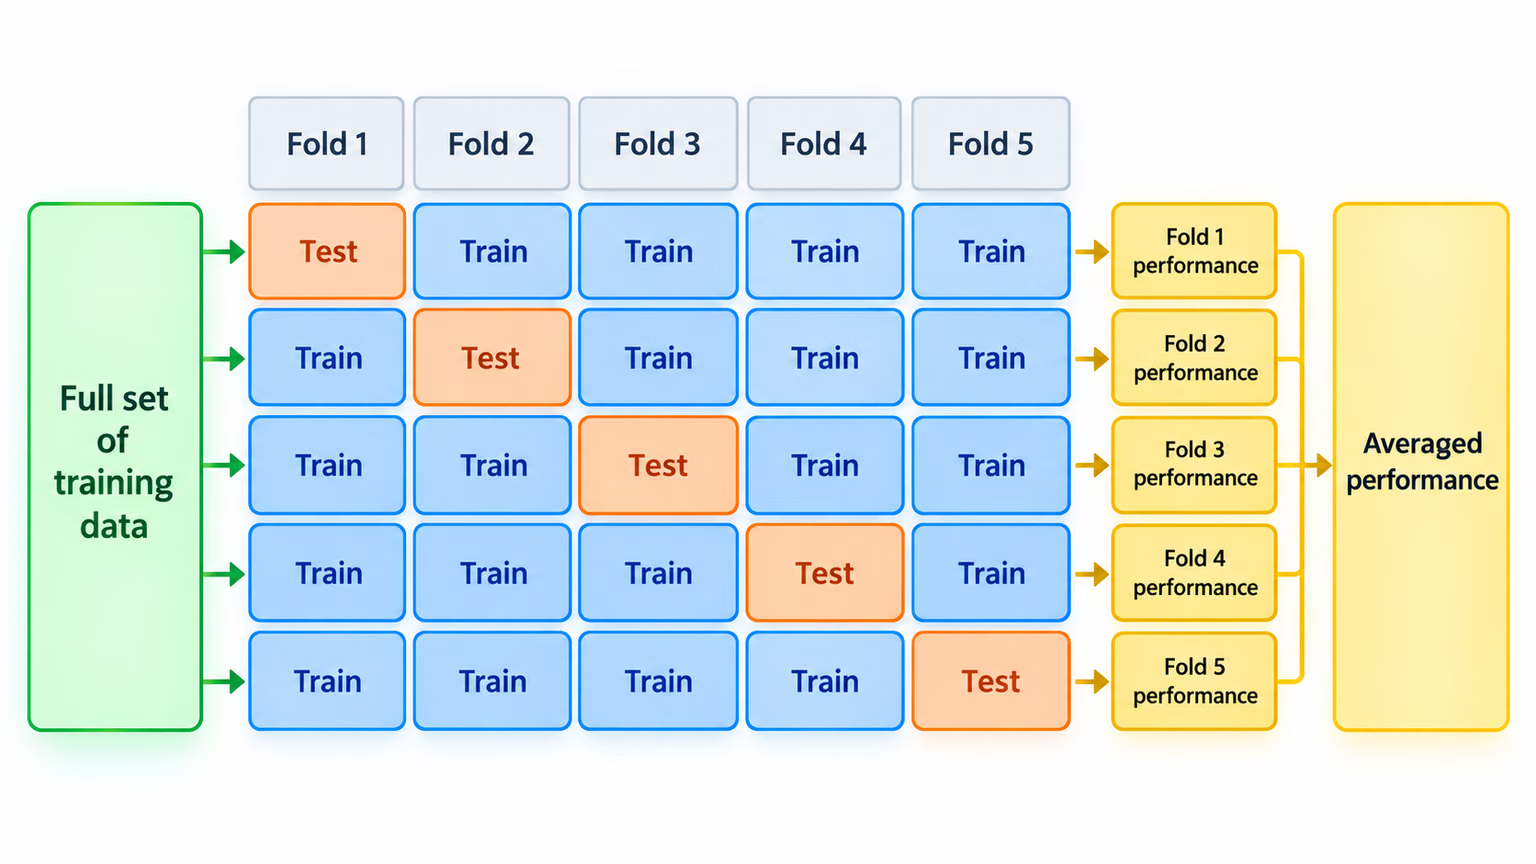
عندما تكون مجموعة البيانات صغيرة (أقل من نحو 500 صورة لكل فئة) ويبدو تقسيم واحد ضعيفًا إحصائيًا، يدرّب التحقق المتقاطع بطريقة K-fold عدد k من النماذج باستخدام تقسيمات متناوبة، ثم يحسب متوسط النتيجة: أي حوسبة تعادل k مرات، مقابل تقدير أكثر ثباتًا بكثير. أنشئ الطيات من مجموعات بالطريقة نفسها، وإلا سيتسرّب التداخل إلى كل طية.
عرض الحل
بالنسبة إلى كاميرات المستودع الثابتة التي يجب أن تواصل العمل في أيام جديدة، قسّم حسب الكاميرا واليوم: cam2_2026-05-01. بعد group_split.py، تحقّق من عدم عبور أي مجموعة حدود التقسيم:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneيجتاز تقسيم التدريب العملي فحص التسرّب، لكنه لا يجتاز فحص التغطية: يفتقد التحقق 36 فئة من أصل 71. الحل هو وضع خطة لجمع البيانات، لا إعادة التقسيم. التقط بيانات ليومين إضافيين على الأقل للكاميرا من أجل التحقق والاختبار، على أن يغطي كل منهما الفئات الأهم في المواصفات، ثم أعد تشغيل البرنامجين النصيين.