الضبط الدقيق الأول وحلقة التكرار
أجرِ ضبطًا دقيقًا لأوزان YOLO26 المدرّبة مسبقًا بالإعدادات الافتراضية، ورتّب الفئات حسب AP مع إحصاء حالات الإخفاق والالتباس، وحوّل أضعف فئة إلى إصلاح مجموعة البيانات التالية.
تحصل جولة التدريب في هذا الدرس على mAP50 بقيمة 0.66، وهو ما يبدو كأنه مشكلة في معدل التعلّم. لكن جدولًا لكل فئة يروي قصةً مختلفة: لدى cup عدد 14 كائنًا موسومًا في مجموعة التحقق، ولا يعثر النموذج على أي منها. هذه مشكلة بيانات، ولم يكن أي ضبط للمعلمات الفائقة ليحلّها. تعامل مع التشغيل الأول بوصفه أداة تشخيص تحدد الفئة التي ينبغي إصلاحها تاليًا.
عملي
ابدأ بأوزان مدرّبة مسبقًا#
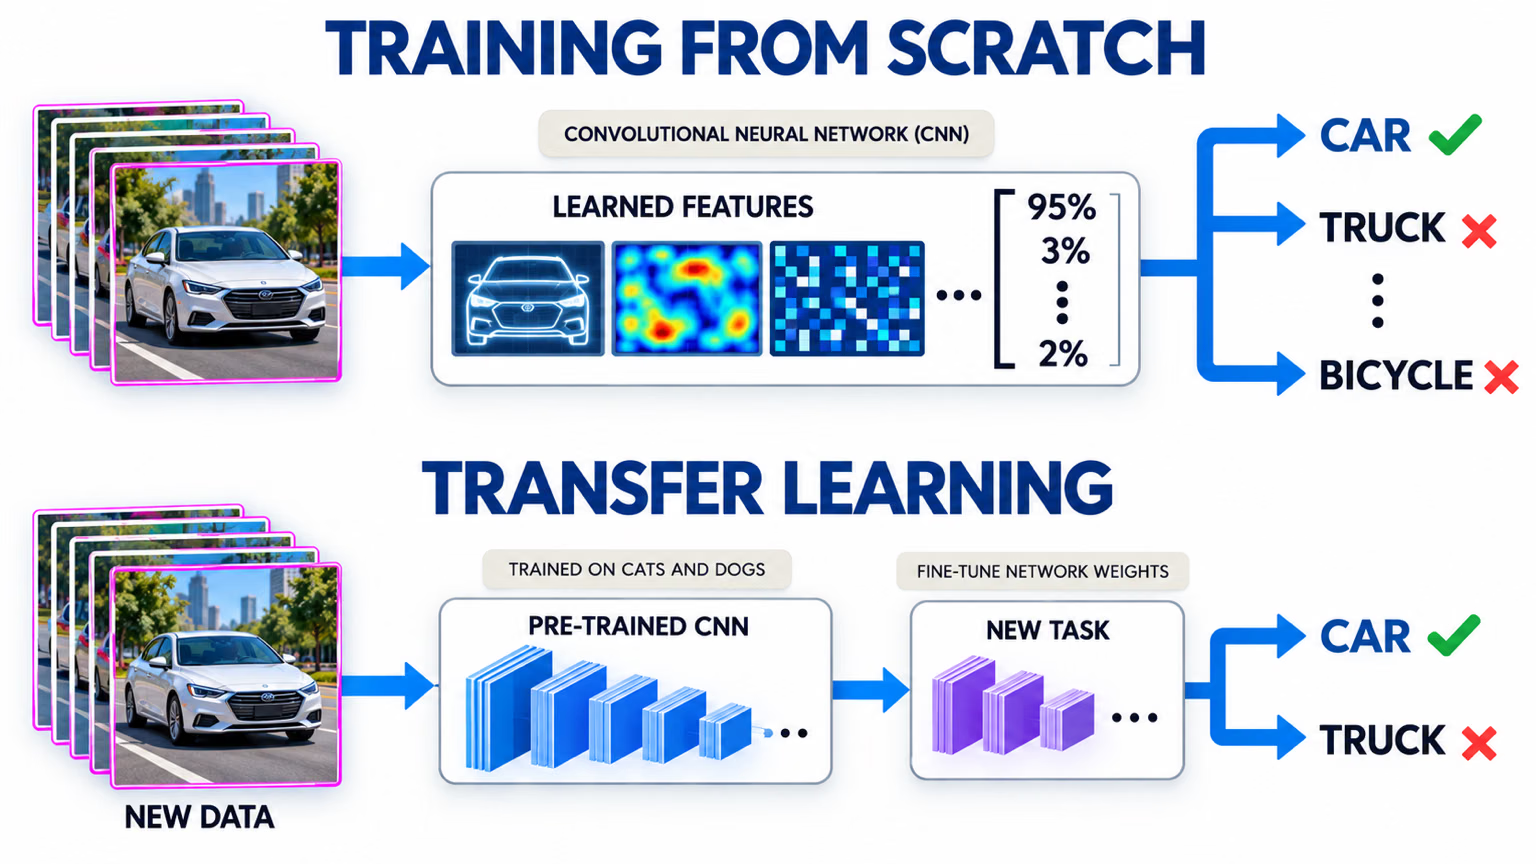
يبدأ الضبط الدقيق بأوزان تتعرف مسبقًا على الحواف والقوام والأشكال، ولذلك يتقارب أسرع ويحتاج إلى بيانات أقل بكثير من التدريب بأوزان عشوائية. اختر نقطة تحقق YOLO26 الملائمة لمهمتك:
| المهمة | نقطة تحقق مدرّبة مسبقًا | التدريب المسبق على |
|---|---|---|
| الكشف | yolo26n.pt | COCO |
| التجزئة | yolo26n-seg.pt | COCO |
| دلالي | yolo26n-sem.pt | Cityscapes |
| الوضعية | yolo26n-pose.pt | نقاط COCO المفتاحية |
| OBB | yolo26n-obb.pt | DOTAv1 |
| التصنيف | yolo26n-cls.pt | ImageNet |
| العمق | yolo26n-depth.pt | مزيج كبير من بيانات العمق الداخلية والخارجية |
ينتقل كل من العمود الفقري والعنق كما هما؛ ويُعاد تهيئة رأس المهمة جزئيًا ليتوافق مع عدد فئاتك. لا يكون التدريب من الصفر مجديًا إلا مع مجموعات بيانات ضخمة في مجالات غير مألوفة للغاية. ابدأ بنموذج nano (n) للحصول سريعًا على خط أساس، ولا تنتقل إلى أحجام أكبر إلا بعد أن تتوقف دورة البيانات عن تحقيق تحسّن. يشرح دليل الضبط الدقيق ما يجري داخل النموذج.
شغّل خط الأساس#
درّب بالإعدادات الافتراضية؛ فالهدف من التشغيل الأول هو إنشاء خط أساس، لا تسجيل رقم قياسي. يجري هذا التدريب على تقسيم مجموعة التدريب الوارد في تقسيم مجموعة البيانات على نحو صحيح، مع كتابة YAML البيانات أولًا:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML
names = check_det_dataset("coco128.yaml")["names"] # تحتفظ مجموعة التدريب بأسماء فئات COCO
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})
model = YOLO("yolo26n.pt") # مدرّب مسبقًا على COCO؛ استخدم نقطة التحقق الخاصة بمهمتك
model.train(data="practice.yaml", epochs=3, imgsz=320) # تشغيل فعلي: epochs=100, imgsz=640 Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486يحتوي مجلد التشغيل (runs/detect/train/) الآن على weights/best.pt. لا يستحق النظر في التشغيل الأول سوى ثلاث وسيطات:
| الوسيط | افتراضي | متى تغيّرها |
|---|---|---|
epochs | 100 | أعداد أقل لمجموعات البيانات الصغيرة جدًا؛ و200–300 للمجموعات الكبيرة جدًا |
imgsz | 640 | 1024 أو 1280 إذا كان كثير من الكائنات صغيرًا في الإطار |
batch | 16 | -1 للتجميع التلقائي؛ وخفّض القيمة عند نفاد الذاكرة |
يتناول تدريب نموذجك الأول استدعاء التدريب وسجلّه المباشر بالتفصيل.
رتّب الفئات واطّلع على حالات الإخفاق#
تخفي قيمة mAP الإجمالية موضع المشكلة. رتّب الفئات حسب AP50-95، واستخدم مصفوفة الالتباس لتقسيم أخطاء كل فئة إلى كائنات لم يكتشفها النموذج مطلقًا وكائنات صنّفها على أنها تنتمي إلى فئة أخرى:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classيشير كل نوع من الأخطاء إلى إصلاح مختلف لمجموعة البيانات:
- عدد قليل جدًا من الحالات في مجموعة التحقق (
forkوhandbagوsink، حالة واحدة لكل منها): قيمة AP هنا مجرد ضوضاء. لا تتخذ إجراءً بشأن فئة حتى تضم مجموعة التحقق بضع عشرات من حالاتها على الأقل؛ واجمع أولًا مزيدًا من مجموعات التحقق. - لم يُكتشف (
carفي 4 من 4 حالات، وcupفي 10 من 14 حالة): لا يرى النموذج أي كائن على الإطلاق. تحقّق من تغطية هذا السيناريو في التدريب وابحث عن الوسوم المفقودة باستخدامsuspect_labels.py. - صُنّف على أنه ينتمي إلى فئة أخرى (
cupفي 4 من 14 حالة): تتداخل تعريفات الفئات. افتح تلك الصور، ودقّق التعريفات، واذكر الفئة المشابهة في الدليل.
cup هي النتيجة التي تستدعي اتخاذ إجراء هنا: 14 حالة موسومة، ولم يُعثر على أي منها.
اقرأ مجلد التشغيل بوصفه تغذية راجعة عن البيانات#

ينشئ كل تشغيل تدريبي هذه الملفات، كما تعرض Ultralytics Platform المنحنيات نفسها مباشرةً أثناء التدريب السحابي:
| الملف | ما الذي يخبرك به عن البيانات |
|---|---|
confusion_matrix_normalized.png | الفئات التي يلتبس بعضها ببعض أو التي تُصنّف خطأً على أنها خلفية |
BoxPR_curve.png | الدقة والاستدعاء لكل فئة؛ ويشير المنحنى المنخفض إلى فئة ضعيفة |
val_batch0_pred.jpg | تنبؤات على صور حقيقية من مجموعة التحقق؛ ابحث عن حالات الإخفاق المتكررة |
labels.jpg | أعداد الفئات وأحجام الصناديق التي دُرّب عليها النموذج |
results.png | منحنيات الخسارة والمقاييس؛ يشير ارتفاع خسارة التحقق مع انخفاض خسارة التدريب إلى فرط التكيّف |
يشرح التحقق والتشخيص كل مخطط؛ والسؤال هنا دائمًا هو: ما الذي تفتقده البيانات؟
حلقة العمل التي تبدأ بالبيانات#
خطوات التكرار المعتادة: اختر أضعف فئة لديها عدد كافٍ من الحالات في مجموعة التحقق، وراجع نحو 50 صورة تحتوي عليها، وأصلح البيانات، وأعِد التدريب بالإعدادات والتقسيم نفسيهما، ثم قارن AP لكل فئة. بعد ذلك انتقل إلى الفئة التالية من حيث الضعف.
إذا أضفت 300 صورة ورفعت imgsz في إعادة التدريب نفسها، فلن تستطيع معرفة أي التغييرين أثّر في النتيجة. أبقِ الإعدادات والتقسيم كما هما أثناء التكرار على البيانات، بحيث تعزل كل مقارنة تغييرًا واحدًا في البيانات.
متى تلجأ إلى المعلمات الفائقة#
بعد تكرارين أو ثلاثة لتحسين البيانات، عندما لا يعود من الممكن إرجاع الفئات الضعيفة المتبقية إلى قصور التغطية أو الوسوم أو التعريفات، قد يساعد الضبط على كسب النقاط القليلة الأخيرة. يتناول دليل الضبط الدقيق تجميد الطبقات ومعدلات التعلّم واختيار المُحسِّن. لكن ضبط النموذج قبل تصحيح البيانات يعني قضاء أسابيع في تحسين نموذج لمجموعة البيانات الخاطئة.
بعد اجتياز النموذج acceptance_test.py على مجموعة الاختبار المحجوزة، يتناول كتاب Ultralytics YOLO in Production التصدير والتقديم، ويتناول كلٌّ من مراقبة الحالة والدقة وأتمتة حلقة إعادة التدريب في كتاب Build with Ultralytics Platform حلقة إعادة التدريب.
عرض الحل
من التشغيل التجريبي، الفئة cup هي الفئة التي ينبغي العمل عليها: وُسِمت 14 صورة في مجموعة التحقق، ولم يُعثر على أي صورة، وفاتت 10 صور، وصُنفت 4 صور على أنها فئة أخرى. خطة محددة الحجم:
| النتيجة | إجراء مجموعة البيانات | الحجم |
|---|---|---|
| فاتت 10 أكواب من أصل 14 | تحقّق من تغطية التدريب: احسب صور التدريب التي تتضمن أكوابًا بحسب الكاميرا واليوم؛ واجمع صورًا للأكواب من المجموعات التي لا تضم أيًّا منها | 40 صورة جديدة تتضمن أكوابًا، موزعة على 4 أيام تصوير بالكاميرا |
| صُنفت 4 أكواب من أصل 14 على أنها فئة أخرى | افتح الصور في val_batch0_pred.jpg ومصفوفة الالتباس؛ إذا صُنفت على أنها wine glass أو bowl، فأضف كلا العنصرين المتشابهين إلى تعريف cup | أعِد وسم نحو 30 صورة تدريب وفق القاعدة الجديدة |
| الفئات ذات المثال الواحد | لا تتخذ أي إجراء بعد؛ أضف مجموعات التحقق التي تتضمنها | جولة الجمع التالية |
بعد ذلك، أعد التدريب باستخدام epochs وimgsz مع إبقاء التقسيم دون تغيير، ثم أعد تشغيل rank_classes.py وقارن قيمة AP في cup قبل التغيير وبعده. إذا ارتفعت، فكانت البيانات هي عنق الزجاجة؛ وإذا لم ترتفع، فراجع الصور الخمسين التالية قبل تعديل أي معلمة فائقة.