درّب نموذجك الأول
اضبط YOLO26 بدقة على مجموعة بياناتك باستدعاء واحد، وتابع سجل التدريب المباشر سطرًا سطرًا، واعثر على best.pt والمخططات المهمة في مجلد التشغيل.
يستغرق تدريب كاشف من الصفر أيامًا ويتطلب مجموعات بيانات ضخمة. أما الضبط الدقيق لنموذج YOLO26 مُسبق التدريب على نحو مئة صورة، فيستغرق دقيقة تقريبًا على وحدة المعالجة المركزية في حاسوب محمول، لأن التعلّم بالنقل يعيد استخدام كل ما يعرفه النموذج بالفعل عن الحواف والأشكال والكائنات.
في هذا الدرس، ستقوم بـالتدريب على مجموعة بيانات الأقراص، وتراقب ارتفاع mAP50-95 من قيمة أساسية تقترب من الصفر إلى 0.66 خلال عشر حقب، وتتعلم كيف تحدد مبكرًا من السجل ما إذا كان التشغيل سليمًا أم يهدر وقتك.
عملي
مثال تطبيقي: تدريب كاشف الأقراص#
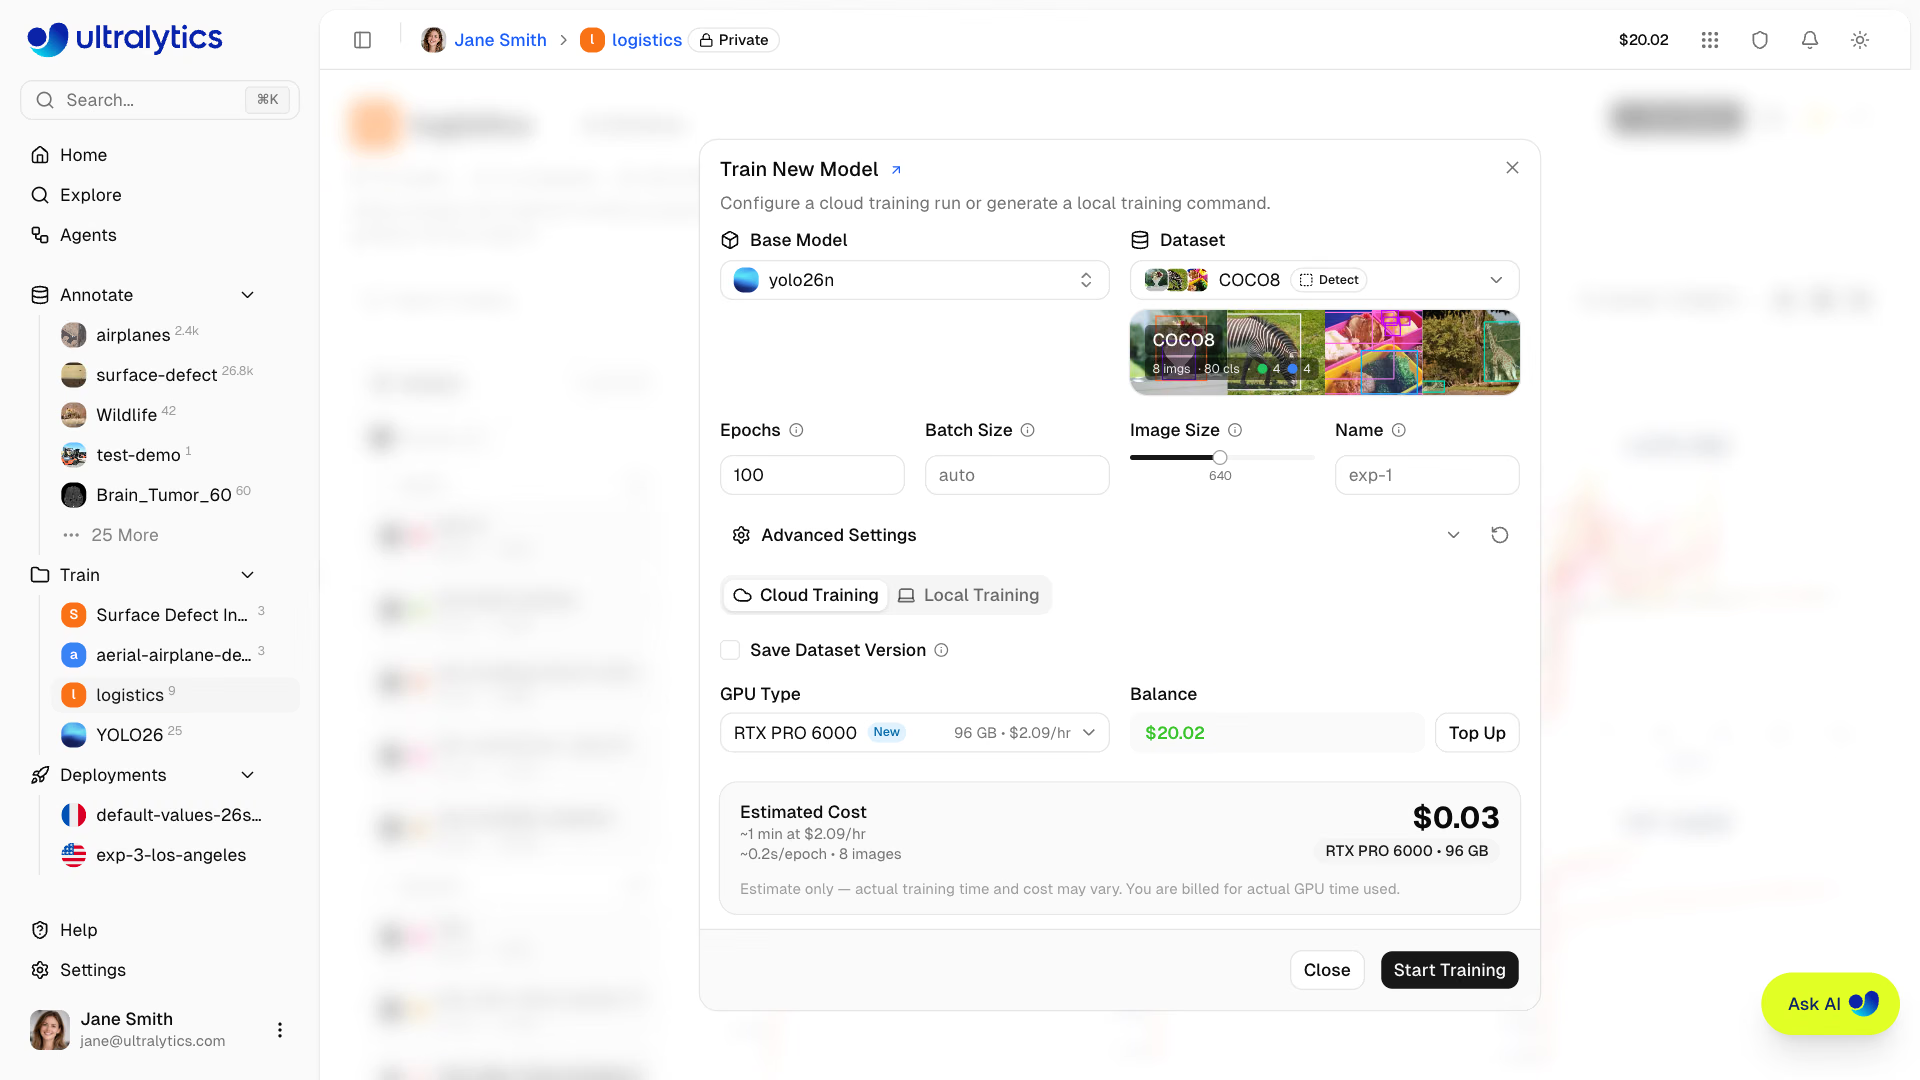
يطلب مربع حوار «تدريب نموذج جديد» في منصة Ultralytics الخيارات نفسها الواردة في الشيفرة أدناه — النموذج الأساسي ومجموعة البيانات والحقب وحجم الصورة — ثم ينفذها إما على GPU سحابي أو ينشئ الأمر المحلي المطابق. تُنجز هذه الإعدادات في نحو دقيقة على CPU في حاسوب محمول:
from ultralytics import YOLO
model = YOLO("yolo26n.pt") # مدرَّب مسبقًا على COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)CLI وPython متكافئان. يُبقي epochs=10 وimgsz=320 تشغيلات CPU قصيرة؛ أما عند استخدام GPU، فاحذفهما واعتمد الإعدادات الافتراضية (epochs=100، imgsz=640)، لأن زيادة عدد الحقب والبكسلات مفيدة دائمًا تقريبًا. ينفذ وضع التدريب هذه الحلقة نيابةً عنك:
اقرأ السجل سطرًا سطرًا#
مخرجات فعلية، مقتطعة لتعرض أول حقبتين وآخر حقبتين:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): اختارoptimizer=autoالافتراضي المحسِّن ومعدل التعلّم نيابةً عنك.Using 92 train, 23 val images: تأكد من مطابقة هذه القيم لمجموعة البيانات لديك. يشير العدد الأقل إلى صور تم تخطيها.GPU_mem 0G: يجري التدريب على CPU. على GPU، ستظهر هنا الذاكرة المستخدمة؛ ويعني0Gعلى جهاز مزود بـGPU أنه غير مستخدم.- السطر الأول لكل حقبة: الخسائر الثلاث لمجموعة التدريب، بالإضافة إلى عدد الكائنات الموسومة في الدفعة الأخيرة (
Instances) وحجم الصورة. - سطر
allلكل حقبة: الدقة والاستدعاء وmAP50 وmAP50-95 على مجموعة التحقق. هذا هو السطر الذي ينبغي مراقبته.
| العمود | المعنى | الاتجاه الصحي |
|---|---|---|
box_loss | مدى بُعد الصناديق المتوقعة عن الصناديق الموسومة | تنخفض، ثم تستقر |
cls_loss | مدى خطأ درجات الفئات | تنخفض، ثم تستقر |
l1_loss | خطأ إحداثيات الصندوق المباشر في YOLO26 | تنخفض |
P, R | الدقة والاستدعاء على مجموعة التحقق | ترتفع وتظل متوازنة |
mAP50, mAP50-95 | جودة الكشف؛ كما تكافئ mAP50-95 الصناديق المحكمة | ترتفع، ثم تبلغ مستوى مستقرًا |
هنا، ارتفعت mAP50-95 من القيمة الأساسية 0.0002 إلى 0.548 بعد حقبة واحدة، ثم إلى 0.659 بعد عشر حقب. وانخفضت الدقة إلى 0.80 في الحقبة 4 ثم تعافت: فالنتائج متقلبة بين الحقب عند التحقق على 23 صورة، لذا قيّم الاتجاه العام لا سطرًا واحدًا. قواعد اتخاذ القرار أثناء التشغيل:
- تنخفض الخسائر وترتفع mAP: اترك التشغيل مستمرًا.
- الخسائر ثابتة منذ الحقبة 1: أوقف التشغيل باستخدام Ctrl+C وتحقق من التسميات وملف YAML.
- الدقة أعلى بكثير من الاستدعاء: النموذج متحفظ ويفوّت الكائنات. الاستدعاء أعلى بكثير من الدقة: يكتشف النموذج أشياء غير موجودة.
- mAP ثابتة لحقب عديدة: لن تساعد زيادة عدد الحقب؛ غيّر البيانات أو
imgsz.
الخسائر الثلاث هي مكونات دالة الخسارة في YOLO26؛ ويشرح دليل مقاييس الأداء كل مقياس بالتفصيل.
اعثر على الملفات التي أنشأها التشغيل#
تُحفظ جميع الملفات في runs/detect/pills_v1/:
| الملف | الغرض |
|---|---|
weights/best.pt | نقطة التحقق ذات أفضل ملاءمة على بيانات التحقق عبر الحقب؛ استخدمها للاستدلال والتصدير |
weights/last.pt | أحدث نقطة تحقق؛ تُستخدم لاستئناف تشغيل متوقف |
args.yaml | كل وسيطات التشغيل، لإعادة إنتاجه |
results.csv, results.png | الخسائر والمقاييس لكل حقبة، على هيئة بيانات ومخططات |
labels.jpg | أعداد الفئات ومخططات توزيع حجم الصناديق ومواضعها |
train_batch*.jpg | دفعات التدريب المعززة مع رسم التسميات |
val_batch*_labels.jpg, val_batch*_pred.jpg | الحقيقة الأساسية مقابل التنبؤات على صور التحقق |
confusion_matrix*.png, Box*_curve.png | مصفوفة الالتباس ومنحنيات الدقة والاستدعاء وF1 وPR |
افتح train_batch0.jpg قبل أي شيء آخر. إذا لم تكن صناديقه منطبقة على الكائنات، فالتسميات خاطئة، ولن يصلح ذلك أي عدد من الحقب.
غيّر هذه الوسيطات أولًا#
| الوسيط | افتراضي | متى تغيّره |
|---|---|---|
epochs | 100 | التجارب القصيرة على CPU أو مجموعات البيانات الصغيرة التي تبدأ في فرط التكيّف (خفّض القيمة)؛ ومجموعات البيانات الكبيرة التي لا تزال تتحسن (ارفعها إلى 200–300) |
imgsz | 640 | الكائنات الصغيرة (ارفع القيمة إلى 1024 أو 1280) أو تجارب CPU (اخفضها) |
batch | 16 | حجم الدفعة: خفّضه عند نفاد الذاكرة، أو استخدم -1 لضبطه تلقائيًا على نحو 60% من ذاكرة GPU |
patience | 100 | أوقف التدريب مبكرًا إذا لم تتحسن ملاءمة التحقق خلال N حقبة، مثل patience=20 |
device | تلقائي | حدّد cpu أو mps أو فهرس GPU مثل 0، أو عدة فهارس مثل [0, 1] |
name | train | دائمًا: سمِّ عمليات التشغيل بما يصف التغيير |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")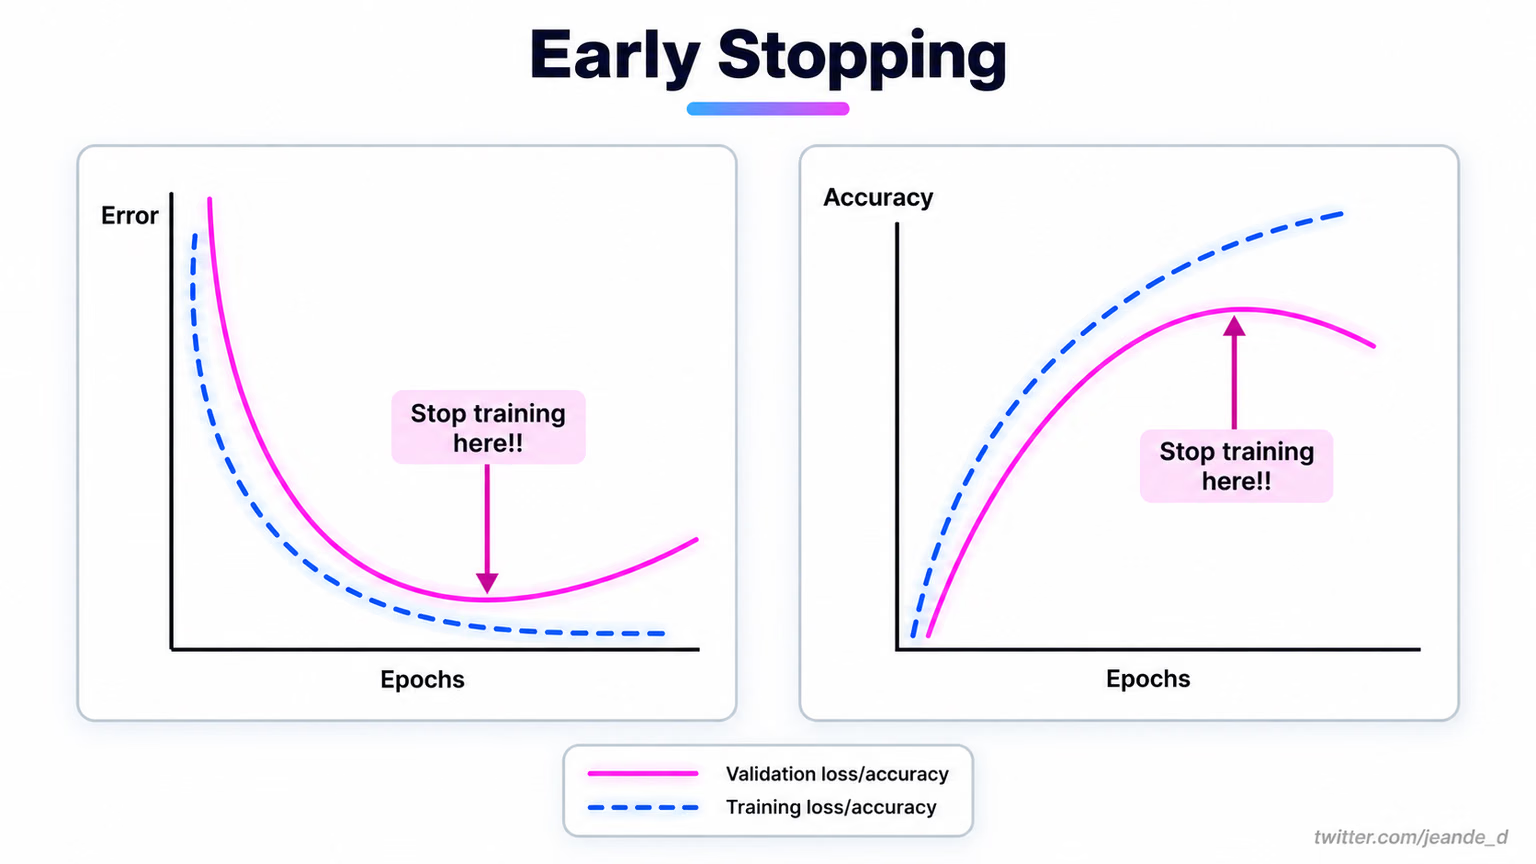
تعني القيمة الافتراضية patience البالغة 100 أن تشغيلًا من 100 حقبة لن يتوقف مبكرًا أبدًا. تنهي قيمة أقل تشغيلًا متعثرًا عند النقطة التي تشير إليها المنحنيات أعلاه؛ ويُحتفظ بـbest.pt في الحالتين.
عند استخدام عدة وحدات GPU، مرّر قائمة مثل device=[0, 1, 2, 3]: تبدأ Ultralytics تدريبًا موزعًا متوازيًا للبيانات (DDP) نيابةً عنك، ويمثل batch الإجمالي عبر وحدات GPU، ويستخدم التدريب الدقة المختلطة افتراضيًا (amp=True). عندما يتجاوز التشغيل قدرة حاسوبك المحمول، يمكنك تشغيل مجموعة البيانات والوسيطات نفسها على GPU سحابي عبر منصة Ultralytics، كما هو موضح في تدريب عمليات التشغيل وقراءتها وضبطها الدقيق.
تجنّب هذه الأخطاء#
العَرَض: قيمة mAP تقترب من الصفر بعد عصور تدريب كثيرة على مجموعة بيانات صغيرة. السبب: جاء النموذج من yolo26n.yaml (أوزان عشوائية) بدلًا من yolo26n.pt. الحل: ابدأ دائمًا من .pt مدرَّب مسبقًا. لا يُجدي التدريب من الصفر إلا في أبحاث الشبكة الأساسية أو مع مجموعات البيانات الضخمة.
العَرَض: CUDA out of memory في العصر الأول. الحل: خفّض batch إلى النصف، أو اضبط batch=-1 ليختار AutoBatch حجمًا ملائمًا. يساعد خفض imgsz أيضًا، لكنه يغيّر ما يستطيع النموذج رؤيته.
يمثل last.pt العصر الأخير، وقد يكون أداؤه أسوأ من عصر سابق. أما best.pt فهو العصر الذي حقق أفضل ملاءمة على التحقق، وهو العصر الذي ينبغي التحقق منه وتصديره ونشره.
يتناول دليل نصائح تدريب النماذج الوسيطات المتبقية، ويتناول دليل ضبط المعلمات الفائقة تجارب معدل التعلّم والضبط الجيني. ويتناول دليل الضبط الدقيق تجميد الطبقات.
عرض الحل
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsتختلف الأرقام الدقيقة قليلًا باختلاف الأجهزة وإصدار الحزمة.