Entrena tu primer modelo
Ajusta YOLO26 a tu conjunto de datos con una sola llamada, lee el registro de entrenamiento en directo línea a línea y encuentra best.pt y los gráficos importantes en la carpeta de ejecución.
Entrenar un detector desde cero lleva días y requiere conjuntos de datos enormes. Ajustar un YOLO26 preentrenado con unas cien imágenes lleva alrededor de un minuto en la CPU de un portátil, porque el aprendizaje por transferencia reutiliza todo lo que el modelo ya sabe sobre bordes, formas y objetos.
En esta lección, entrenarás con el conjunto de datos de píldoras, verás cómo la mAP50-95 pasa de una referencia casi nula a 0.66 en diez épocas y aprenderás a identificar pronto en el registro si una ejecución va bien o te está haciendo perder el tiempo.
Práctico
Ejemplo práctico: entrenar el detector de píldoras#
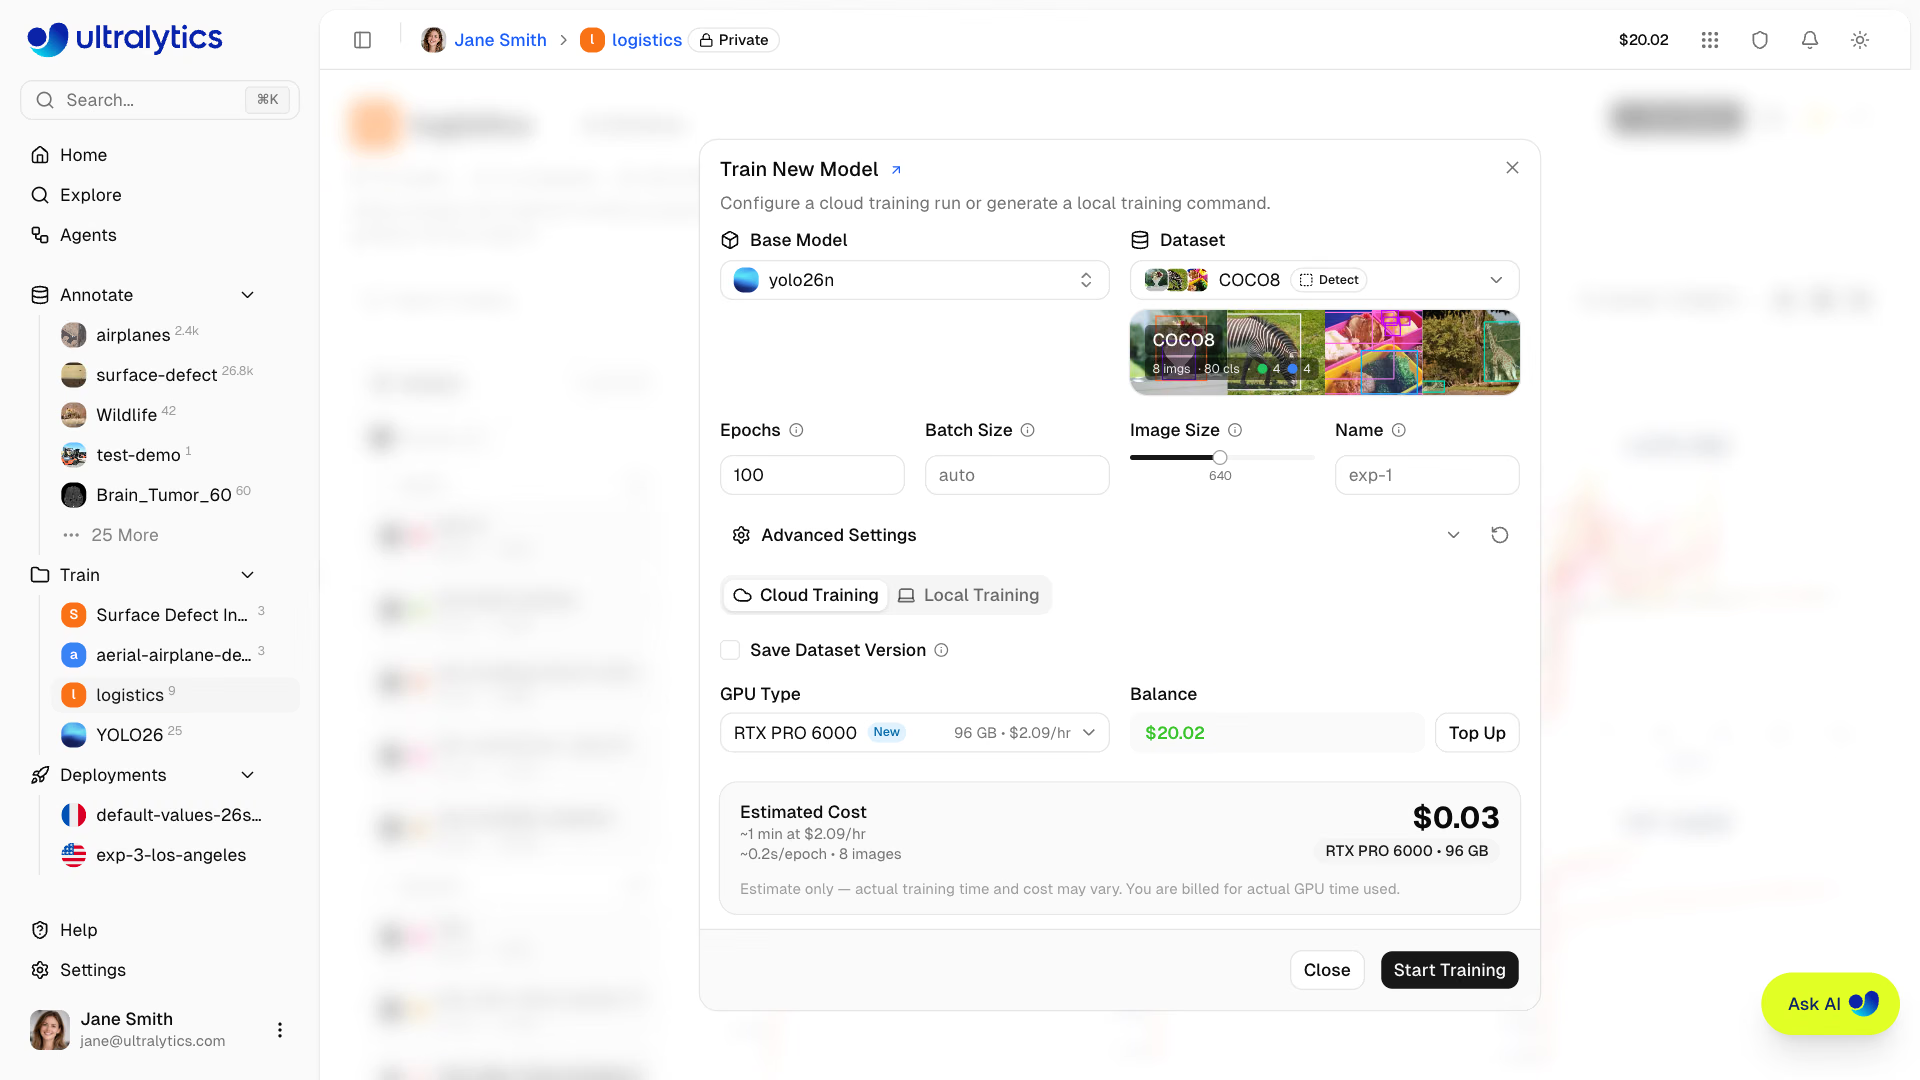
El cuadro de diálogo Train New Model de Ultralytics Platform solicita las mismas opciones que el código de abajo —modelo base, conjunto de datos, épocas y tamaño de imagen— y permite ejecutarlo en GPU en la nube o generar el comando local correspondiente. Estos ajustes se completan en aproximadamente un minuto en la CPU de un portátil:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # preentrenado con COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI y Python son equivalentes. epochs=10 y imgsz=320 mantienen cortas las ejecuciones en CPU; si tienes una GPU, omite ambos y acepta los valores predeterminados (epochs=100, imgsz=640), porque más épocas y píxeles casi siempre ayudan. El modo de entrenamiento ejecuta este bucle por ti:
Lee el registro línea a línea#
Salida real, recortada para mostrar las dos primeras y las dos últimas épocas:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): el valor predeterminadooptimizer=autoha elegido el optimizador y la tasa de aprendizaje por ti.Using 92 train, 23 val images: confirma que estos valores coinciden con tu conjunto de datos. Un número más bajo significa que se han omitido imágenes.GPU_mem 0G: entrenamiento en la CPU. En una GPU verías aquí la memoria en uso;0Gen un equipo con GPU significa que no se está utilizando.- Primera fila de cada época: las tres pérdidas de la partición de entrenamiento, el número de objetos etiquetados en el último lote (
Instances) y el tamaño de imagen. - Fila
allde cada época: precisión, exhaustividad, mAP50 y mAP50-95 en la partición de validación. Esta es la fila que debes vigilar.
| Columna | Significado | Tendencia positiva |
|---|---|---|
box_loss | Distancia entre los cuadros predichos y los cuadros etiquetados | Disminuye y luego se estabiliza |
cls_loss | Grado de error de las puntuaciones de clase | Disminuye y luego se estabiliza |
l1_loss | Error directo de las coordenadas de los cuadros de YOLO26 | Disminuye |
P, R | Precisión y exhaustividad en la partición de validación | Aumentan y se mantienen equilibradas |
mAP50, mAP50-95 | Calidad de detección; la mAP50-95 también recompensa los cuadros ajustados | Aumenta y luego se estabiliza |
En este caso, la mAP50-95 pasó del valor de referencia 0.0002 a 0.548 tras una época y a 0.659 tras diez. La precisión cayó a 0.80 en la época 4 y se recuperó: los resultados de cada época varían mucho con solo 23 imágenes de validación, así que evalúa la tendencia, no una fila aislada. Reglas para decidir mientras la ejecución está en curso:
- Las pérdidas disminuyen y la mAP aumenta: deja que siga.
- Las pérdidas no cambian desde la época 1: detén la ejecución con Ctrl+C y revisa las etiquetas y el YAML.
- La precisión es mucho mayor que la exhaustividad: el modelo es prudente y no detecta algunos objetos. La exhaustividad es mucho mayor que la precisión: detecta cosas que no existen.
- La mAP se mantiene plana durante muchas épocas: más épocas no ayudarán; cambia los datos o
imgsz.
Las tres pérdidas son los componentes de la función de pérdida de YOLO26; la guía de métricas de rendimiento explica cada métrica en profundidad.
Descubre qué ha generado la ejecución#
Todo se guarda en runs/detect/pills_v1/:
| Archivo | Para qué sirve |
|---|---|
weights/best.pt | Checkpoint con el mejor rendimiento de validación a lo largo de las épocas; úsalo para inferencia y exportación |
weights/last.pt | Checkpoint más reciente; se usa para reanudar una ejecución interrumpida |
args.yaml | Todos los argumentos usados en la ejecución, para poder reproducirla |
results.csv, results.png | Pérdidas y métricas de cada época, tanto en datos como en gráficos |
labels.jpg | Histogramas del número de clases y del tamaño y la posición de los cuadros |
train_batch*.jpg | Lotes de entrenamiento aumentados con las etiquetas dibujadas |
val_batch*_labels.jpg, val_batch*_pred.jpg | Verdad de referencia frente a predicciones en imágenes de validación |
confusion_matrix*.png, Box*_curve.png | Matriz de confusión y curvas de precisión, exhaustividad, F1 y PR |
Abre train_batch0.jpg antes que nada. Si los cuadros no encajan sobre los objetos, las etiquetas son incorrectas y ninguna cantidad de épocas lo solucionará.
Cambia primero estos argumentos#
| Parámetro | Predeterminado | Cuándo cambiarlo |
|---|---|---|
epochs | 100 | Experimentos breves en CPU o conjuntos de datos diminutos que empiezan a sobreajustarse (reduce el valor); conjuntos de datos grandes que siguen mejorando (auméntalo, 200–300) |
imgsz | 640 | Objetos pequeños (auméntalo a 1024 o 1280) o experimentos en CPU (redúcelo) |
batch | 16 | Tamaño del lote: redúcelo si se agota la memoria o usa -1 para ajustarlo automáticamente a aproximadamente el 60 % de la memoria de la GPU |
patience | 100 | Detén pronto la ejecución si el rendimiento de validación no mejora durante N épocas; por ejemplo, patience=20 |
device | automático | Fuerza cpu, mps, un índice de GPU como 0 o varios índices, como [0, 1] |
name | train | Siempre: asigna a las ejecuciones un nombre que indique qué ha cambiado |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")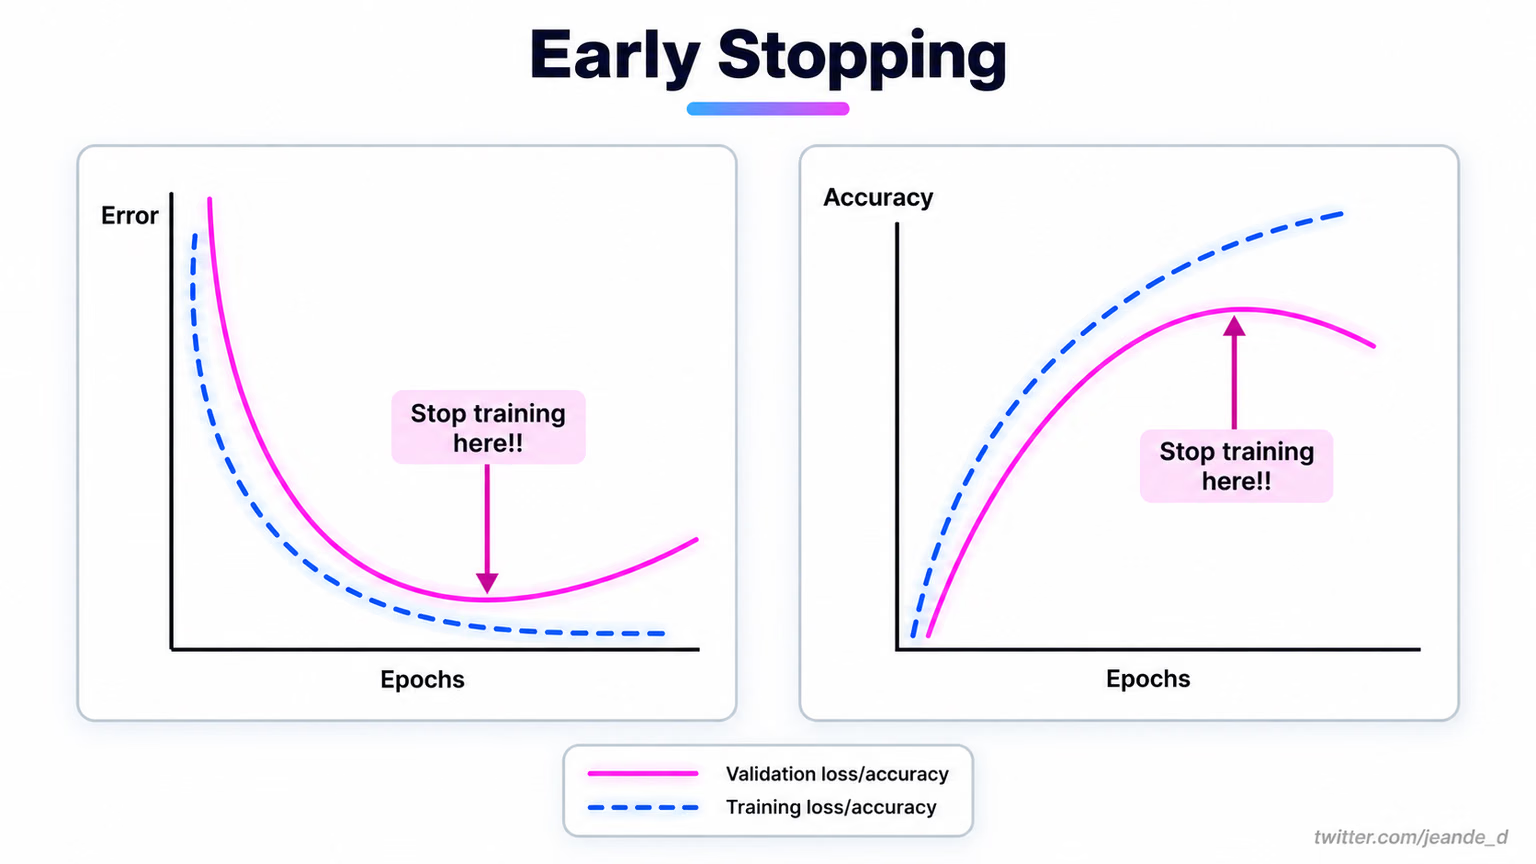
El valor predeterminado patience de 100 significa que una ejecución de 100 épocas nunca se detiene antes de tiempo. Un valor más ajustado termina una ejecución estancada cuando las curvas de arriba indican que debería hacerlo; en cualquier caso, se conserva best.pt.
Si tienes varias GPU, pasa una lista como device=[0, 1, 2, 3]: Ultralytics inicia por ti el entrenamiento distribuido de datos en paralelo (DDP), batch es el total entre todas las GPU y el entrenamiento usa precisión mixta de forma predeterminada (amp=True). Cuando la ejecución supere la capacidad de tu portátil, puedes usar el mismo conjunto de datos y los mismos argumentos en GPU en la nube desde Ultralytics Platform, como se explica en Entrenar, leer y ajustar ejecuciones.
Evita estos errores#
Síntoma: mAP casi nulo tras muchas épocas con un conjunto de datos pequeño. Causa: el modelo procedía de yolo26n.yaml (pesos aleatorios) en lugar de yolo26n.pt. Solución: empieza siempre con un .pt preentrenado. Entrenar desde cero solo compensa para investigar el backbone o con conjuntos de datos muy grandes.
Síntoma: CUDA out of memory en la primera época. Solución: reduce batch a la mitad o establece batch=-1 para que AutoBatch elija un tamaño que quepa. Reducir también imgsz puede ayudar, pero cambia lo que el modelo puede ver.
last.pt es la época final, que puede ser peor que una anterior. best.pt es la época con la mejor aptitud de validación y es la que debes validar, exportar y distribuir.
La guía de consejos para entrenar modelos cubre los argumentos restantes y la guía de ajuste de hiperparámetros explica las búsquedas de tasas de aprendizaje y el optimizador genético. La guía de ajuste fino explica cómo congelar capas.
Mostrar solución
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsLas cifras exactas varían ligeramente según el hardware y la versión del paquete.