Validar y diagnosticar
Valida best.pt frente a una referencia, lee la matriz de confusión, las cifras por clase y las imágenes de predicción, y conviértelas en una lista concreta de correcciones.
Una sola cifra de mAP te indica cuánto se equivoca el modelo, pero no en qué. Los objetos pequeños no detectados, las clases que se confunden entre sí y los cuadros poco ajustados reducen la mAP, y cada problema requiere una solución distinta. Si te equivocas al identificar el problema, puedes pasar una semana recopilando los datos equivocados.
En esta lección, ejecutarás el modo Val en best.pt, lo compararás con la referencia y leerás la matriz de confusión y las imágenes de predicción hasta poder redactar la lista de correcciones para la siguiente ronda. La guía de métricas de rendimiento amplía estos contenidos.
Práctico
Ejemplo práctico: validar best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Salida real de val.py:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
Los gráficos se guardan en una nueva carpeta runs/detect/val (después val-2, etc.). Compara las cifras con la referencia:
| Modelo | mAP50 | mAP50-95 |
|---|---|---|
yolo26n.pt preentrenado (sin clase de píldora) | 0.001 | 0.0002 |
pills_v1 (10 épocas, imgsz 320, CPU) | 0.977 | 0.659 |
Qué dicen los números:
- Precisión 0.970, exhaustividad 0.957: equilibradas. Pocas falsas alarmas y pocos casos sin detectar.
- mAP50 0.977: con un requisito de solapamiento poco estricto, el modelo encuentra casi todas las pastillas.
- mAP50-95 0.659: con un solapamiento estricto, muchas cajas no se ajustan bien. Una diferencia tan grande apunta a un problema de localización —más épocas, un
imgszmás grande o etiquetas más precisas— y no a datos que falten.
Para saber cómo se compensan la precisión, la exhaustividad y mAP, consulta Cómo interpretar correctamente las métricas de detección.
Descubre qué archivo responde a cada pregunta#
| Pregunta | Archivo |
|---|---|
| ¿Qué clases se confunden y cuáles no se detectan? | confusion_matrix_normalized.png |
| ¿Cómo se compensa la precisión de cada clase con la exhaustividad? | BoxPR_curve.png |
| ¿Qué umbral de confianza deberías usar en producción? | BoxF1_curve.png: su valor máximo es un buen conf inicial |
| ¿Qué aspecto tienen los errores? | val_batch0_labels.jpg frente a val_batch0_pred.jpg |
| ¿El modelo está sobreajustado? | results.png en la carpeta de entrenamiento |
Lee la matriz de confusión#
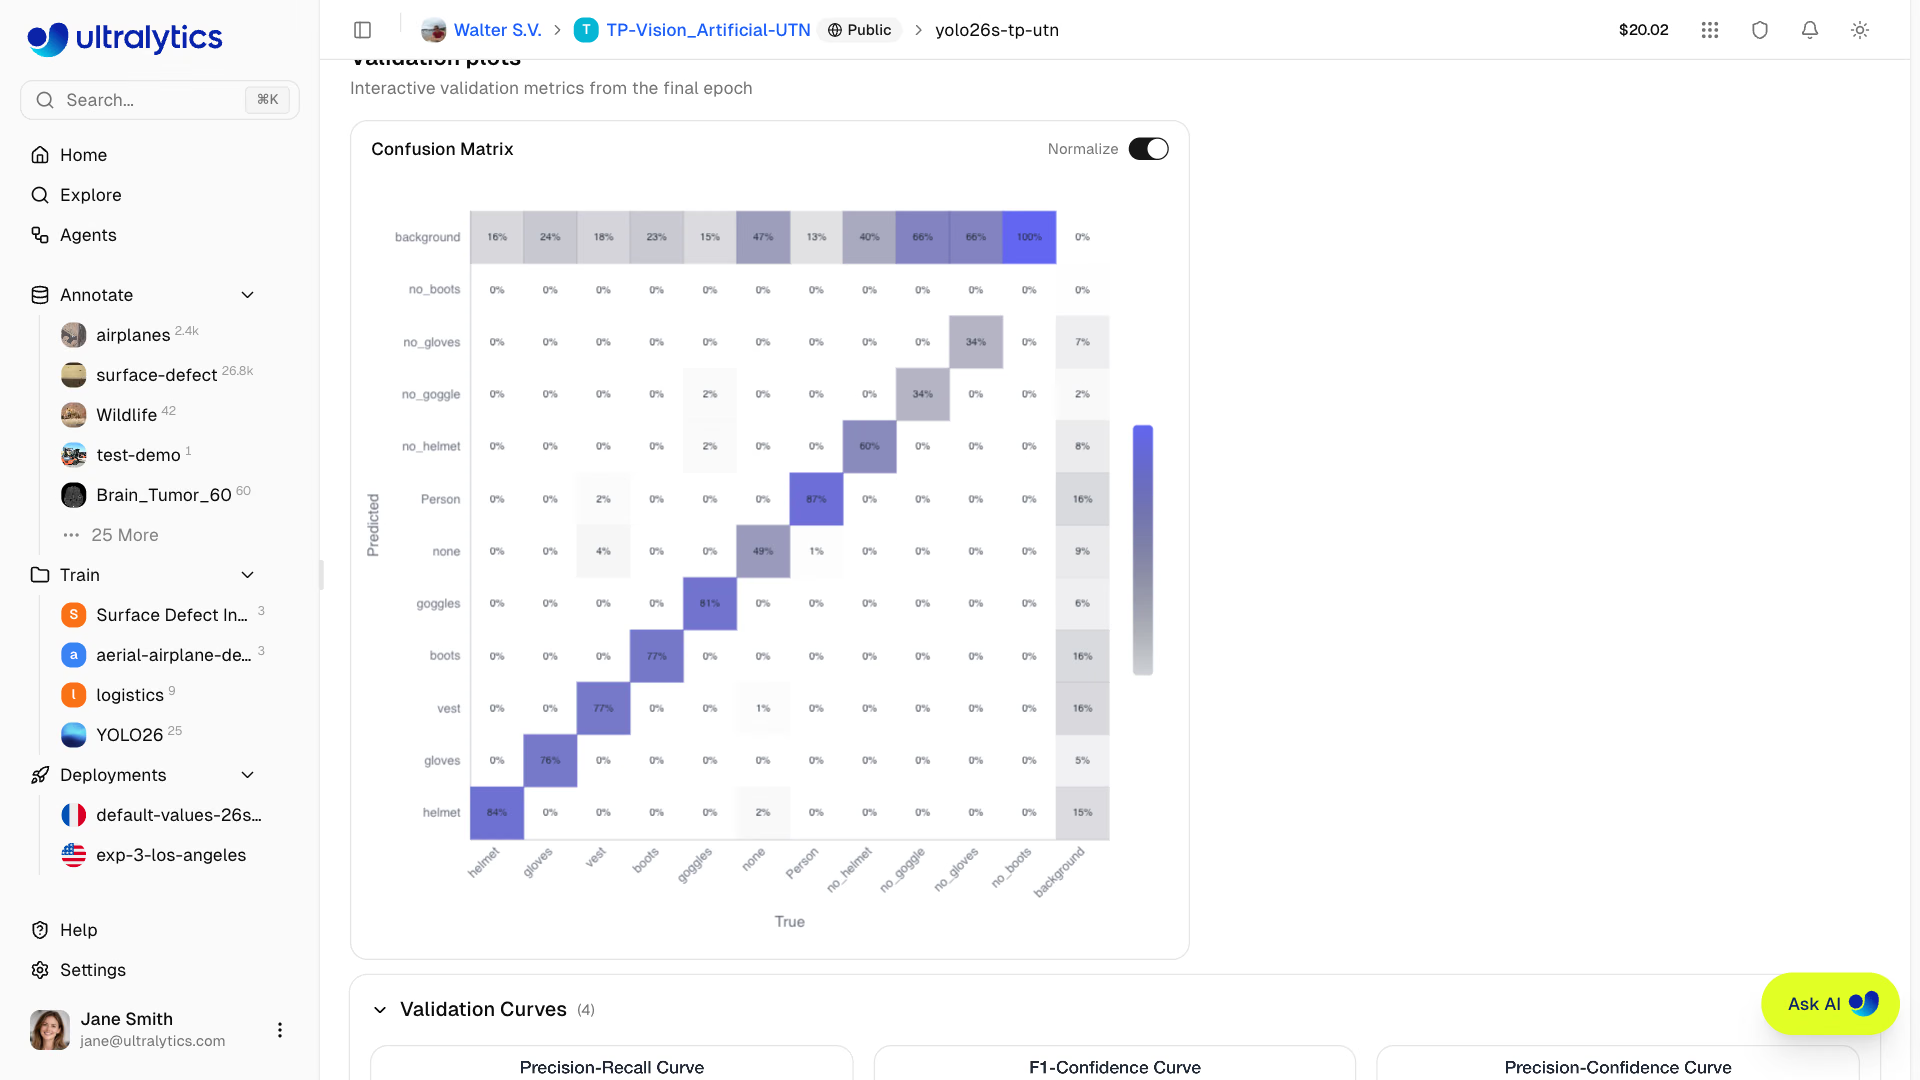
La matriz de confusión es la herramienta de diagnóstico más útil. En los gráficos de Ultralytics, las columnas representan la clase real y las filas, la clase predicha, con una fila y una columna adicionales de background. La versión normalizada divide cada columna por su total, de modo que cada columna muestra qué ha ocurrido con los objetos de esa clase. Pills tiene una sola clase, así que practica con este ejemplo de almacén con tres clases (números ilustrativos):
| Predicción ↓ / Real → | carretilla elevadora | persona | palé | fondo |
|---|---|---|---|---|
| carretilla elevadora | 0.78 | 0.03 | 0.18 | 0.45 |
| persona | 0.04 | 0.91 | 0.00 | 0.20 |
| palé | 0.10 | 0.00 | 0.65 | 0.35 |
| fondo | 0.08 | 0.06 | 0.17 | — |
- Diagonal: proporción de cada clase detectada correctamente. Los palés, con 0.65, son la clase con peores resultados.
- Fuera de la diagonal: confusiones. El 18 % de los palés reales se predijo como carretillas elevadoras, y el 10 % de las carretillas elevadoras, como palés.
- Fila de fondo: casos no detectados. No se detectó el 17 % de los palés.
- Columna de fondo: falsos positivos; cajas dibujadas en espacios vacíos. El 45 % de esos casos se clasificó como carretillas elevadoras.
Cada tipo de celda se corresponde con una solución:
| Situación | Solución |
|---|---|
| Dos clases se confunden entre sí | Añade ejemplos que permitan distinguirlas: carretillas elevadoras que transportan palés y palés apilados junto a carretillas elevadoras. |
| Fila de fondo alta (casos no detectados) | Más ejemplos de esa clase en las condiciones en las que no se detecta |
| Columna de fondo alta (falsas alarmas) | Imágenes de fondo de las escenas que las provocan, como pasillos vacíos |
Lee los datos de cada clase#
Con varias clases, el registro de validación muestra una fila por clase y metrics.box.maps contiene mAP50-95 por clase para el código. Sigamos con el ejemplo del almacén:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet está muy por debajo de los demás y solo tiene 7 instancias en validación. Puede que el modelo no detecte bien los palés o que haya muy pocos datos de validación para saberlo. En ambos casos, el siguiente paso es el mismo: recopila más palés para entrenamiento y validación.
Examina los errores#
Abre val_batch0_labels.jpg y val_batch0_pred.jpg uno al lado del otro. Las diferencias muestran tus errores en imágenes, y los patrones que aparezcan en ellas te ayudarán a diagnosticarlos: casos no detectados en el borde de la imagen, objetos pequeños, una condición de iluminación concreta o un objeto parecido que cause confusión. Los patrones del conjunto de datos suelen ser más importantes que ajustar los hiperparámetros.
En las imágenes de validación del modelo de pastillas, las pastillas claramente visibles obtienen una puntuación cercana a 1.0. Las cajas de baja confianza, de alrededor de 0.3–0.5, se agrupan en pastillas parcialmente ocultas bajo otro blíster y en pastillas cortadas por el borde de la imagen. No es algo que puedas solucionar ajustando conf; es una cuestión de política de etiquetado. ¿Debe contar una pastilla medio oculta? Decide, deja la regla por escrito y etiqueta todas las imágenes de la misma manera.
Después, abre results.png. Las pérdidas de entrenamiento y validación deberían disminuir a la vez. Si la pérdida de entrenamiento sigue bajando mientras la de validación aumenta, el modelo está sobreajustado; si ambas se mantienen altas, está infraajustado. El compromiso entre sesgo y varianza ayuda a entender ambos casos.
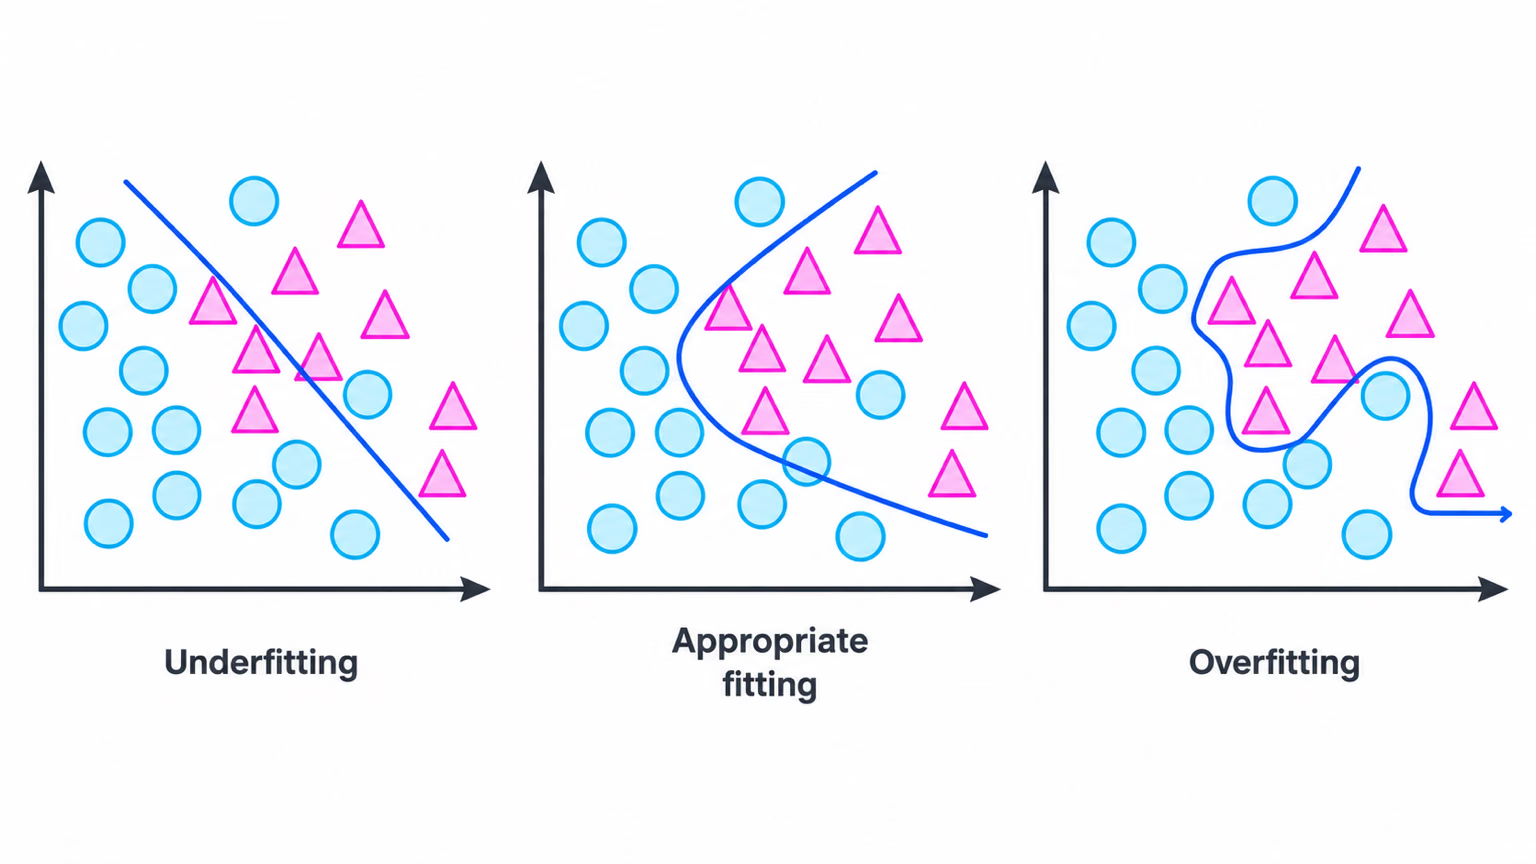
Para corregir el sobreajuste, prueba estas soluciones en este orden, de la más eficaz a la menos habitual: más variedad de datos; menos épocas o un patience más ajustado; y aumento de datos (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). Los valores predeterminados del aumento de datos ya son eficaces; cámbialos solo si tienes un motivo, como desactivar fliplr cuando la izquierda y la derecha sean importantes.
Convierte los resultados en una lista de cambios#
Corrige los datos antes de ajustar los hiperparámetros y cambia una sola cosa en cada ronda para saber qué ha funcionado. En Primera fase de ajuste y ciclo de iteración se explica la parte de este ciclo relacionada con el conjunto de datos.
Evita estos errores#
Síntoma: un modelo que obtuvo 0.659 mAP50-95 pasa de repente a 0.403. Causa: pills_v1 se entrenó con imgsz=320 y se validó con imgsz=640; los objetos aparecen el doble de grandes que cualquier cosa que haya aprendido. Solución: valida y despliega con el imgsz del entrenamiento y compara las ejecuciones solo con el mismo tamaño.
La validación se ejecuta con conf=0.001 para poder trazar toda la curva precisión-recall; por eso val_batch0_pred.jpg muestra cuadros que tu aplicación nunca mostraría. Elige el umbral de despliegue a partir de BoxF1_curve.png y compruébalo con predict.
Con 23 imágenes, la precisión de una época pasó de 0,93 a 0,80 y volvió a subir. Evalúa las tendencias entre épocas y ejecuciones, y amplía el conjunto de validación antes de fiarte de diferencias de uno o dos puntos.
Mostrar solución
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.