Interpretar correctamente las métricas de detección
Ejecuta la validación, analiza la precisión, la exhaustividad, mAP50-95, AP por clase y la matriz de confusión, y elige un umbral para producción a partir de un objetivo.
Una sola cifra tranquiliza: mAP 0,83, y listo. Pero esa misma mAP puede ocultar una clase que falla la mitad de las veces, cajas sistemáticamente imprecisas o un umbral que envía una alerta cada minuto. Ejecutarás una validación real y la analizarás línea por línea hasta que te indique qué debes corregir y dónde establecer el umbral.
Práctico
Cómo se puntúa cada predicción#
Durante la validación, cada caja predicha se compara con la verdad terreno. Una predicción es un verdadero positivo (TP) si tiene la clase correcta y su IoU con una caja de verdad terreno aún no emparejada supera un umbral; de lo contrario, es un falso positivo (FP). Cada objeto de verdad terreno que queda sin emparejar es un falso negativo (FN).
| Métrica | Fórmula | Pregunta a la que responde |
|---|---|---|
| Precisión | TP / (TP + FP) | Cuando el modelo dibuja una caja, ¿con qué frecuencia acierta? |
| Exhaustividad | TP / (TP + FN) | De todos los objetos reales, ¿cuántos encontró? |
| F1 | 2 × P × R / (P + R) | Una cifra que equilibra ambas |
Al reducir el umbral de confianza, se añaden cajas: aumenta la exhaustividad y disminuye la precisión. La curva precisión-exhaustividad representa ese equilibrio para todos los umbrales, y el área bajo la curva es la precisión media (AP) de una clase. mAP50 calcula la media del AP de todas las clases con un IoU de 0,5, donde una caja claramente imprecisa sigue contando. mAP50-95 calcula la media con diez umbrales de IoU entre 0,5 y 0,95, por lo que recompensa las cajas ajustadas; es la cifra principal de las tablas de modelos de Ultralytics.
Ejecuta una validación#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml")

print(f"precision={metrics.box.mp:.3f} recall={metrics.box.mr:.3f}")
print(f"mAP50={metrics.box.map50:.3f} mAP50-95={metrics.box.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 4 17 0.551 0.962 0.943 0.669
person 3 10 0.551 0.8 0.848 0.387
dog 1 1 0.36 1 0.995 0.597
horse 1 2 0.36 1 0.995 0.696
elephant 1 2 0.656 0.969 0.828 0.545
umbrella 1 1 0.543 1 0.995 0.895
potted plant 1 1 0.833 1 0.995 0.895Léela de arriba abajo:
- Instancias 17, imágenes 4. COCO8 sirve para una prueba rápida. Cuatro imágenes no bastan para decidir si publicar el modelo; interpreta todas las cifras como ejemplos.
- mAP50 0,943 frente a mAP50-95 0,669. Se encuentran la mayoría de los objetos, pero muchas cajas son imprecisas. Una diferencia grande indica que el punto débil es la localización, no la detección.
- AP50-95 de
person: 0,387. La clase más común es la más débil. Ese es tu cuello de botella. - P 0,551, R 0,962. Estas columnas se leen en el nivel de confianza único que maximiza F1 entre todas las clases —un umbral bajo en este caso—, no en el 0,25 con el que haces predicciones. No las cites como «la precisión del modelo».
AP por clase y umbral para producción#
La misma ejecución incluye el AP por clase y la precisión y la exhaustividad para cada umbral de confianza, así que puedes elegir un umbral según un objetivo en lugar de hacer una suposición:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml", plots=False, verbose=False)
box = metrics.box

# Per-class AP from the same run: the average hides the weakest class
for i, c in enumerate(box.ap_class_index):
    print(f"{model.names[int(c)]:13} AP50={box.ap50[i]:.3f}  AP50-95={box.ap[i]:.3f}")

# Precision and recall at every confidence threshold for one class
row = list(box.ap_class_index).index(0)  # class 0 = person
for conf in (0.1, 0.25, 0.5, 0.75):
    j = int(conf * (len(box.px) - 1))
    print(f"person @ conf {conf:.2f}: precision {box.p_curve[row, j]:.2f}, recall {box.r_curve[row, j]:.2f}")
all 4 17 0.551 0.962 0.943 0.669
person AP50=0.848 AP50-95=0.387
dog AP50=0.995 AP50-95=0.597
horse AP50=0.995 AP50-95=0.696
elephant AP50=0.828 AP50-95=0.545
umbrella AP50=0.995 AP50-95=0.895
potted plant AP50=0.995 AP50-95=0.895
person @ conf 0.10: precision 0.63, recall 0.80
person @ conf 0.25: precision 1.00, recall 0.54
person @ conf 0.50: precision 1.00, recall 0.40
person @ conf 0.75: precision 1.00, recall 0.14Ahora el umbral es una regla de decisión, no una corazonada:
| Objetivo según tu criterio de decisión | Elige | En esta ejecución |
|---|---|---|
| Como máximo, el 5 % de las alertas pueden ser falsas (precisión ≥ 0,95) | El umbral más bajo que lo cumple, para conservar la máxima exhaustividad | 0,25: precisión 1,00, exhaustividad 0,54 |
| No omitas a más de 1 de cada 5 personas (exhaustividad ≥ 0,80) | El umbral más alto que lo cumple, para conservar la máxima precisión | 0,10: precisión 0,63, exhaustividad 0,80 |
Ninguna de las dos opciones es suficientemente buena en este caso: una precisión alta deja fuera a la mitad de las personas, y una exhaustividad alta genera un tercio de alertas. Eso justifica «iterar»; no es un problema de umbral. La validación también guarda BoxPR_curve.png, BoxP_curve.png, BoxR_curve.png, BoxF1_curve.png y confusion_matrix.png en la carpeta de ejecución, para que puedas observar el mismo equilibrio en los gráficos; la guía de métricas de rendimiento explica cada una.
Qué corregir a continuación#
La matriz de confusión te indica con qué se confunde una clase débil. Si el AP de forklift es bajo y las carretillas elevadoras se predicen como pallet_jack, se trata de una confusión entre clases, no de un problema de localización: añade ejemplos que muestren la diferencia visual o combina las clases si ningún código posterior necesita distinguirlas. La guía de análisis de evaluación de modelos explica el flujo de trabajo.
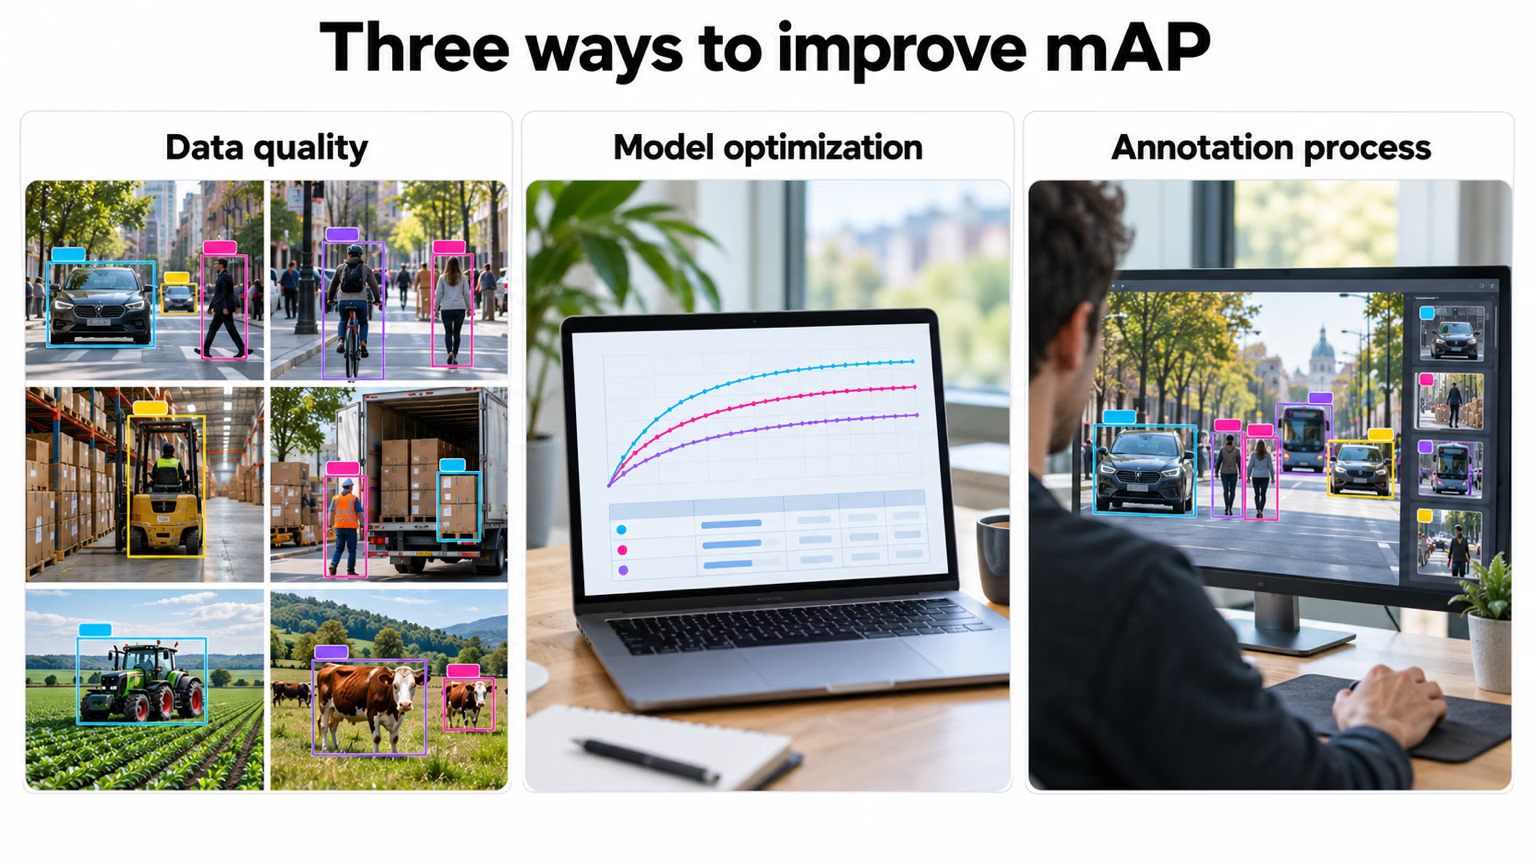
La mayoría de las mejoras corresponden al primer y al tercer panel: mejores datos y mejores etiquetas para la clase limitante. Cambia el modelo o los parámetros de entrenamiento solo después de superar las comprobaciones de datos de las tres lecciones anteriores.
| Evidencias en un conjunto de prueba congelado | Decisión |
|---|---|
| Todas las clases críticas para el negocio cumplen sus objetivos de precisión y exhaustividad | Publica el modelo y supervisa su rendimiento |
| Una clase o condición no alcanza su objetivo | Itera: recopila datos y etiquetas específicos para cubrir esa carencia |
| Todas las clases están muy lejos del objetivo o se solapan visualmente | Replantea la especificación de la tarea, las clases o la configuración de la cámara |
Errores habituales#
Un mAP de 0,83 puede ocultar una clase con 0,40. Si esa clase aporta valor al negocio, no tienes un modelo con 0,83: tienes un modelo defectuoso con una media engañosamente favorable.
Síntoma: un modelo que «obtiene 0,94» dibuja cajas demasiado holgadas para medir o recortar. Solución: informa de mAP50-95 e interpreta la diferencia respecto a mAP50 como una señal de localización.
Síntoma: resultados aparentemente perfectos con unas pocas decenas de imágenes o con imágenes casi idénticas a las del conjunto de entrenamiento. Solución: amplía la validación hasta alcanzar unos cientos de instancias por clase importante y ejecuta la comprobación de casi duplicados de la lección anterior antes de consultar cualquier métrica.
Mostrar solución
Informe: contador de personas en yolo26n.pt, validación con COCO8
El cuello de botella es person, con un AP50-95 de 0.387 frente a un 0.669 global. También es la clase con más instancias (10 de 17), así que es tanto la más débil como la más importante para un contador de personas. Su AP50 es 0.848, por lo que el modelo detecta a la mayoría de las personas, pero dibuja cajas poco ajustadas; esto importa menos para contar que para cualquier tarea que mida la posición o el tamaño.
Para una precisión ≥ 0.95, el umbral más bajo que cumple el requisito es conf 0.25, con una precisión de 1.00, pero una exhaustividad de solo 0.54: el contador no detectaría a casi la mitad de las personas. Para una exhaustividad ≥ 0.80 necesitaríamos conf 0.10, donde un tercio de los recuentos serían falsos.
Decisión: iterar. Recopila y etiqueta imágenes de personas tomadas con la cámara de despliegue, sobre todo personas pequeñas, ocluidas y situadas en los bordes del encuadre; después, vuelve a validar con un conjunto de prueba congelado de unos cientos de personas. Cuatro imágenes de validación no bastan para decidir si se puede desplegar.