Cajas frente a máscaras: cuándo necesitas realmente la segmentación
Mide qué aporta una máscara respecto a una caja en una imagen real y decide, según el consumidor posterior, si tu proyecto necesita conocer la forma.
Las máscaras son lo que la mayoría imagina al pensar en visión artificial y también donde los equipos gastan más presupuesto de etiquetado. Una máscara indica la forma exacta de un objeto; una caja solo indica dónde está. Esa diferencia es decisiva para algunos productos y no cambia nada en la mayoría.
Práctico
Qué aporta una máscara#
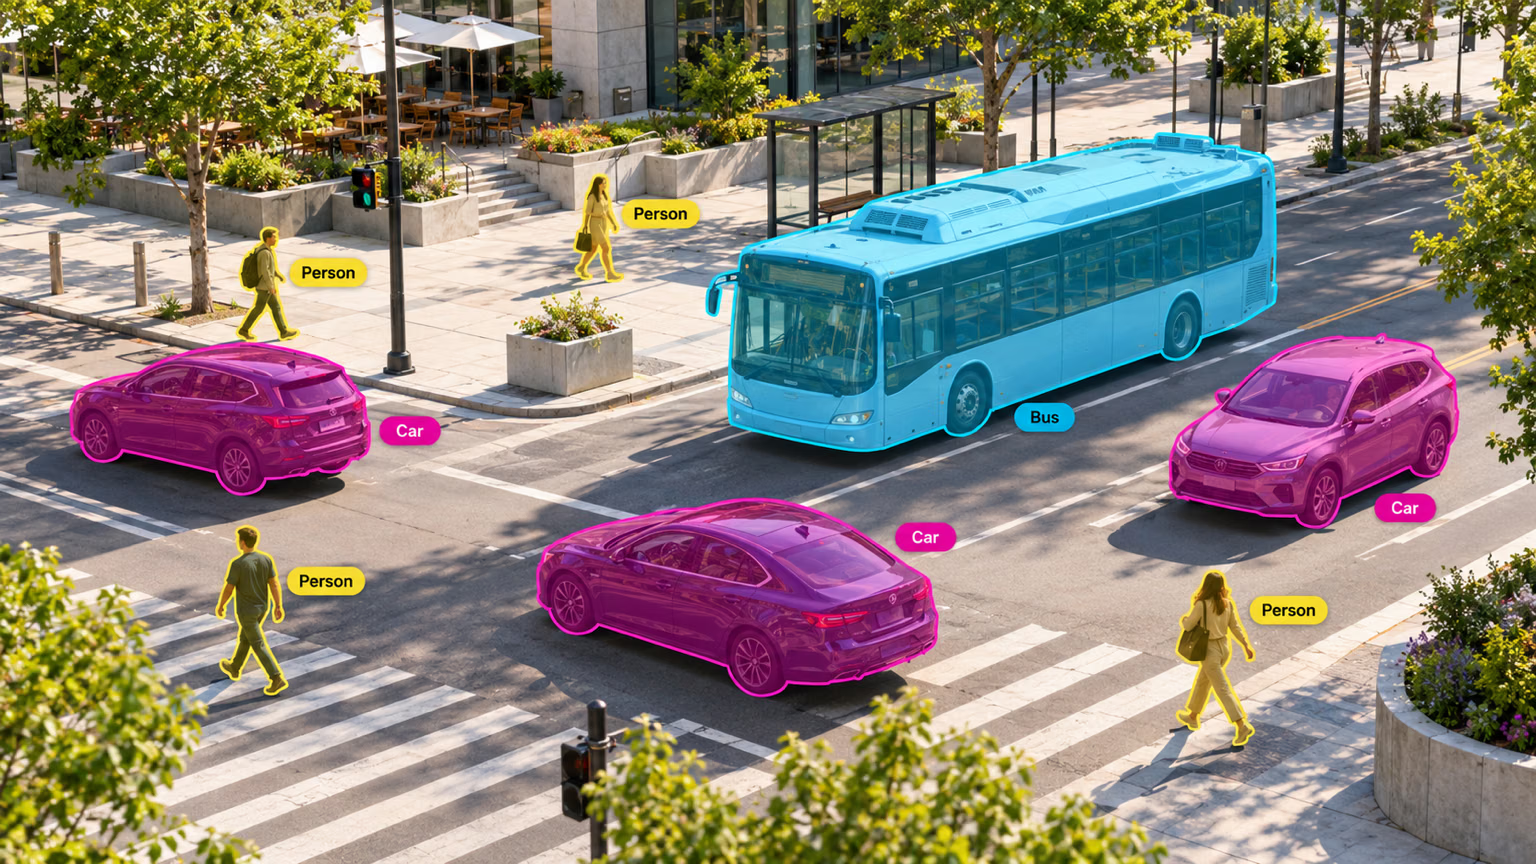
Para cada objeto, la tarea Segment devuelve todo lo que devuelve un detector —clase, caja y confianza—, además de los píxeles que pertenecen al objeto. Así, cada coche de arriba tiene su propio contorno, separado del autobús y de las personas. Lee la máscara como un polígono (masks.xy) o como una imagen binaria (masks.data).
¿Cuánto cambia la forma las cifras? Compara el área de la caja de cada objeto con el área de su máscara:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)El autobús ocupa solo el 62 % de su caja y una persona ocupa el 31 %. Cualquier cifra calculada únicamente a partir de cajas —superficie pintada, tamaño de un derrame o cuánto espacio vacío queda en una estantería— tendría ese margen de error. Si tu producto informa de una cifra así, necesitas máscaras. Si solo cuenta o localiza objetos, los píxeles adicionales no cambian nada.
Síntoma: áreas de máscara que parecen entre 3 y 4 veces demasiado pequeñas junto a las áreas de las cajas. Causa: de forma predeterminada, masks.data devuelve el tamaño de inferencia (aquí, 640×480), mientras que las cajas están expresadas en píxeles de la imagen original (1080×810). Solución: pasa retina_masks=True, como antes, o escala los recuentos manualmente.
Decide según quién consume el resultado, no según la demostración#
| Necesidad posterior | ¿Bastan las cajas? | Por qué |
|---|---|---|
| Contar objetos o comprobar si están presentes | Sí | La ubicación es toda la respuesta |
| Enviar una alerta cuando un objeto entre en una zona | Sí | Basta con que una caja cruce una línea |
| Seguir objetos entre fotogramas | Sí | Los sistemas de seguimiento asocian cajas |
| Recortar para un segundo clasificador | Sí | Para recortar, solo hace falta la caja |
| Medir el área o la cobertura (malas hierbas, óxido, derrames) | No | Las formas irregulares hacen que el área de la caja no tenga sentido |
| Recortar el objeto (eliminar el fondo, realidad aumentada) | No | Necesitas el borde exacto |
| Comprobar la distancia libre o el contacto (agarre robótico, colisión) | No | La caja abarca más que el objeto |
| Separar objetos irregulares que se tocan | A menudo, no | Las cajas superpuestas difuminan qué píxeles pertenecen a cada objeto |
Si todas las filas que necesita tu producto indican «sí», usa un detector. Recurre a la segmentación de YOLO26 solo cuando la forma aporte un valor real.
Segmentación de instancias frente a segmentación semántica#
La segmentación de instancias asigna una máscara propia a cada objeto, así que tres coches superpuestos siguen siendo tres coches. La segmentación semántica asigna una clase a cada píxel y nada más: todos los píxeles de los coches forman una única región «coche» y se pierde el recuento. Usa la segmentación de instancias para contar o medir objetos individuales —células, fruta o defectos—. Usa la segmentación semántica para medir la cobertura de una región —calzada frente a acera, cultivo frente a suelo—.
Cuánto cuesta etiquetar la forma#
Una caja requiere dos clics. Un buen polígono puede requerir docenas, y cada borde es un posible motivo de desacuerdo entre anotadores: ¿la bolsa pertenece a la persona?, ¿la sombra forma parte del coche? Mide tu coste real en lugar de fiarte de una regla general: cronometra a un anotador etiquetando 20 objetos con cajas y los mismos 20 con polígonos, y después multiplica la diferencia por el tamaño de tu conjunto de datos.
Las herramientas asistidas por IA reducen gran parte de la diferencia. La anotación inteligente y el etiquetado por lotes propone una máscara a partir de un clic o una caja, así que los anotadores corrigen los bordes en vez de trazarlos; aun así, alguien debe revisar todos los contornos.
Decide cómo tratar las oclusiones, los objetos transparentes, las sombras, los objetos cortados por el borde del fotograma y los elementos adheridos (bolsos, asas, cargas) antes de empezar a etiquetar, y entrega la misma página a los anotadores y revisores. Buenas prácticas de anotación explica cómo aplicarlas; el conjunto de datos COCO-Seg muestra máscaras coherentes a gran escala.
Al revisar las máscaras por muestreo, busca desbordamientos (la máscara se sale del borde), huecos (zonas del interior del objeto que no se han incluido), bordes fantasma (la máscara sigue un artefacto JPEG) y partes ambiguas (¿el asa de la maleta forma parte de la máscara de la maleta?).
Mostrar solución
Supón que dos productos comparten la cámara del autobús: un contador de personas y un informe de ocupación de la calle que indica qué parte de la escena ocupan los vehículos. Mide ambas respuestas con la misma ejecución:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- Contador de personas → cajas. El recuento es 4 en ambos casos; las máscaras añaden coste de etiquetado y no cambian nada.
- Informe de ocupación → máscaras. Las cajas indican que el autobús ocupa el 47 % de la escena, pero en realidad ocupa el 29 %. Un informe basado en cajas tendría un error superior al 50 %.