Conjuntos de datos que reflejan la realidad
Audita un conjunto de datos real para detectar carencias de cobertura antes de etiquetar más datos y convierte esas carencias en un plan de recopilación con negativos difíciles.
La mayoría de los modelos de visión que decepcionan no son malos modelos: son buenos modelos entrenados con un conjunto de datos que no se parece al lugar donde se despliegan. El detector de COCO de la lección anterior no encontró barcos vistos desde un dron porque los barcos de COCO se fotografían de lado. Una auditoría de cinco minutos permite detectar esas carencias antes de gastar dinero en etiquetas.
Práctico
Los modelos aprenden del conjunto de datos, no del mundo#
Un modelo interpola entre los ejemplos que ha visto. Entrénalo con calles soleadas de día y despliégalo en un garaje con niebla por la noche, y fallará; no porque los coches tengan otro aspecto, sino porque nunca ha visto un coche en esas condiciones. Esta discrepancia se llama cambio de dominio, y la validación no puede avisarte cuando sus imágenes proceden de la misma recopilación sesgada:
La solución es estructural, no algorítmica: toma muestras del entorno de despliegue de forma deliberada, antes de etiquetarlas. La guía sobre recopilación y anotación de datos explica cómo hacerlo.
Audita un conjunto de datos real#
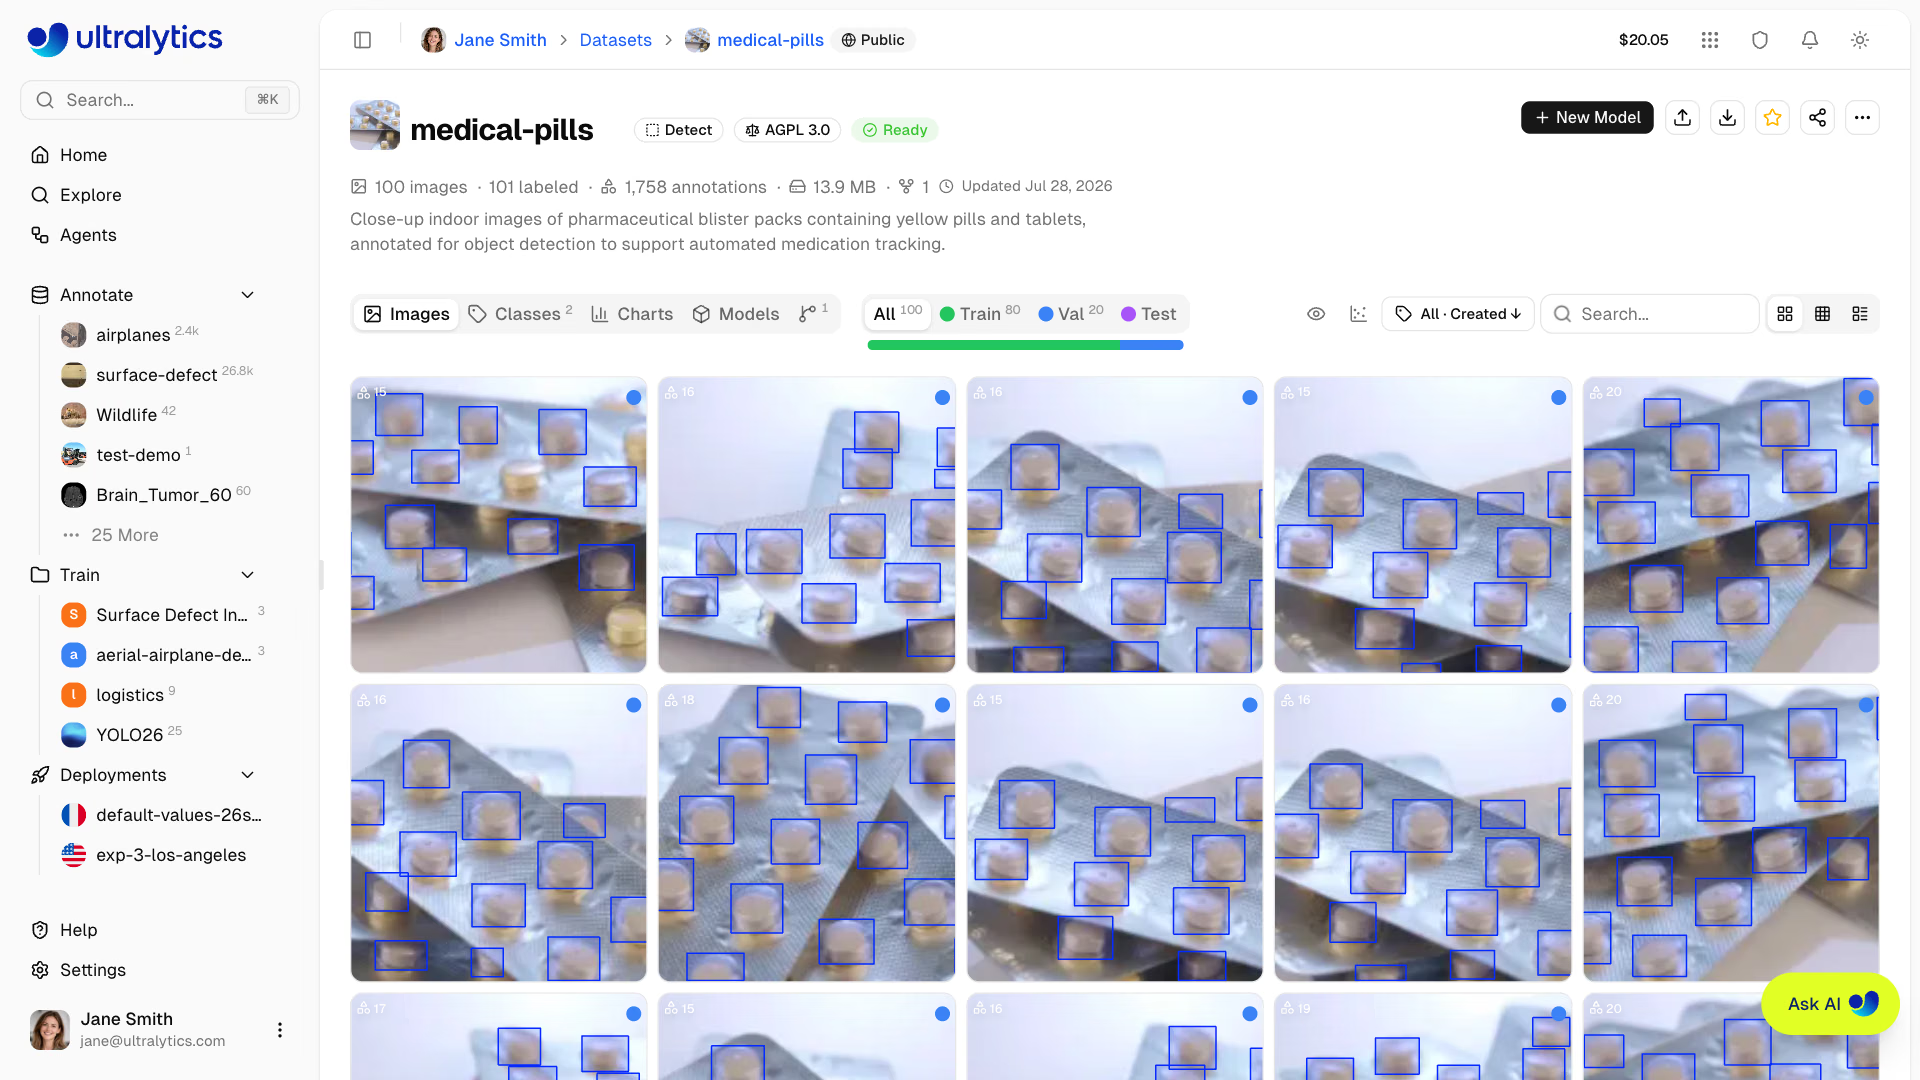
El conjunto de datos medical-pills de arriba —primeros planos de blísteres con una caja alrededor de cada pastilla— es un buen ejemplo para auditar. Ultralytics Platform muestra los recuentos principales en la página del conjunto de datos; el siguiente script calcula las cifras que revelan la cobertura en la copia que se distribuye con ultralytics:
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)Interprétalo como un informe de cobertura, con un hallazgo por línea:
| Hallazgo | Qué significa | Decisión |
|---|---|---|
| Una resolución: 1920×1080 | Una cámara y una configuración | Recopila imágenes con todos los modelos de cámara que vayas a usar en producción |
| Brillo entre 171 y 198 únicamente | Iluminación de estudio brillante y uniforme, sin zonas tenues | Recopila imágenes con poca luz, a contraluz y con iluminación mixta antes de desplegar el modelo en el mostrador de una farmacia |
| 0 imágenes de fondo | El modelo nunca ve una escena sin pastillas | Añade blísteres vacíos, otros comprimidos y mostradores vacíos como negativos difíciles |
| La caja mediana ocupa el 1,4 % de la imagen; 1 de cada 5 cajas ocupa menos del 1 % | Objetos pequeños | Mantén imgsz lo bastante alto e incluye deliberadamente imágenes tomadas desde lejos |
Una clase: pill | Sin tipos de pastillas | Es suficiente para contar; añade clases solo si una decisión las necesita |
Nada de esto aparece en la puntuación de validación, porque la validación comparte todas estas características.
Los cuatro ejes de la cobertura#
| Eje | Qué recopilar | Fallo habitual si falta |
|---|---|---|
| Iluminación | Amanecer, mediodía, atardecer, noche, deslumbramientos, contraluz y fluorescentes parpadeantes | La sensibilidad se desploma durante los cambios de turno o bajo la luz solar directa |
| Tiempo y condiciones atmosféricas | Lluvia, niebla, nieve, polvo y condensación en la lente | Falsos positivos con las gotas y detecciones fallidas con la neblina |
| Oclusiones y desorden visual | Objetos objetivo parcialmente ocultos, escenas abarrotadas y objetos cortados por el borde del encuadre | No detecta el objeto objetivo cuando no está completamente visible |
| Cámara y punto de vista | Lente, altura y ángulo de montaje, resolución, compresión y desenfoque por movimiento | Funciona con la cámara piloto, pero falla en la siguiente instalación |
El punto de vista es el eje que no se tuvo en cuenta en el ejemplo del puerto deportivo: misma clase desde un ángulo nuevo y la sensibilidad cayó a cero.
Negativos difíciles e imágenes de fondo#
Un detector también debe aprender qué no es el objeto objetivo. Los negativos difíciles se parecen superficialmente al objeto: para un detector de carretillas elevadoras, una transpaleta, una plataforma de tijera, el reflejo de una carretilla elevadora en un suelo pulido o un cartel de seguridad con la imagen de una carretilla elevadora.
En el formato YOLO, una imagen de fondo es simplemente una imagen sin archivo de etiquetas: no hay nada que dibujar. Los consejos de entrenamiento de Ultralytics recomiendan que aproximadamente entre un 0 y un 10 % de las imágenes sean de fondo para reducir los falsos positivos; COCO tiene alrededor de un 1 %. Completa ese porcentaje con negativos difíciles de tu propio entorno en vez de fotogramas vacíos aleatorios. El aumento de datos puede variar el brillo y el ángulo, pero no puede inventar una transpaleta que el modelo nunca ha visto.
Errores habituales#
Síntoma: 10 000 imágenes etiquetadas, todas diurnas y de la cámara piloto. Solución: graba con las cámaras de despliegue durante un par de semanas y en toda la variedad de condiciones, audita la cobertura y después paga las etiquetas. Los datos sintéticos pueden cubrir una carencia conocida, pero no sustituyen las capturas reales.
Síntoma: mAP de validación alto, pero malos resultados en la primera ubicación nueva. Solución: recuerda que la validación comparte los puntos ciegos del conjunto de datos. Elige diez imágenes de entrenamiento al azar y diez fotogramas de producción, y pide a un compañero que los distinga; si puede hacerlo, tienes una brecha de dominio.
Para un plan de muestreo con cantidades objetivo por condición, continúa con Recopilar datos representativos de alta calidad en Crear conjuntos de datos YOLO de alto rendimiento.
Mostrar solución
Para medical-pills, desplegado en el mostrador de una farmacia con iluminación mixta, completa la cuadrícula a partir de la auditoría (brillo de 171–198, una fuente de 1920×1080, cero fondos) y de un vistazo rápido a las imágenes, que muestra los mismos envases sobre la misma superficie luminosa y sin manos:
| Clase | Luz de estudio intensa | Luz tenue o cálida de tienda | Contraluz / reflejos | Parcialmente tapado por una mano | Cámara de móvil |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| fondo | 0 | 0 | 0 | — | 0 |
Plan de recopilación por orden de prioridad:
- Luz tenue o cálida de tienda — la condición normal del mostrador, con cero imágenes actualmente.
- Parcialmente tapado por una mano — ocurre en casi todas las interacciones reales.
- Cámara de móvil — un segundo sensor y resolución.
- Contraluz / reflejos — los envases de aluminio reflejan las ventanas y las luces del techo.
Negativos difíciles: blísteres vacíos (mismo aluminio, sin pastillas) y otros objetos redondos sobre el mostrador — monedas, botones, caramelos. Añádelos como imágenes de fondo, alrededor del 5–10 % del conjunto de datos.