Define el problema
Convierte una idea de producto imprecisa en una especificación de tarea de tres líneas y mantén la regla de negocio en el código para poder cambiarla sin volver a entrenar.
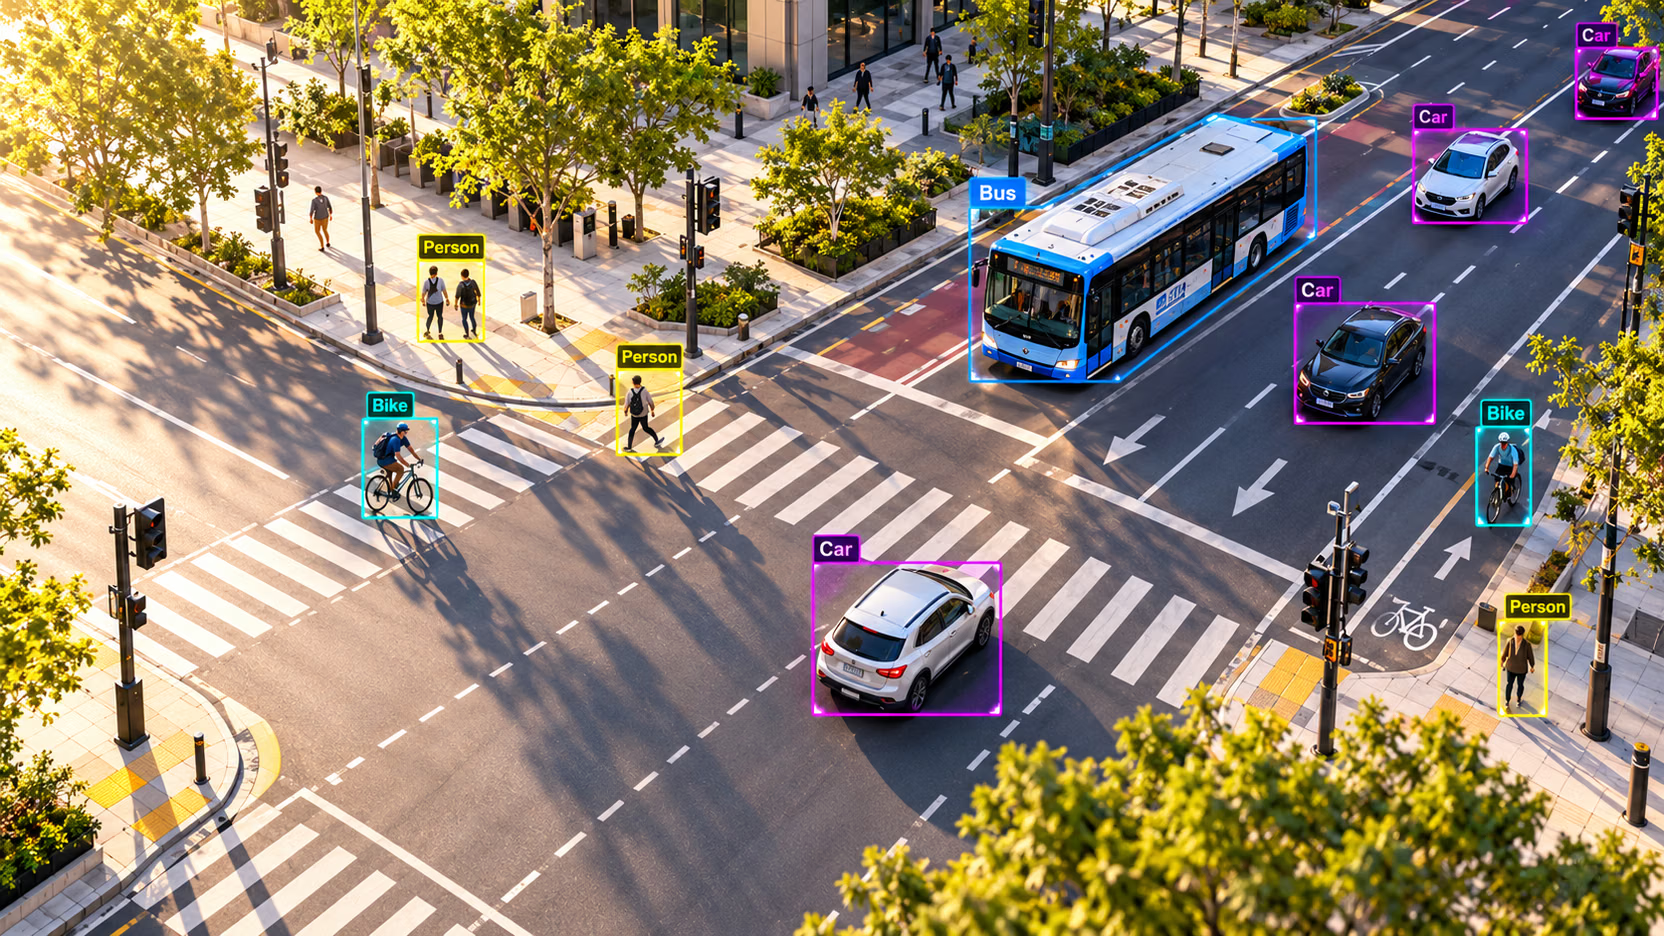
La mayoría de los proyectos de visión artificial que se estancan nunca tuvieron una pregunta clara. «Detectar comportamientos peligrosos» parece un requisito, pero un anotador no puede etiquetarlo, un modelo no puede aprenderlo y nadie puede saber cuándo funciona. Una especificación de tres líneas lo resuelve en una tarde y determina qué tarea entrenas, qué etiquetas usas y qué métrica presentas.
Práctico
Por qué la especificación va primero#
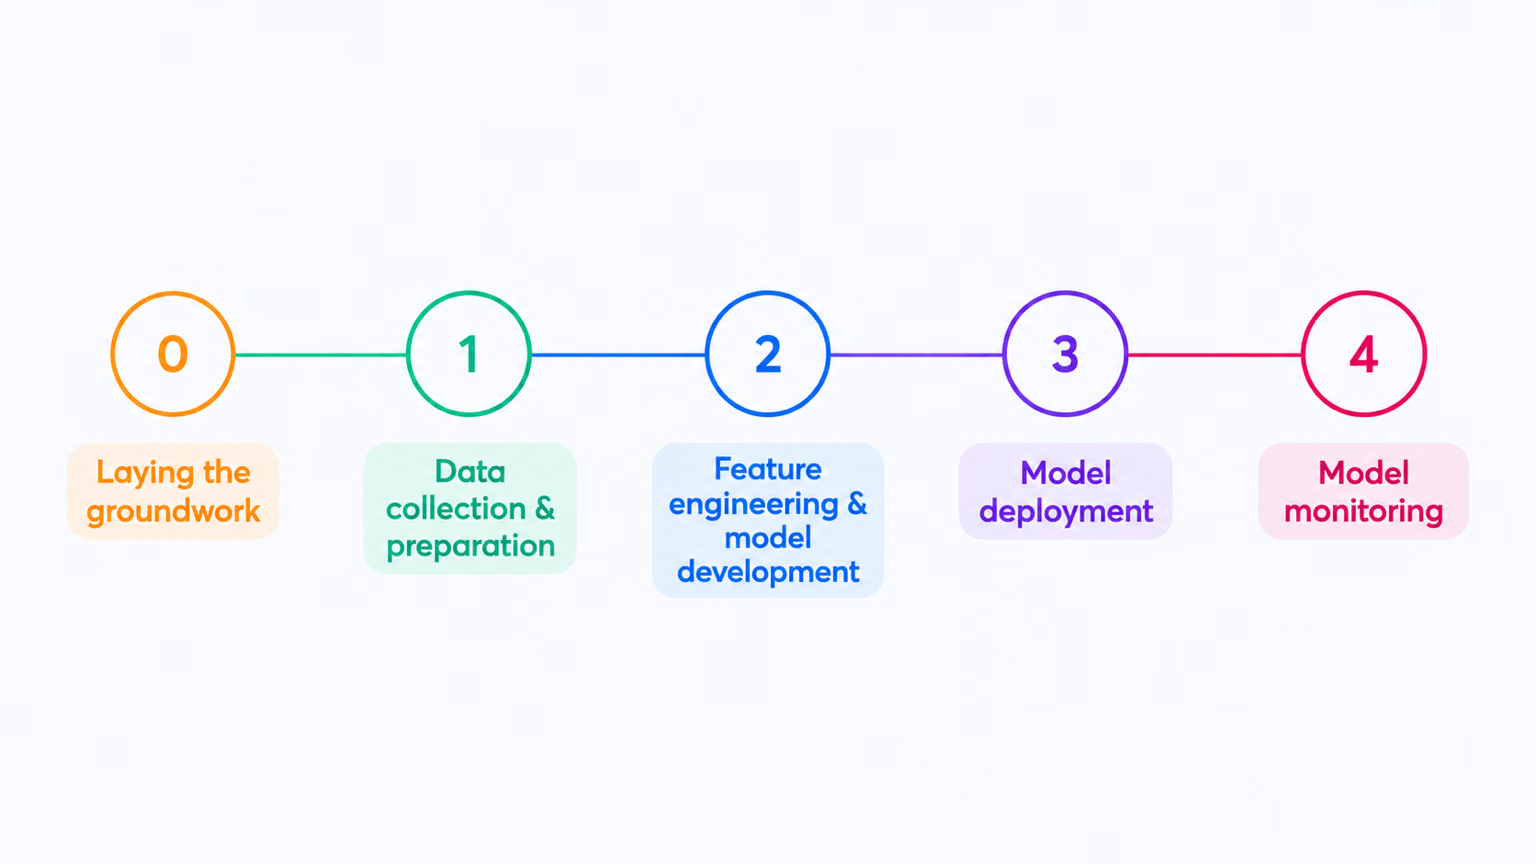
Cada paso de un proyecto de visión artificial hereda su objetivo del paso 0. Una pregunta imprecisa produce un conjunto de datos impreciso, desacuerdos entre anotadores y una métrica que mide algo distinto de lo que debería; ningún entrenamiento en el paso 2 lo arreglará.
Las tres líneas#
Una especificación de tarea consta de tres frases, una por línea. Cada una responde a una pregunta que se hará una persona distinta del proyecto:
| Línea | Pregunta a la que responde | Débil | Sólida |
|---|---|---|---|
| Entrada | ¿Qué ve el modelo? | «Grabaciones de cámara» | «Fotogramas de 1920×1080 a 5 fps de 12 cámaras de techo» |
| Salida | ¿Qué datos devuelve? | «Detectar problemas de seguridad» | «Recuadros para forklift y person, cada uno con una puntuación de confianza» |
| Decisión | ¿Quién actúa y cuándo? | «Mejorar la seguridad» | «Avisar al supervisor del turno cuando una carretilla elevadora y una persona estén a menos de 2 m durante 2 s» |
La línea de salida requiere más atención, porque su tipo de dato determina la tarea:

Una etiqueta para toda la imagen significa clasificación; los recuadros, detección; los contornos, segmentación; las articulaciones, pose; los recuadros girados, OBB; y una clase o distancia por píxel, segmentación semántica o profundidad. En la siguiente lección se explican las siete tareas.
Ejemplo práctico: separa el modelo de la regla#
«Queremos saber cuándo las carretillas elevadoras hacen algo peligroso en el almacén».
Esa frase describe un proyecto, no una tarea. Mezcla dos funciones: localizar carretillas elevadoras y personas, que depende de los píxeles, y decidir qué cuenta como peligroso, que depende de una política. Sepáralas:
Solo el detector forma parte del modelo. El rombo es código normal. Puedes probar esta separación ahora mismo: bus.jpg no tiene ninguna carretilla elevadora, pero un autobús y cuatro personas sirven para hacer la misma prueba. Una primera regla dice «avisar cuando más del 30 % del recuadro de una persona se superponga al recuadro de un vehículo»:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]

# The model's job ends here: a class, a box, and a confidence per object.
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def share_inside(a, b):
    """Fraction of box a's area that lies inside box b."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return w * h / ((a[2] - a[0]) * (a[3] - a[1]))

# The decision rule is plain code: change the policy without retraining.
ALERT_SHARE = 0.30
for person in people:
    share = max(share_inside(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: {share:4.0%} inside the bus box -> {'ALERT' if share > ALERT_SHARE else 'ok'}")
person at x= 49: 70% inside the bus box -> ALERT
person at x=223: 76% inside the bus box -> ALERT
person at x=670: 70% inside the bus box -> ALERT
person at x= 0: 62% inside the bus box -> ALERTCuatro avisos, todos falsos: las personas están en la acera, delante de un autobús aparcado. El detector acierta con todos los recuadros; la regla está mal, porque la superposición en una imagen 2D no significa que dos cosas estén cerca en el mundo real. Como la regla es código, se corrige con código. Compara dónde tocan el suelo los pies de cada persona con la línea de las ruedas del autobús:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def same_ground_line(person, vehicle, tolerance=40):
    """True when the person's feet are level with the vehicle's wheels and inside its width."""
    feet_x, feet_y = (person[0] + person[2]) / 2, person[3]
    return vehicle[0] < feet_x < vehicle[2] and abs(feet_y - vehicle[3]) < tolerance

for person in people:
    alert = any(same_ground_line(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: feet y={person[3]:.0f}, bus wheels y={vehicles[0][3]:.0f} -> {'ALERT' if alert else 'ok'}")
person at x= 49: feet y=902, bus wheels y=751 -> ok
person at x=223: feet y=861, bus wheels y=751 -> ok
person at x=670: feet y=880, bus wheels y=751 -> ok
person at x= 0: feet y=871, bus wheels y=751 -> okLos pies de todas las personas están entre 110 y 150 píxeles por debajo de la línea de las ruedas, así que están más cerca de la cámara que el autobús. No hace falta volver a entrenar ni etiquetar: el equipo de seguridad itera sobre la regla mientras el detector permanece igual. Una versión de producción transformaría la posición de los pies en coordenadas del suelo con una cámara calibrada y añadiría la persistencia de 2 segundos mediante el seguimiento de objetos; seguiría siendo código sobre los mismos recuadros.
Las palabras subjetivas —«inseguro», «defectuoso», «sospechoso», «VIP»— pertenecen al código que lee la salida del modelo. Un modelo responde a preguntas sobre píxeles. Si dos expertos discutirían sobre una etiqueta, el debate debe trasladarse a una regla que puedas versionar, probar y cambiar.
Errores habituales#
Síntoma: la especificación dice «detectar problemas de seguridad» o «entender la escena», y los anotadores preguntan qué deben dibujar. Solución: reescribe la salida como un tipo de datos con clases con nombre: «cajas para forklift y person».
Síntoma: una clase como suspicious_behavior o dangerous que dos anotadores etiquetan de forma distinta en el mismo fotograma. Solución: sustitúyela por pruebas visibles —una persona dentro de una zona restringida, una puerta abierta— y traslada el criterio a la línea de decisión.
Síntoma: «describe lo que está pasando» (generación de descripciones) o «predice si la carretilla elevadora atropellará a alguien» (predicción). Solución: localiza primero los objetos y luego añade reglas de seguimiento y movimiento. Crea el detector antes de la predicción.
De la especificación a los criterios de éxito#
La especificación indica qué hace el modelo, no qué nivel de calidad es suficiente ni cuánto cuesta un fallo en comparación con una falsa alarma. Empieza por el objetivo de negocio en Crear conjuntos de datos YOLO de alto rendimiento convierte la especificación en objetivos medibles. Todas las lecciones posteriores de este curso remiten a tus tres líneas.
Mostrar solución
Una especificación para la cámara de la estantería:
- Entrada: una imagen fija de 1920×1080 cada 60 segundos, tomada por una cámara fija que apunta a un pasillo.
- Salida: recuadros delimitadores para
productyempty_facing(un hueco de estantería sin producto), cada uno con una puntuación de confianza. - Decisión: crear una tarea de reposición cuando tres o más recuadros de
empty_facingen la misma estantería persistan durante cinco imágenes fijas consecutivas en horario comercial.
Las palabras que el modelo no puede ver son tarea de reposición, misma estantería, persistan durante cinco imágenes fijas y horario comercial. Como regla:
if count(empty_facing on shelf S) >= 3 in each of the last 5 stills and store_is_open(now):
    create_restock_task(shelf=S)
La tienda puede cambiar «3», «5» o el horario de apertura sin volver a etiquetar ni una sola imagen.