Empieza por el objetivo empresarial
Convierte un objetivo empresarial en una tarea de visión, define las clases y crea una prueba de aceptación que puedas ejecutar como código, antes de recopilar una sola imagen.
Un equipo de almacén fotografía todo durante un mes y luego descubre que al responsable de seguridad solo le preocupan las personas cerca de carretillas elevadoras en movimiento, así que hay que rehacer la mitad de las etiquetas. Un objetivo de una página, acordado antes de la primera foto, evita ese problema. Lleva una tarde y determina todas las decisiones posteriores de este curso: qué recopilar, qué etiquetar y cuándo el modelo está listo para desplegarse.
Práctico
El objetivo de una página#

Cinco filas responden a las preguntas de las que depende cada paso posterior. La guía para definir los objetivos del proyecto aborda los mismos temas con más detalle. Aquí tienes un ejemplo de almacén ya rellenado, que servirá de base para este curso:
| Fila | Pregunta a la que responde | Ejemplo de almacén |
|---|---|---|
| Objetivo empresarial | ¿Qué cambiará para la empresa y para cuándo? | Reducir un 30 % los incidentes de riesgo de accidente en las puertas de carga en seis meses. |
| Tarea de visión | ¿Qué devuelve el modelo? | Detección de objetos: cajas alrededor de carretillas elevadoras y personas. |
| Clases | ¿Qué se etiqueta exactamente? | forklift, person, pallet; todo lo demás es fondo. |
| Prueba de aceptación | ¿Qué resultado significa «listo para desplegar»? | Exhaustividad en person ≥ 0.95 con una precisión ≥ 0.85 en 500 fotogramas de cámaras no utilizadas durante el entrenamiento. |
| Fuera de alcance | ¿Qué no prometerá la versión 1? | Muelles en penumbra, personas totalmente ocultas tras estanterías y transpaletas manuales. |
Fija la página en un lugar donde todo el equipo pueda verla. Si más adelante alguien del equipo de partes interesadas cuestiona una fila, modifica primero la página y después el conjunto de datos.
Elige la tarea más sencilla que responda a la pregunta#
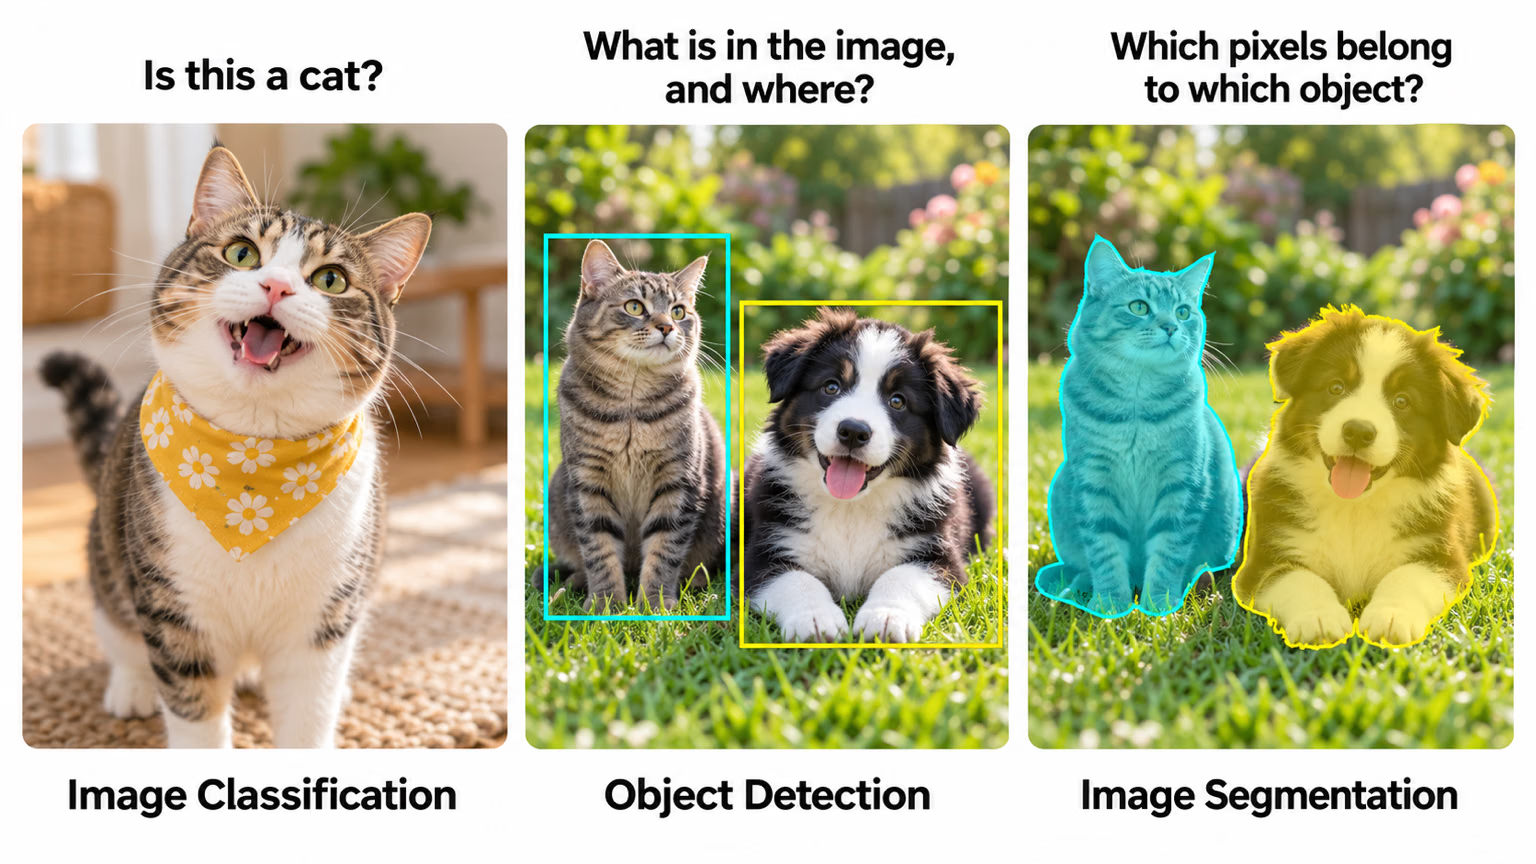
La tarea determina qué dibujan los anotadores, y eso determina la mayor parte del presupuesto de etiquetado. Sigue este árbol de decisión y detente en la primera tarea que responda a la pregunta empresarial:
Ultralytics YOLO admite siete tareas. Para planificar el conjunto de datos, lo importante es cuánto cuesta etiquetar cada una; Fundamentos de visión artificial las compara en profundidad en su lección sobre tareas de visión.
| Tarea | Qué producen los anotadores | Esfuerzo de etiquetado | Elígela cuando |
|---|---|---|---|
| Clasificación | Una etiqueta por imagen | El más bajo | Basta con una respuesta por imagen |
| Detección | Clase y caja alineada con los ejes por objeto | Bajo | Necesitas contar o localizar objetos |
| OBB | Clase y caja rotada por objeto | Medio | Los objetos son largos y estrechos, o se ven desde arriba |
| Pose | Clase y puntos clave con nombre por objeto | Alta | Importan las posiciones de las articulaciones o las partes |
| Segmentación de instancias | Clase + polígono por objeto | Alta | Importa el contorno de cada objeto |
| Segmentación semántica | Una clase para cada píxel | La más alta | Necesitas regiones, no objetos que se puedan contar |
| Estimación de profundidad | No se dibuja nada: un mapa de profundidad por imagen, normalmente de un sensor de profundidad | Depende del hardware de captura | Necesitas la distancia de cada píxel |
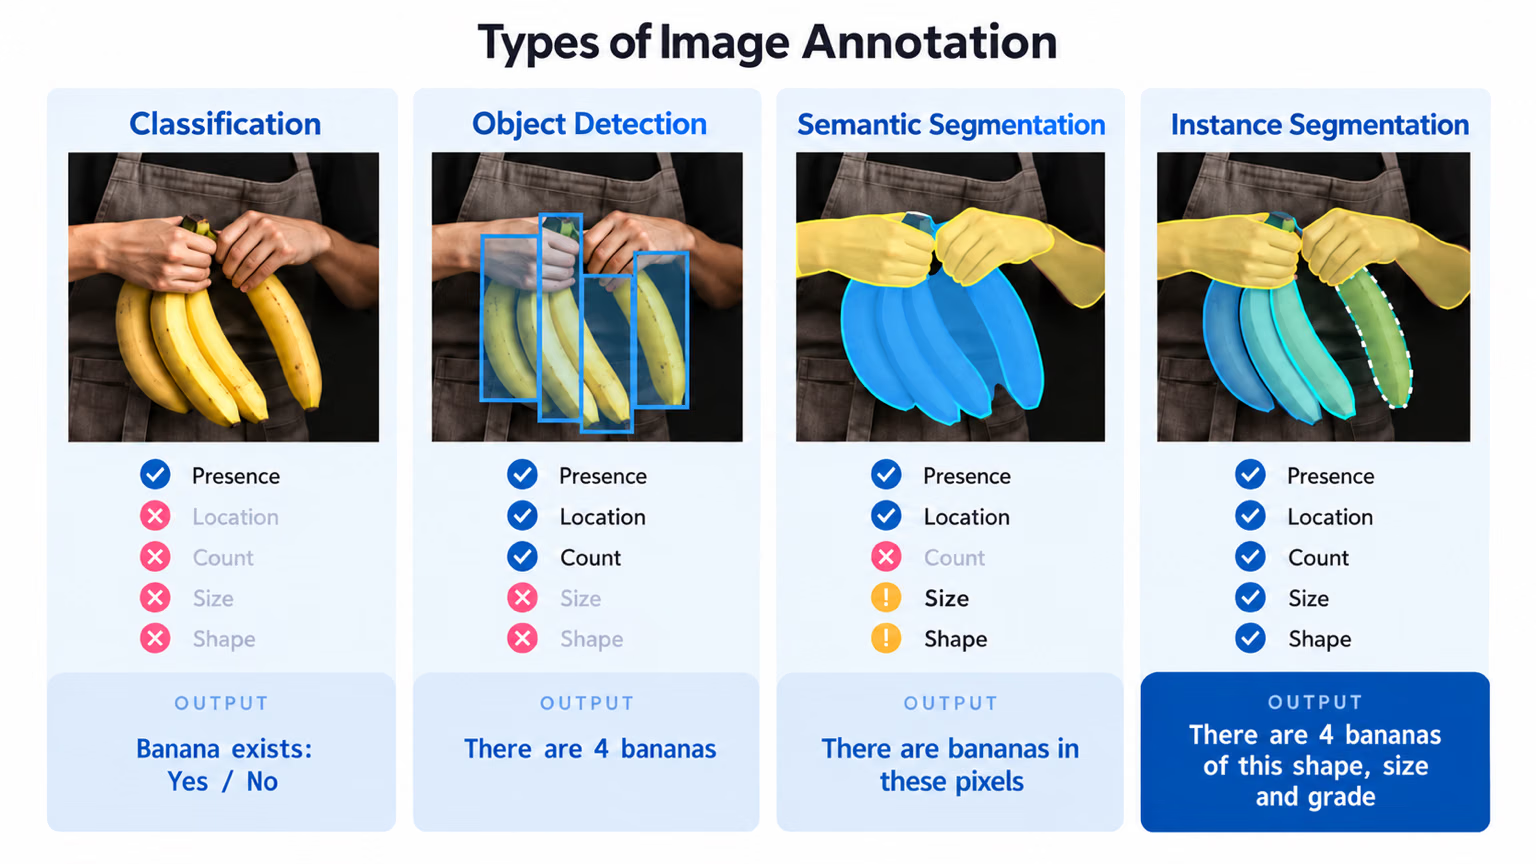
Interpreta el panel de los plátanos como una lista de precios: la detección ya responde a la presencia, la ubicación y el recuento; solo los dos paneles de segmentación añaden el tamaño y la forma, con un coste de etiquetado mucho mayor. Si a la empresa solo le interesa «cuántos plátanos hay», la respuesta es la detección y los polígonos son un gasto inútil.
Los equipos suelen optar por la segmentación porque parece más precisa, pero luego se quedan sin presupuesto de etiquetado antes de que el conjunto de datos cubra los turnos de noche, la lluvia o la segunda ubicación. Los polígonos cuestan varias veces más por objeto que las cajas. Elige la segmentación solo cuando una fila del objetivo necesite el contorno en sí, por ejemplo, para medir un área o recortar una máscara.
Define clases que pueda aplicar un anotador#
Una clase solo es útil si dos anotadores etiquetan el mismo objeto de la misma manera. Define cada clase con una sola frase que mencione algo parecido que excluya:
forklift: una carretilla elevadora motorizada, incluidas las horquillas y el mástil. Excluye las transpaletas manuales.person: cualquier persona, aunque se vea parcialmente, esté sentada o dentro de la cabina de un vehículo. Excluye los reflejos y los carteles.pallet: un palé de madera o plástico, cargado o vacío. Excluye las cajas apiladas sin una base de palé.
Después, elige deliberadamente el nivel de detalle. Las clases generales («vehículo») son más baratas y convergen más rápido; las clases específicas («berlina», «pick-up») son más útiles en etapas posteriores, pero cuesta más mantenerlas coherentes. Empieza por lo que necesita la empresa. Más adelante, puedes agrupar las etiquetas específicas en clases generales con una sola línea de código, pero no puedes dividir las clases generales sin volver a etiquetar.
«Cualquier cosa que parezca peligrosa» o «cosas que bloquean el pasillo» no son clases. Exigen que cada anotador decida por su cuenta, y un modelo entrenado con decisiones incoherentes aprende esa incoherencia. Reescribe una clase ambigua hasta que un anotador nuevo pueda aplicarla basándose únicamente en la definición, o conviértela en una regla que se aplique después de la detección (por ejemplo, «cualquier pallet dentro del polígono del pasillo»).
Convierte la métrica en una prueba de aceptación que puedas ejecutar#
Elige la métrica que se corresponda con el coste de un error:
- Un falso negativo sale caro (seguridad, defectos): establece un umbral de recobrado para esa clase.
- Una falsa alarma sale cara (rechazar piezas automáticamente, avisar al personal): establece un umbral de precisión.
- Todas las clases importan por igual (recuento, inventario): establece un umbral de AP por clase, para que ninguna clase se esconda detrás del promedio.
La guía de métricas de rendimiento de YOLO explica cada una. Después, escribe la prueba en código para que «¿es lo bastante bueno?» deje de ser objeto de debate. Este script funciona hoy con un modelo preentrenado en el conjunto de demostración COCO8 y, más adelante, con tu propio punto de control y conjunto de evaluación:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # later: your fine-tuned runs/detect/train/weights/best.pt
metrics = model.val(data="coco8.yaml", classes=[0], verbose=False)  # 0 = person; later: your holdout YAML

precision, recall = metrics.box.mp, metrics.box.mr
print(f"person: precision={precision:.2f} recall={recall:.2f}")
print("PASS" if recall >= 0.95 and precision >= 0.85 else "FAIL: below the acceptance test")
all 4 10 0.939 0.8 0.848 0.387
person: precision=0.94 recall=0.80
FAIL: below the acceptance testQué indica cada línea:
classes=[0]puntúa soloperson, así que otras clases no pueden inflar el resultado. Usa el ID de tu propia clase de seguridad.- La fila del validador muestra 4 imágenes con 10 personas etiquetadas.
mpymrson la precisión y el recobrado en el umbral de confianza que mejor los equilibra (F1 máximo). - Un modelo de COCO preentrenado detecta a 8 de las 10 personas, así que el recobrado es de 0,80: preciso, pero no lo bastante seguro. Ese FAIL demuestra que la prueba está haciendo su trabajo. En este curso, un FAIL nos lleva de vuelta a los datos, no a los hiperparámetros.
Una prueba extraída de las mismas cámaras y días que el entrenamiento mide la memorización, no la preparación. Especifica la exclusión en el objetivo («cámaras no utilizadas en el entrenamiento», «las dos últimas semanas de grabación») y crea el conjunto siguiendo Divide correctamente el conjunto de datos.
Deja por escrito qué no hará la v1#
Ningún modelo es perfecto, así que define de antemano los falsos negativos aceptables: las condiciones que no vas a cubrir (niebla densa, oscuridad total), los objetos parecidos que aceptarás confundir y las clases poco frecuentes que pospondrás a la v2. Esta fila evita juzgar un modelo que cumple su objetivo con un criterio del 100 % que nadie había escrito y dice al equipo de recopilación dónde no merece la pena invertir esfuerzos todavía.
Mostrar solución
Un ejemplo de objetivo desarrollado para otro proyecto: una cadena de supermercados que detecta huecos en las estanterías.
| Fila | Respuesta |
|---|---|
| Objetivo empresarial | Reducir un 25 % los minutos sin existencias de los 200 productos más vendidos en un trimestre. |
| Tarea de visión | Detección. La tienda necesita la ubicación de cada hueco, no su contorno, así que las cajas son mejores que los polígonos. |
| Clases | gap: un hueco vacío en una estantería de al menos el ancho de un producto; excluye los huecos ocultos por un cliente o un carrito. price_tag: una etiqueta en el borde de la estantería; excluye las pegatinas promocionales. |
| Prueba de aceptación | Recobrado de gap ≥ 0.90 con una precisión ≥ 0.80 en 400 imágenes de 5 tiendas que no se hayan usado para el entrenamiento. |
| Fuera de alcance | Puertas de congeladores con reflejos, expositores de cabecera y sección de frutas y verduras. |
El recobrado es lo primero porque un hueco que no se detecta cuesta una venta, mientras que una falsa alarma solo supone un paseo corto para un empleado. acceptance_test.py cambia en solo tres sitios: data="holdout_stores.yaml" (las cinco tiendas no vistas), classes=[0] (ahora 0 es gap) y los umbrales recall >= 0.90 and precision >= 0.80.