Averigua cuándo está listo el conjunto de datos
Condiciona la primera ejecución de entrenamiento a ocho comprobaciones de aprobado o suspenso, automatiza las tres que puede verificar un script y averigua qué solución requiere cada fallo.
Todos los proyectos llegan al momento en que el equipo quiere entrenar. A veces el conjunto de datos está listo; otras, todavía tiene una fuga entre particiones o una clase con pocas anotaciones que desperdiciará una semana de tiempo de GPU y producirá una cifra en la que nadie debería confiar. Ocho comprobaciones, cada una marcada como sí, no o excepción documentada, permiten tomar esa decisión de forma objetiva y no según el estado de ánimo.
Práctico
Las ocho comprobaciones#
| # | Comprobación | Criterios de aprobado | Si no se supera, vuelve a |
|---|---|---|---|
| 1 | Objetivo claro | El objetivo, la tarea, las clases y una prueba de aceptación están documentados y acordados | Empieza por el objetivo de negocio |
| 2 | Clases definidas | Cada clase tiene una definición y un ejemplo parecido que queda excluido | Objetivo y guía de anotación |
| 3 | Imágenes representativas | Cada escenario de la especificación alcanza su cuota, principalmente con fuentes de producción | Recopila datos representativos de alta calidad |
| 4 | Volumen suficiente | ≥ 1.500 imágenes y ≥ 10.000 instancias por clase, o una excepción documentada | Especificación y recopilación |
| 5 | Etiquetas coherentes | Guía redactada, ronda de calibración completada y concordancia ≥ 90 % | Buenas prácticas de anotación |
| 6 | Control de calidad completado | Script de auditoría sin errores, casos sospechosos revisados y notas de control de calidad redactadas | Control de calidad del conjunto de datos |
| 7 | Particiones limpias | Partición por grupos, ningún grupo en dos particiones y todas las clases en cada partición | Divide correctamente el conjunto de datos |
| 8 | Imágenes de fondo | Entre el 0 y el 10 % de las imágenes son fotogramas sin etiquetas | Especificación y recopilación |
La lista de comprobación evalúa una por una las mismas decisiones que cubre la guía de recopilación y anotación de datos; aquí se convierten en una única decisión de seguir o no seguir.
Automatiza las comprobaciones cuantificables#
Las comprobaciones 4, 7 y 8 son cálculos, así que un script las evalúa siempre del mismo modo. Este lee el conjunto de práctica y las listas de particiones que escribió group_split.py en la lección anterior:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesLa partición por grupos corrigió la fuga, pero el conjunto de práctica está muy lejos de estar listo: la clase más débil (30, skis) solo tiene una instancia etiquetada y la validación no puede evaluar la mitad de las clases. Ese es el veredicto esperado para 128 imágenes de demostración, y justo el que esta comprobación debe ofrecer antes de dedicar una semana al entrenamiento.
El script cubre lo que se puede contar. Las comprobaciones 1, 2, 3, 5 y 6 necesitan a una persona: un objetivo acordado, definiciones por escrito, cobertura de la especificación, una puntuación de concordancia medida y notas de control de calidad. Evalúalas manualmente, con una línea de pruebas para cada una.
Decide: entrenar, seguir adelante con una carencia o corregirla#
Cuando una comprobación falla, el siguiente paso tentador casi siempre es hacer algo distinto de corregir los datos:
| Atajo tentador | Por qué no funciona |
|---|---|
| «Prueba con un modelo más grande». | Un modelo más grande aprende el ruido de las etiquetas con la misma fidelidad. |
| «Ajusta la tasa de aprendizaje». | Ningún ajuste del optimizador añade una clase o un escenario que falta. |
| «Entrena durante más épocas». | Más épocas con datos poco variados provocan un sobreajuste más rápido. |
| «Añade más aumento de datos». | El aumento de datos no puede crear escenarios que nunca estuvieron presentes en los datos. |
Tres situaciones en las que casi todo está listo#
| Situación | Comprobación fallida | Cómo se manifiesta | Solución |
|---|---|---|---|
| Mucho volumen, poca variación | 3 | 5.000 imágenes, una cámara y ningún caso límite | Recopila datos de más cámaras, ubicaciones y momentos antes de entrenar |
| Mucha variación, poca coherencia | 5 | Los anotadores discrepan sobre el tamaño de los cuadros y la oclusión | Completa la guía, calibra y vuelve a etiquetar la muestra afectada |
| Fuga inadvertida | 7 | Partición aleatoria por imagen de fotogramas de vídeo | Vuelve a dividir por clip, cámara o día; espera que el mAP de val baje, porque esa bajada refleja la realidad. |
Publica con una carencia conocida.#
A menudo, lo más adecuado es crear un primer modelo centrado antes de que todas las comprobaciones estén en verde: un piloto, un prototipo o una v1 para un subconjunto de cámaras. Un modelo en producción muestra qué falla de verdad más rápido que pulir el conjunto de datos a ciegas. Si publicas con una carencia, anota tres cosas:
- Qué comprobación ha fallado.
- El impacto previsto, por ejemplo: "no hay datos nocturnos; espera una menor exhaustividad cuando oscurezca".
- El plan de recopilación para subsanarla mientras la v1 está en marcha.
«Volumen: excepción» no aporta información a la siguiente persona. «Volumen: pallet con 700 instancias; se prevé una menor detección de palés en zonas abarrotadas; 2.000 más etiquetadas para junio» es un riesgo gestionado. Cada excepción necesita indicar el impacto esperado en la prueba de aceptación.
Vuelve a ejecutar las comprobaciones antes de cada nuevo entrenamiento.#
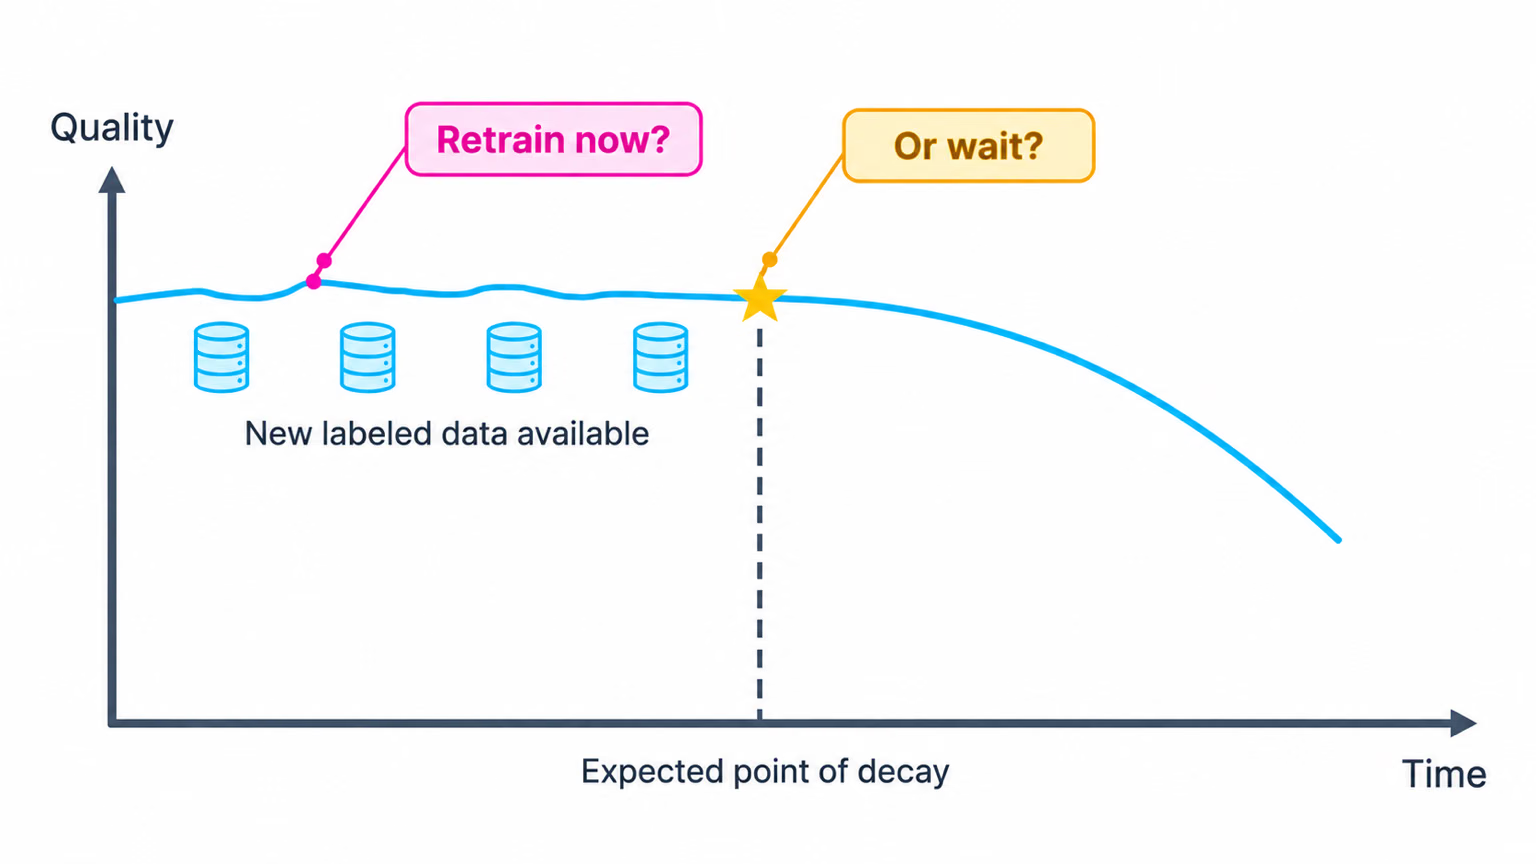
Un conjunto de datos que estaba listo para la v1 no está automáticamente listo para la v3. Las clases, las fuentes y los anotadores nuevos pueden hacer que falle una comprobación que antes superaba, y los datos de producción cambian mientras se acumulan nuevas etiquetas. Vuelve a ejecutar readiness.py y vuelve a puntuar las comprobaciones manuales antes de cada nuevo entrenamiento; solo lleva unos minutos, y saltártelo puede costarte una semana de entrenamiento con un conjunto de datos defectuoso.
Mostrar solución
Una lista de comprobación puntuada para el conjunto de práctica:
| # | Comprobación | Puntuación | Evidencia |
|---|---|---|---|
| 1 | Objetivo claro | sí | objective.md y acceptance_test.py de la lección 1 |
| 2 | Clases definidas | no | Los 80 nombres de COCO no tienen definiciones por escrito ni ejemplos parecidos excluidos |
| 3 | Imágenes representativas | no | coverage.py: cam2–cam4 por debajo de la cuota |
| 4 | Volumen suficiente | no | readiness.py: la clase más débil tiene 1 imagen |
| 5 | Etiquetas coherentes | no | Concordancia del 47 % en la ronda de calibración |
| 6 | Control de calidad completo | parcial | Auditoría realizada; aún quedan casos dudosos en 000000000438.jpg |
| 7 | Divisiones limpias | no | No hay grupos compartidos, pero a val le faltan 36 de 71 clases |
| 8 | Imágenes de fondo | sí | 1.6% |
Decisión: corregir primero. Ordenadas según el riesgo para la prueba de aceptación: (1) reducir la lista de clases a las que necesita el objetivo, lo que simplifica de una vez las comprobaciones 2, 4 y 7; (2) recopilar más grupos para esas clases; (3) terminar la regla de la guía sobre personas lejanas y volver a etiquetar. Un conjunto de demostración no supera esta comprobación, y así debe ser.