Divide el conjunto de datos correctamente
Mide cuánto filtran las divisiones aleatorias, divide grupos completos como clips, cámaras o días mediante un script, comprueba la cobertura de clases y bloquea el conjunto de test.
Una división descuidada produce una métrica en la que confías, pero que no es real. Cuando fotogramas de vídeo adyacentes acaban tanto en train como en val, el mAP de val mide la memoria en lugar de la capacidad de generalización, y la diferencia solo se aprecia en producción. Cada cifra que comunicas sobre el modelo depende de esta división, así que elígela deliberadamente una sola vez y mantenla fija.
Práctico
Tres divisiones, tres funciones#
| División | Proporción habitual | Función |
|---|---|---|
| Train | 70% | El modelo aprende sus pesos a partir de este conjunto |
| Val | 15% | Elegir la mejor época, comparar ejecuciones y ajustar parámetros |
| Test | 15% | Una decisión final de seguir o no seguir según la prueba de aceptación |
Las guías de Ultralytics sitúan el rango de train entre el 70 y el 80 %, y asignan entre el 10 y el 20 % a val y test: las etapas de un proyecto de CV recomiendan entre el 10 y el 15 % para cada uno, y la guía de preprocesamiento utiliza 70/20/10. Cuenta las proporciones en objetos y también en imágenes, porque una imagen muy densa puede contener más etiquetas que diez imágenes dispersas. Los porcentajes exactos importan mucho menos que el uso que se da a cada división.
Las divisiones aleatorias filtran datos correlacionados#
Los fotogramas 124 y 125 del mismo clip son casi idénticos. Si uno acaba en train y el otro en val, se evalúa val con imágenes que el modelo prácticamente ya ha visto. Mídelo en el conjunto de práctica de Recopila datos representativos de alta calidad, cuyos nombres de archivo empiezan con una clave de grupo de cámara y día:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainTodas las combinaciones de cámara y día de val también aparecen en train. En grabaciones reales, esto significa que los fotogramas de val comparten iluminación, fondo y, a menudo, los mismos objetos con los fotogramas de entrenamiento, por lo que el mAP de val parece excelente y el mAP de producción no.
Elige la unidad de división#
Elige el grupo que corresponda al tipo de generalización que necesita el despliegue:
Si tienes dudas, divide por la unidad más general que te puedas permitir: así obtendrás la cifra más fiable. Las divisiones aleatorias por imagen solo son seguras cuando cada imagen es una captura independiente, como las fotos de productos tomadas con semanas de diferencia.
Divide por grupos con código#
Este script asigna grupos completos a las divisiones hasta que cada una alcanza su proporción 70/15/15, escribe las listas de archivos que acepta un YAML de datos e informa de la cobertura de clases:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingCómo interpretarlo:
- Por construcción, ningún grupo cruza de una división a otra. Así se elimina la filtración.
- Val contiene 2 grupos y no incluye 36 clases, por lo que no se puede medir su AP. Con 71 clases en 128 imágenes, ninguna semilla lo soluciona; la solución real es añadir más grupos (más cámaras o días), como hace un conjunto de datos de producción con más de 1.500 imágenes por clase.
- A train le faltan 5 clases que solo aparecen en val o test. El modelo nunca podrá aprenderlas con esta división.
La regla de decisión: si falta una clase en una división, añade o mueve grupos completos que la contengan; nunca muevas fotogramas individuales, ya que eso volvería a introducir la filtración. Asigna las claves train, val y test del YAML de datos a los tres archivos .txt; Escribe un YAML de conjunto de datos explica el resto del archivo.
Equilibra las clases entre las divisiones#
Para clasificación, train_test_split(..., stratify=labels) de scikit-learn mantiene las proporciones de clase iguales entre las divisiones con un solo argumento. Las imágenes de detección contienen varias clases a la vez, así que equilibra los grupos: después de group_split.py, compara los recuentos por clase entre las divisiones e intercambia grupos completos hasta que todas las clases estén dentro de aproximadamente ±20 % de la proporción esperada.

En Ultralytics Platform, Redistribute Splits reasigna imágenes aleatoriamente y Auto establece la división recomendada 80/20 entre train y val (documentación sobre divisiones). Elimina las imágenes exactamente duplicadas, pero no reconoce tus grupos, así que úsalo con capturas independientes y sube las divisiones agrupadas para datos de vídeo o multicámara.
Haz un seguimiento por separado de dos conjuntos de val#
A menudo conviene tener dos conjuntos de val: una batería de regresión estable y seleccionada, y un conjunto realista para producción que se actualiza con los fotogramas recién recopilados. El YAML de datos acepta una lista de carpetas de val, pero las combina en un único conjunto de val con una sola puntuación:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Para ver cada puntuación, mantén un YAML de datos por conjunto de val (con el mismo train y names, pero distinto val) y valida los pesos entrenados con cada uno:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Una caída en el conjunto seleccionado indica una regresión; una caída en el conjunto de producción indica un cambio de dominio.
Bloquea el conjunto de test#
El error de división más costoso es comparar diez variantes del modelo con el conjunto de prueba. En cuanto la prueba influye en una decisión, la cifra final se vuelve optimista. Realiza todos los ajustes y compara las ejecuciones con la validación; ejecuta la prueba de aceptación con el conjunto de prueba una sola vez, al final.
Todas las métricas que publiques dependen de esta división. Volver a barajar los datos más adelante cambia todas las cifras y hace que las ejecuciones antiguas y nuevas no sean comparables. Conserva con el conjunto de datos la unidad de división, la semilla y las tres listas de archivos.
Validación cruzada K-fold para conjuntos de datos pequeños#
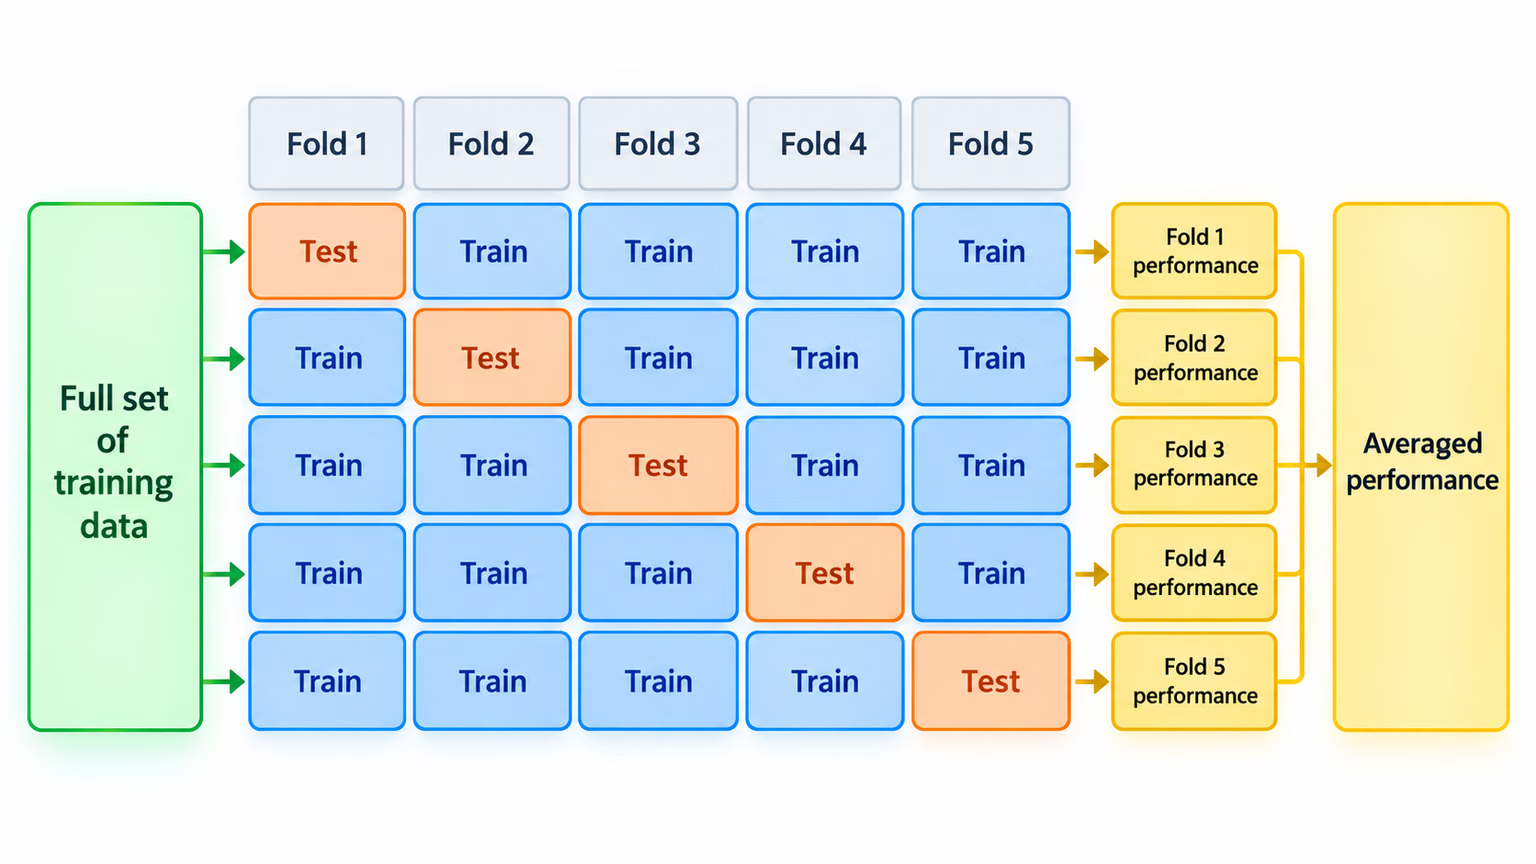
Cuando el conjunto de datos es pequeño (menos de unas 500 imágenes por clase) y una sola división parece estadísticamente poco fiable, la validación cruzada K-fold entrena k modelos con divisiones rotatorias y calcula la media del resultado: k veces más cómputo para obtener una estimación mucho más estable. Crea los pliegues a partir de grupos del mismo modo; de lo contrario, cada pliegue tendrá filtraciones.
Mostrar solución
Para cámaras fijas de almacén que deben seguir funcionando en días nuevos, divide por cámara y día: cam2_2026-05-01. Después de group_split.py, comprueba que ningún grupo cruce el límite entre divisiones:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneLa división de práctica supera la comprobación de filtraciones, pero no la de cobertura: a val le faltan 36 de 71 clases. La solución es un plan de recopilación, no volver a barajar los datos. Graba al menos dos días más con cámaras para val y test, cada uno con las clases más importantes según la especificación, y vuelve a ejecutar ambos scripts.