Buenas prácticas de anotación
Redacta una guía de etiquetado, elige una herramienta, evita los diez errores que reducen la precisión sin que te des cuenta y mide con un script el acuerdo entre anotadores antes de ampliar el proceso.
La calidad de las etiquetas limita la calidad del modelo. Diez anotadores que interpretan cada uno «palé» de forma ligeramente distinta generan un conjunto de datos que enseña las diez interpretaciones a la vez, y ningún entrenamiento resuelve esa contradicción. Una guía escrita, una ronda de calibración evaluada y una breve lista de errores conocidos mantienen la coherencia de las etiquetas, tanto si una persona etiqueta 500 imágenes como si un equipo etiqueta 50 000.
Práctico
Elige la herramienta de anotación#
La herramienta adecuada depende de la tarea, el equipo y el lugar donde se entrena:
| Herramienta | Ideal para | Notas |
|---|---|---|
| Ultralytics Platform | Las siete tareas de YOLO: un editor para cajas, polígonos, máscaras semánticas, puntos clave, cajas giradas y clases de imagen, además de mapas de profundidad cargados; anotación inteligente con SAM | Etiquetas, gráficos del conjunto de datos y entrenamiento en un mismo sitio; sin necesidad de exportar |
| CVAT | Equipos grandes, vídeo y flujos de revisión complejos | Alojamiento propio o en la nube |
| Label Studio | Proyectos multimodales (imagen + texto + audio) | Configuración flexible, curva de aprendizaje más pronunciada |
| Labelme | Etiquetado de polígonos para equipos pequeños | Aplicación de escritorio sencilla |
| LabelImg | Prototipos rápidos que solo necesitan cajas | Ligera; el repositorio está archivado |
En Ultralytics Platform, la anotación inteligente de SAM 2.1, SAM 3 y SAM 3.1 funciona con conjuntos de datos de detección, segmentación, segmentación semántica y OBB. Elijas lo que elijas, confirma que exporta el formato YOLO que necesita tu tarea; Preparar un conjunto de datos personalizado explica el formato de las etiquetas y su conversión.
Los siete tipos de etiquetas#

| Tipo de etiqueta | Qué dibujas | Tarea |
|---|---|---|
| Etiqueta de clase | Una etiqueta por imagen | Clasificación |
| Caja delimitadora | Rectángulo alineado con los ejes para cada objeto | Detección |
| Polígono | Contorno de cada instancia del objeto | Segmentación de instancias |
| Máscara densa | Una clase para cada píxel | Segmentación semántica |
| Puntos clave | Puntos con nombre, como las articulaciones | Pose |
| Caja orientada | Rectángulo girado para cada objeto | OBB |
| Mapa de profundidad | Nada: un mapa de distancias por píxel de un sensor de profundidad, asociado a cada imagen | Estimación de profundidad |
Redacta primero la guía de etiquetado#
Antes de que nadie dibuje una caja, redacta una guía con cinco secciones:
- Definiciones de las clases: un párrafo por clase con ejemplos positivos, elementos parecidos que no pertenecen a la clase y casos límite.
- Reglas de dibujo: cajas ajustadas al objeto visible; polígonos que sigan el contorno visible.
- Reglas de oclusión y tamaño: un umbral para objetos parcialmente visibles («etiquétalo si puedes identificar la clase») y otro para los objetos pequeños («etiqueta a las personas que midan más de 10 píxeles»), aplicados en todos los casos.
- Registro de casos ambiguos: cada pregunta del tipo «¿y este caso?» con la respuesta acordada y una captura de pantalla.
- Qué omitir: todo lo que no merezca la pena etiquetar para esta tarea.
Con una o dos páginas y algunas capturas de pantalla basta. Después, la guía sirve de base para un breve ciclo que se completa antes de ampliar el etiquetado:
Etiqueta todos los objetos relevantes de cada imagen. Una carretilla elevadora sin etiquetar enseña al modelo que, a veces, las carretillas elevadoras son fondo, así que aprende a no detectarlas. Un conjunto de datos etiquetado parcialmente parece idéntico a otro más pequeño, pero completamente etiquetado, hasta que entrenas. Termina cada imagen antes de pasar a la siguiente.
Diez errores que reducen la precisión#
Los errores que el equipo de anotación de Ultralytics ve con más frecuencia, ilustrados con imágenes de carretillas elevadoras, personas y palés (adaptado de una presentación de Alexis Schutzger). Úsalos como las primeras entradas de tu guía.
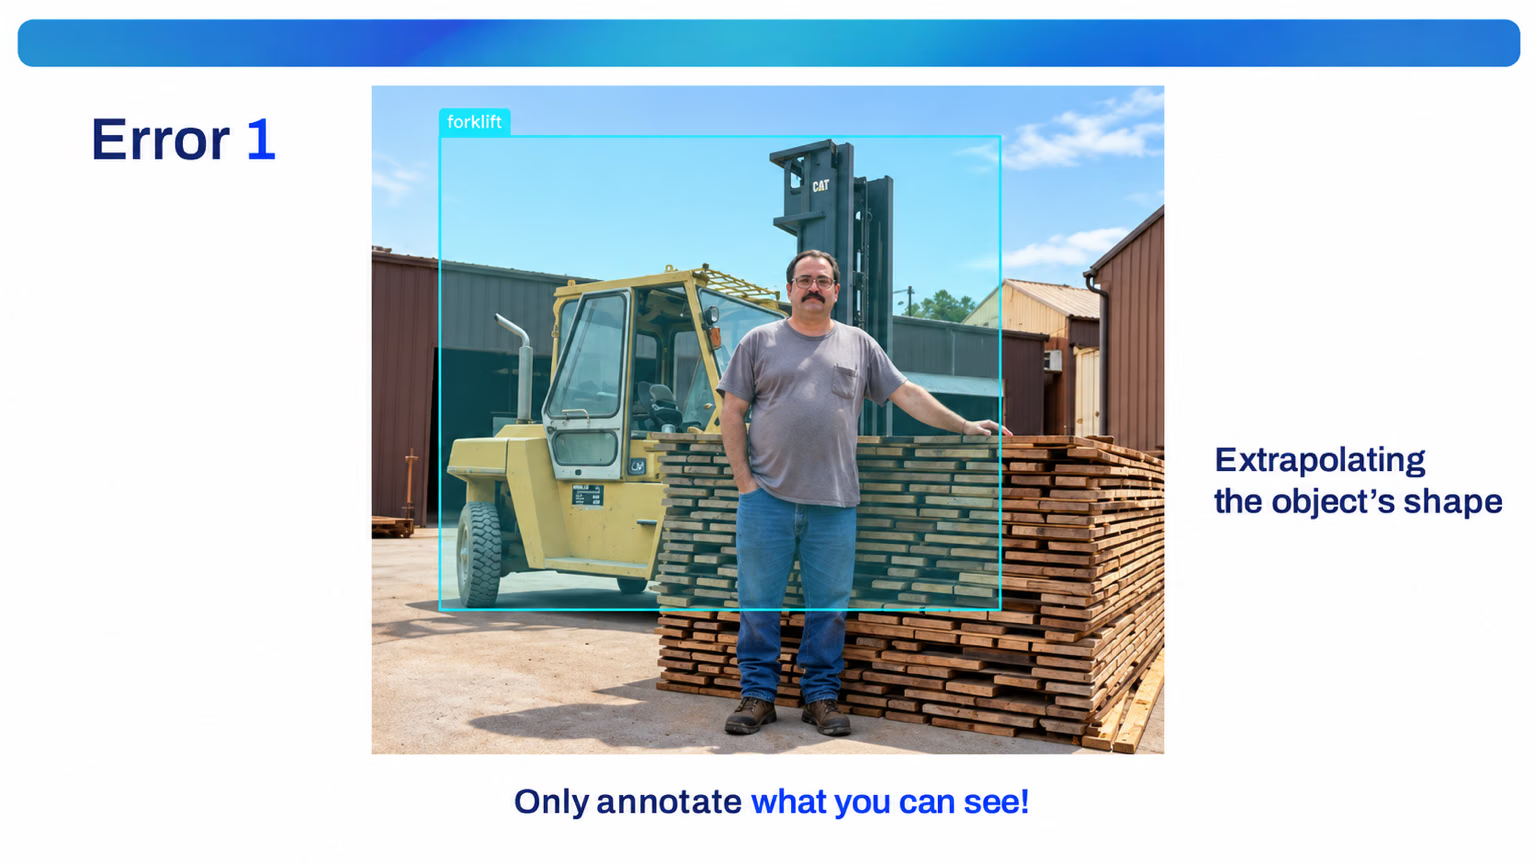
1. Extrapolar la forma del objeto. Anota solo lo que puedas ver. Aquí, la carretilla elevadora está detrás de una persona y una pila de madera, pero su caja atraviesa ambas hasta llegar al punto donde el anotador imaginó el resto del vehículo. Delimita la parte visible.
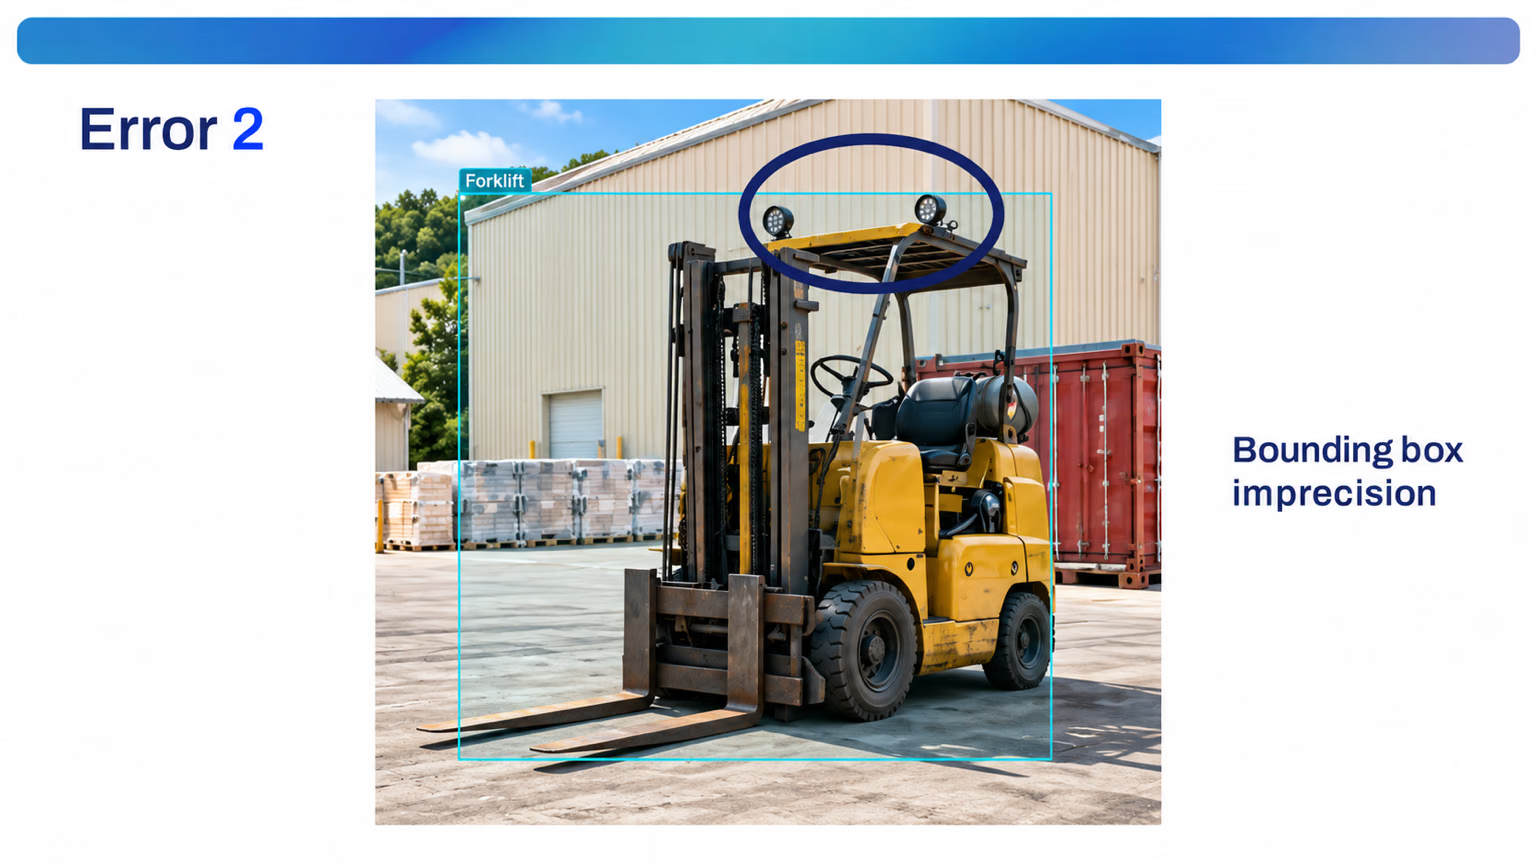
2. Cajas imprecisas. Las cajas deben ceñirse al objeto. Esta atraviesa las luces de la estructura de protección superior; una caja que recorta parte del objeto o deja un margen de suelo enseña una extensión incorrecta.
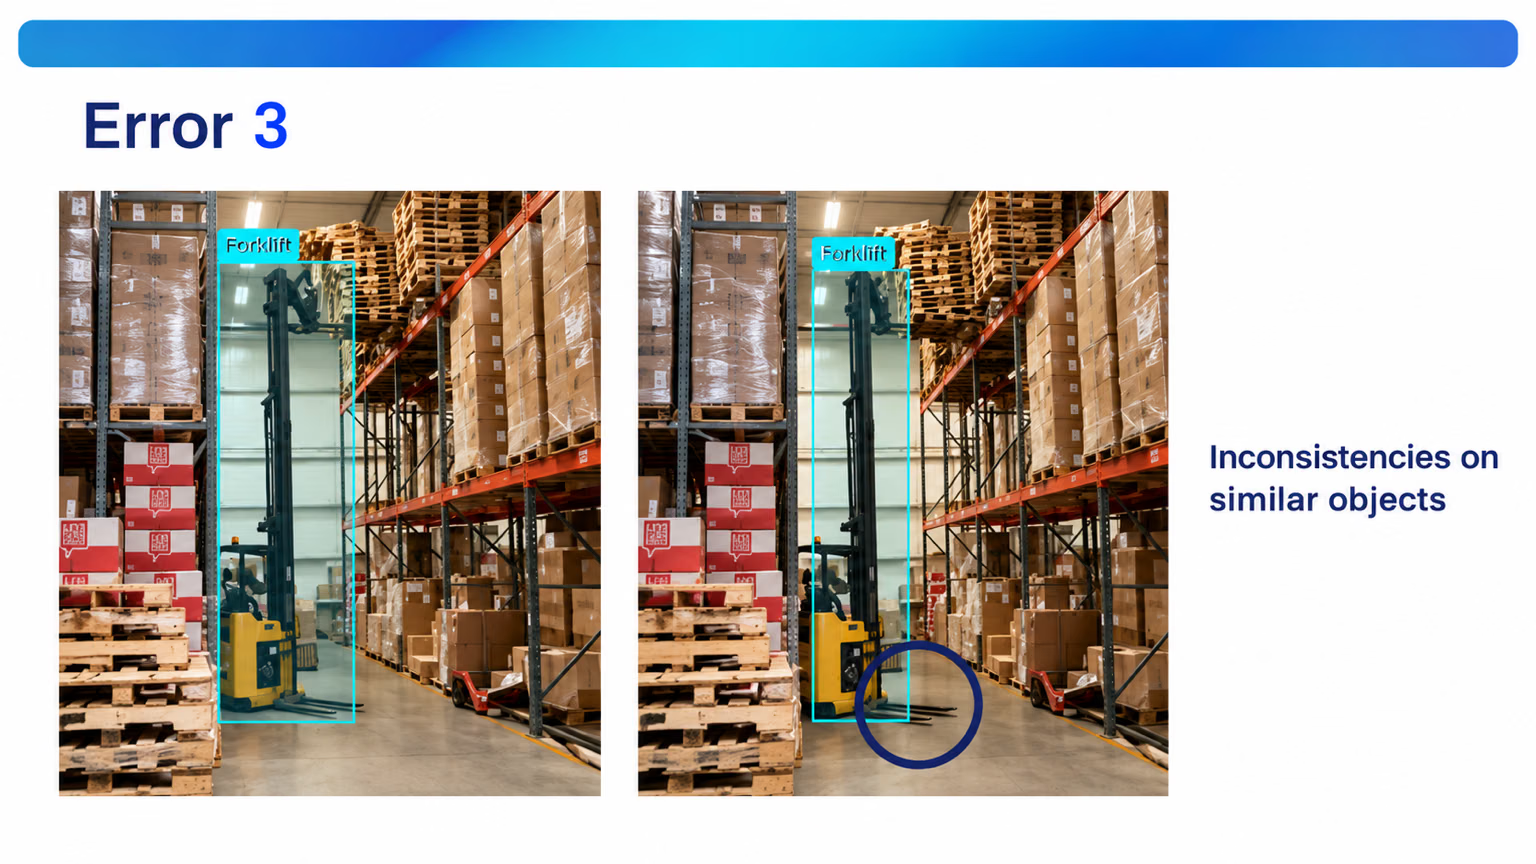
3. Convenciones incoherentes para objetos similares. La caja de la izquierda incluye las horquillas; la de la derecha, no. El modelo recibe dos respuestas a la misma pregunta, así que deja clara la convención: incluir las horquillas o dejarlas fuera.
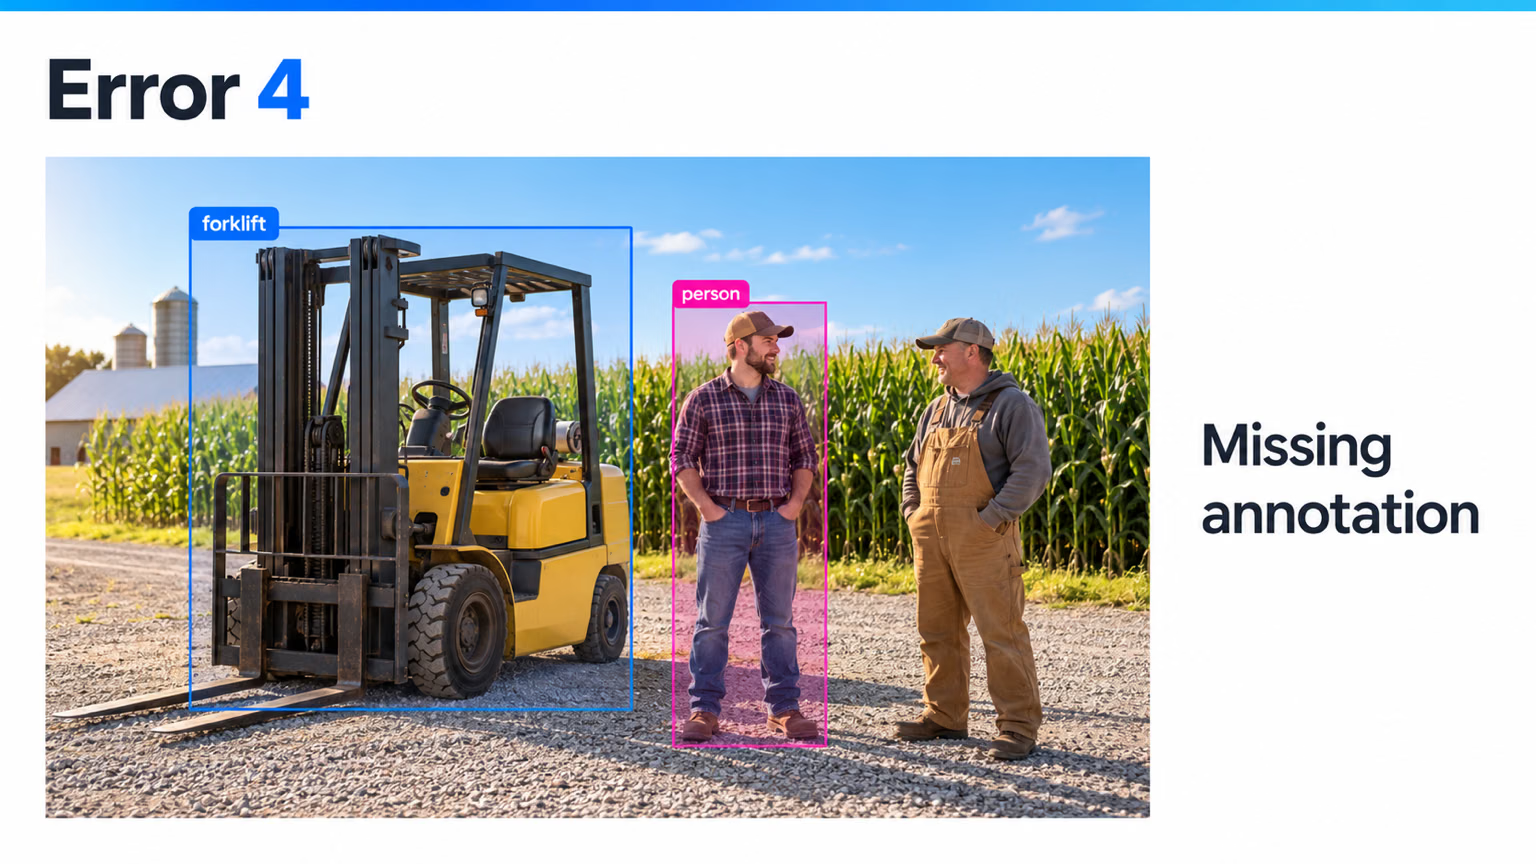
4. Anotaciones que faltan. Hay dos personas junto a la carretilla elevadora, pero solo una está delimitada. La que no está etiquetada se convierte en una lección de que «las personas son parte del fondo».
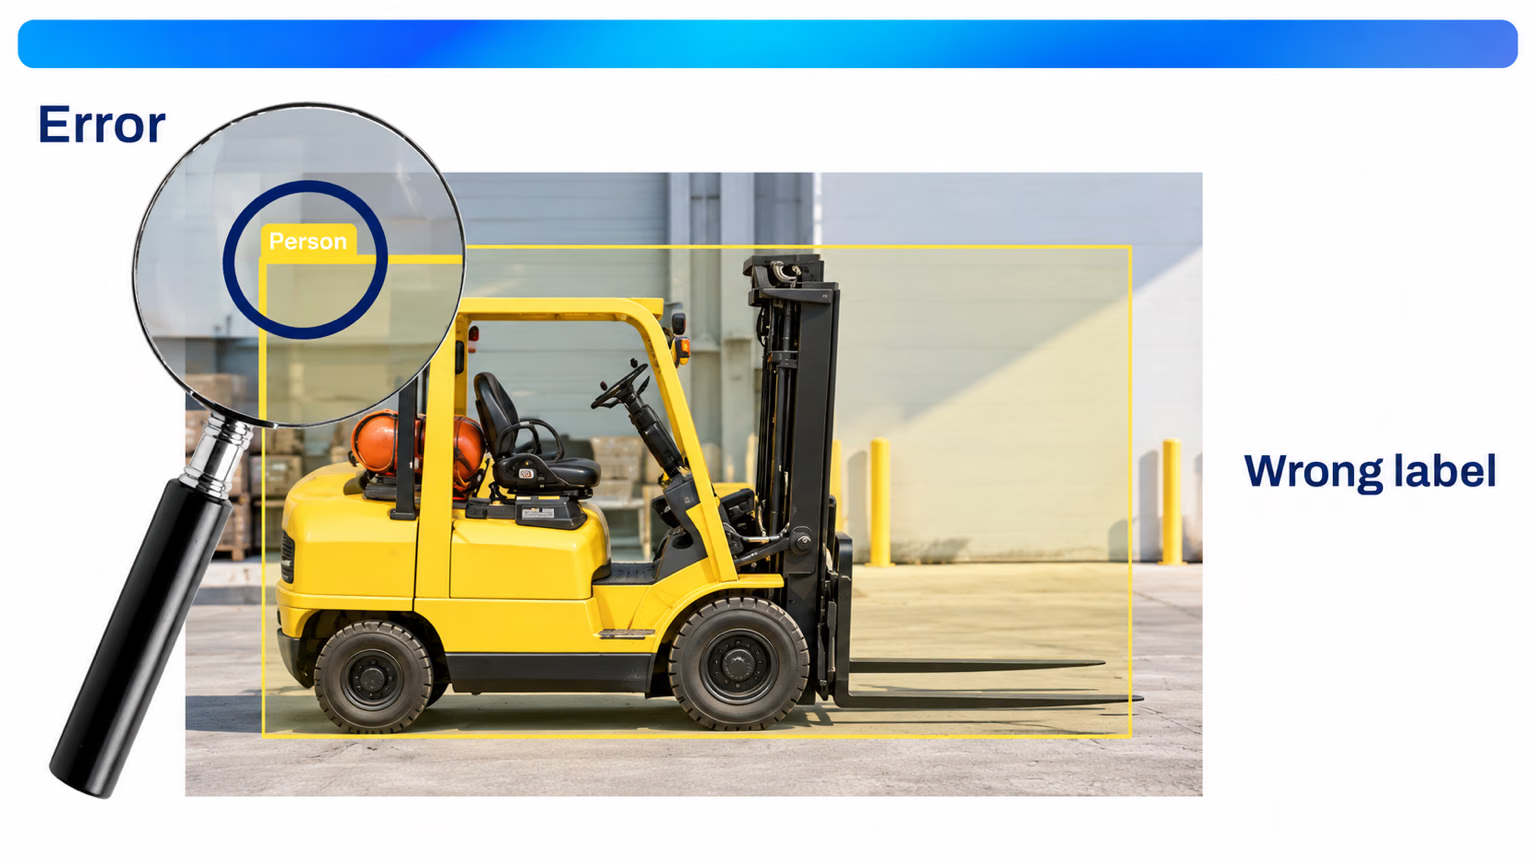
5. Clase incorrecta. Comprueba la clase, no solo el cuadro. Un cuadro correcto alrededor de una carretilla elevadora etiquetado como person corrompe ambas clases y suele deberse a un error al usar un atajo de teclado.
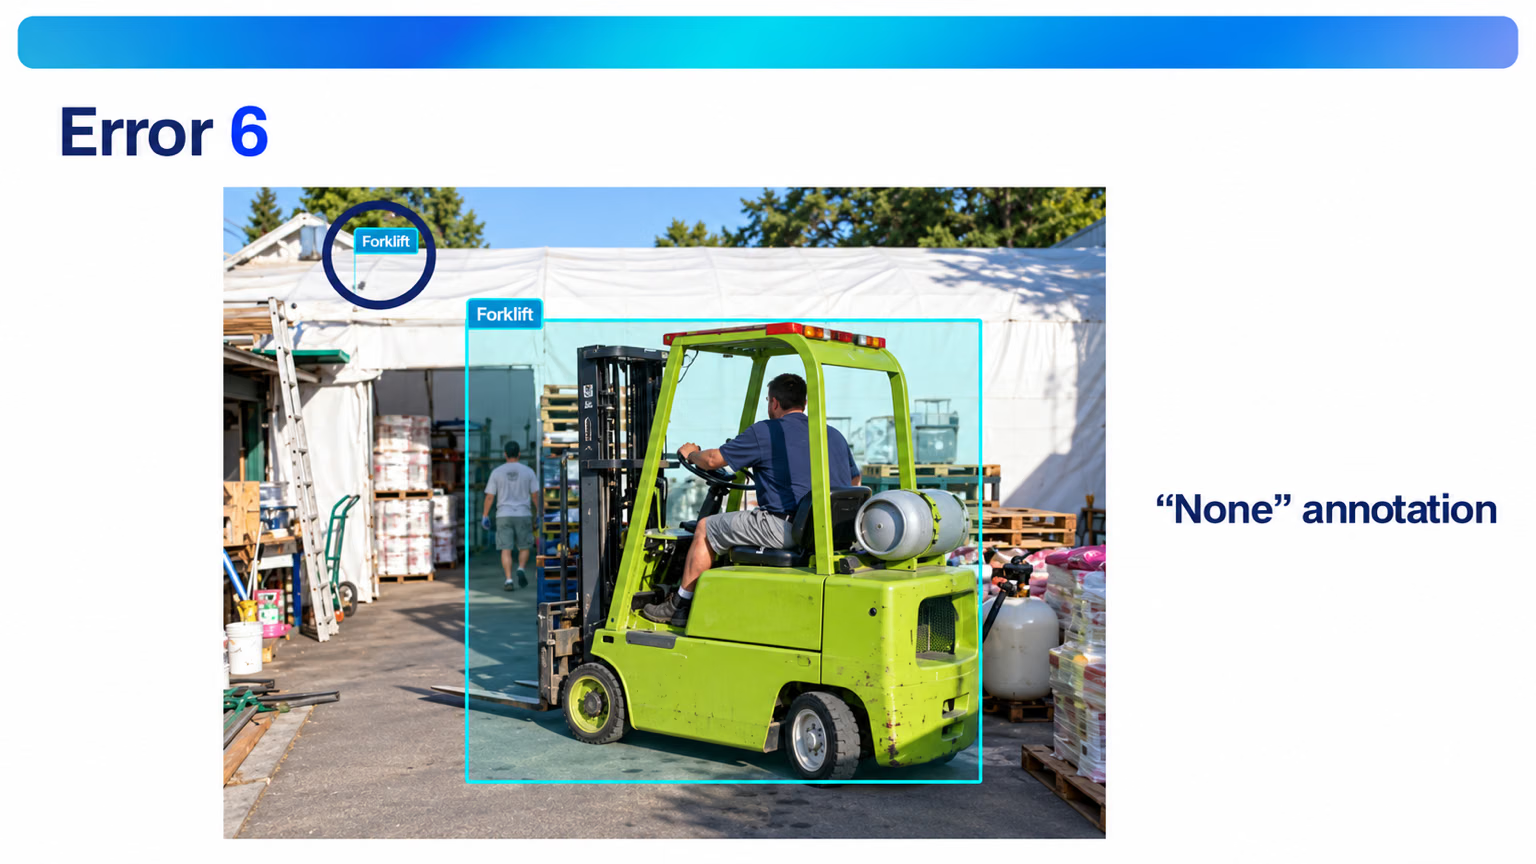
6. Anotaciones vacías o sobrantes. Cada anotación necesita un objeto real y una clase real. Un clic accidental deja un cuadro casi vacío como el de la esquina, y un cuadro guardado sin clase puede exportarse como None o como la clase 0. Corrígelos o elimínalos.
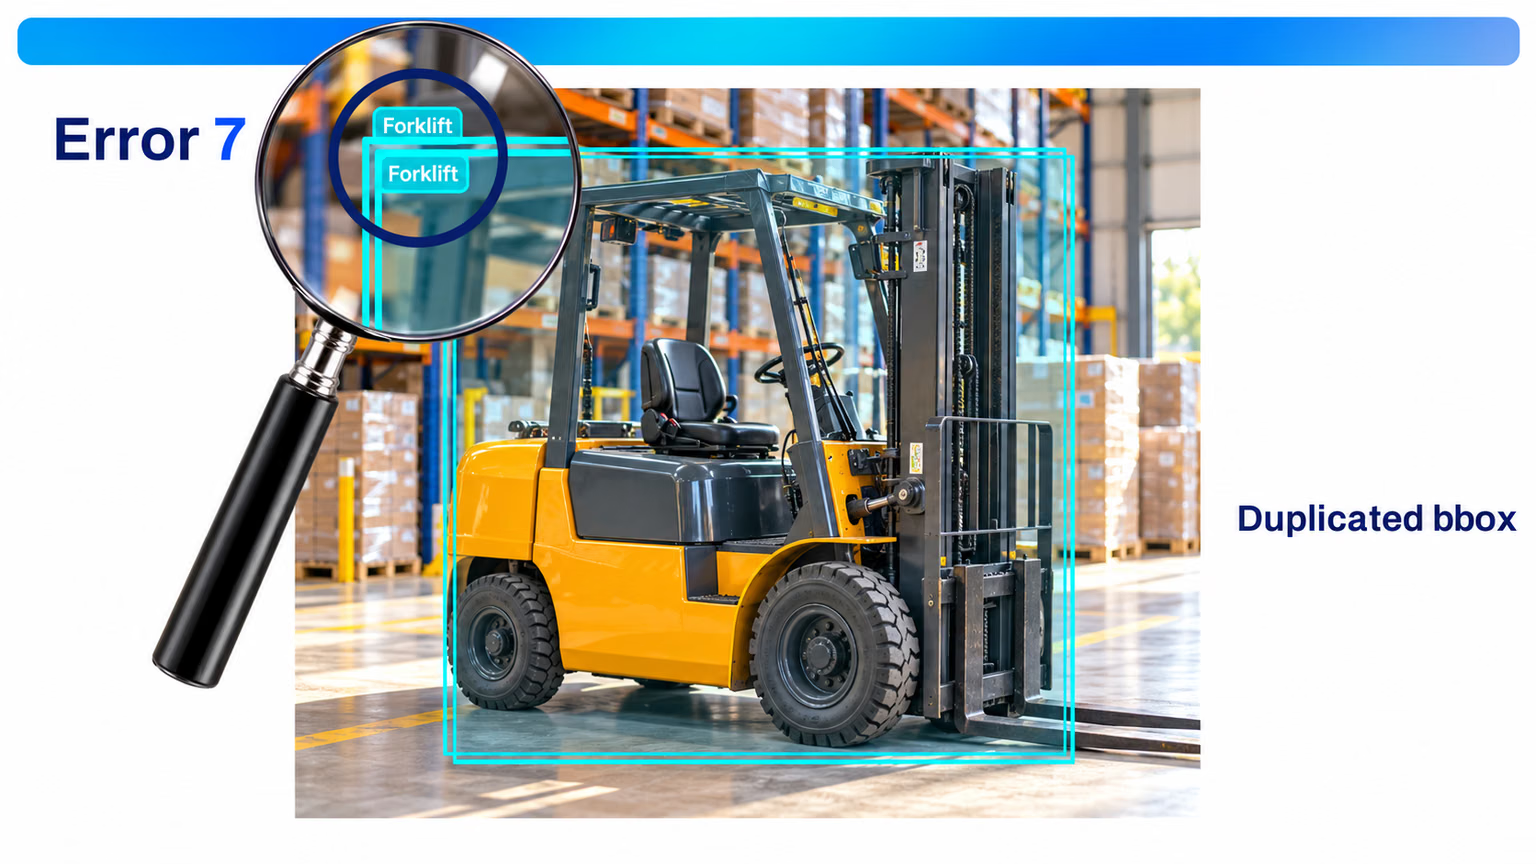
7. Cuadros duplicados. Un objeto, un cuadro. Dos cuadros superpuestos sobre la misma carretilla elevadora inflan el recuento de instancias y enseñan al modelo a predecir duplicados.
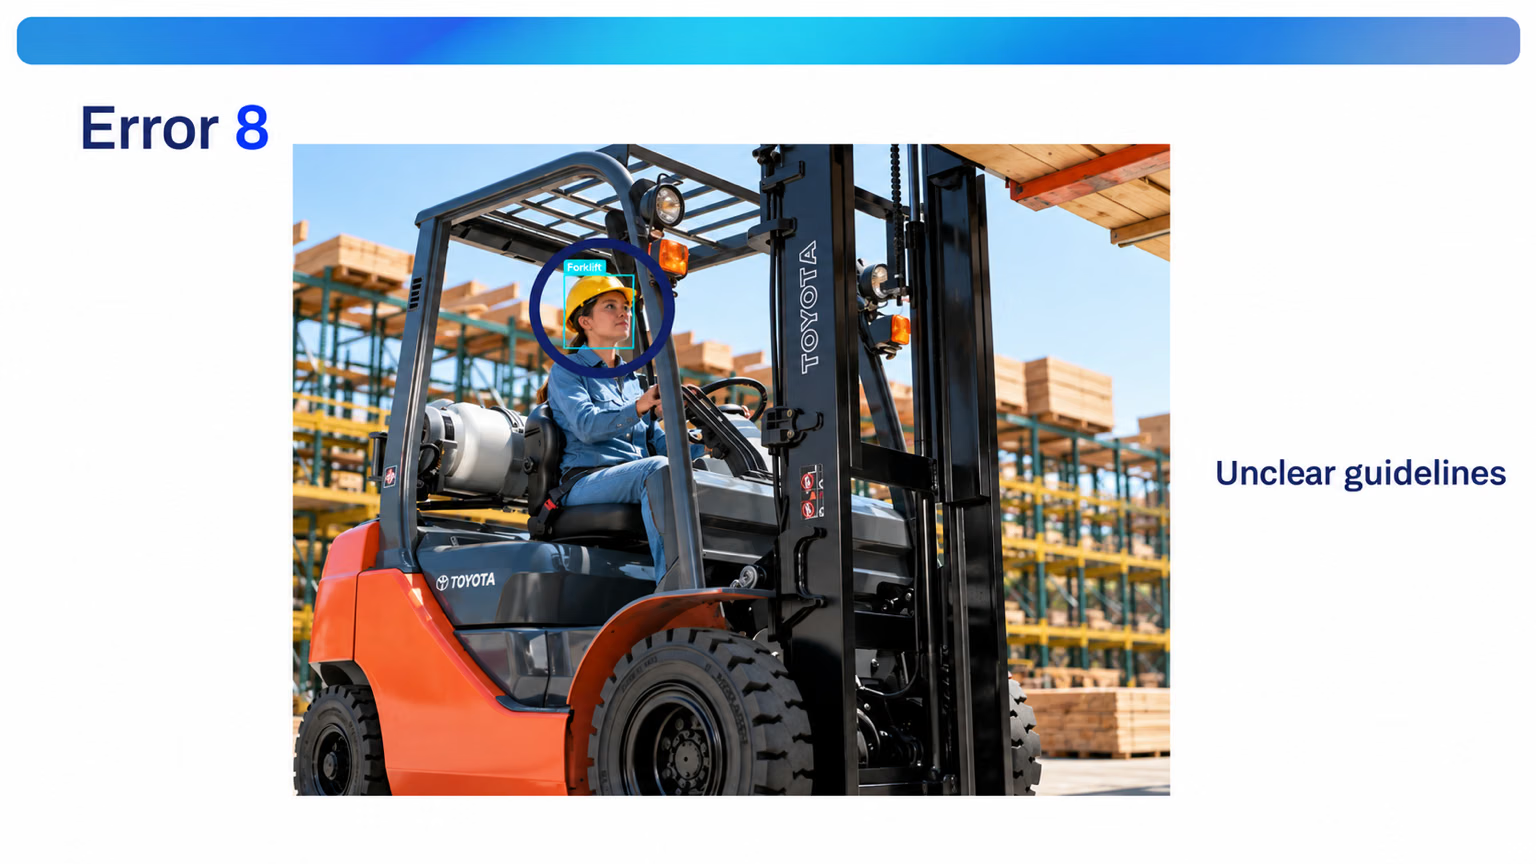
8. Directrices poco claras. Sin una regla por escrito, los anotadores improvisan: aquí, uno solo encuadró la cabeza del conductor y le asignó la clase forklift. ¿El conductor forma parte de la carretilla elevadora o es un person independiente? Resuélvelo una vez en la guía.
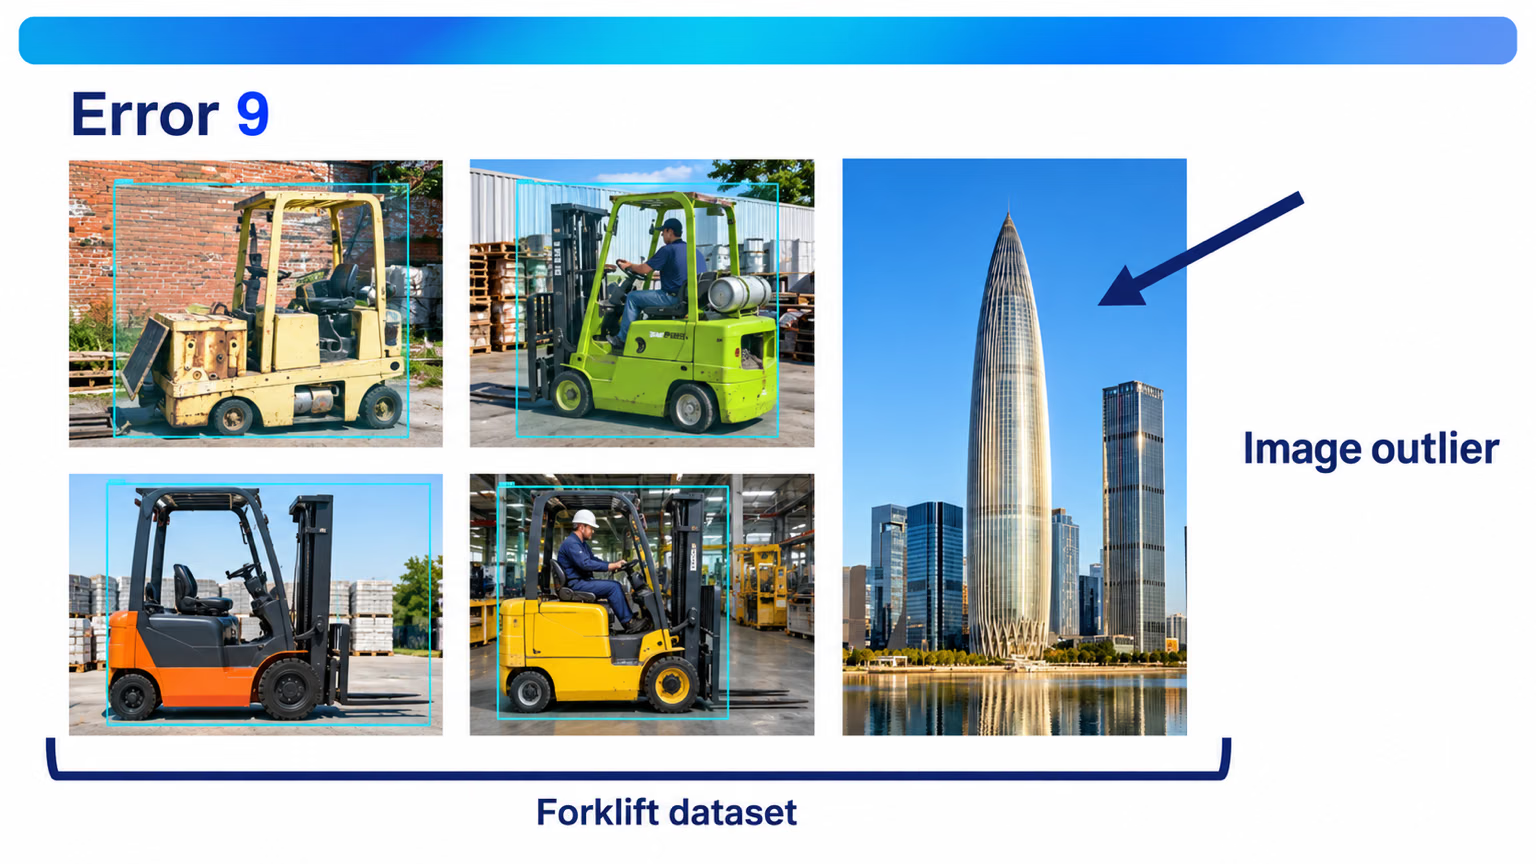
9. Imágenes atípicas. Descarta las imágenes que no se ajusten al entorno de despliegue. Una foto de un perfil urbano en un conjunto de datos de carretillas elevadoras no enseña nada útil y diluye todo lo demás.
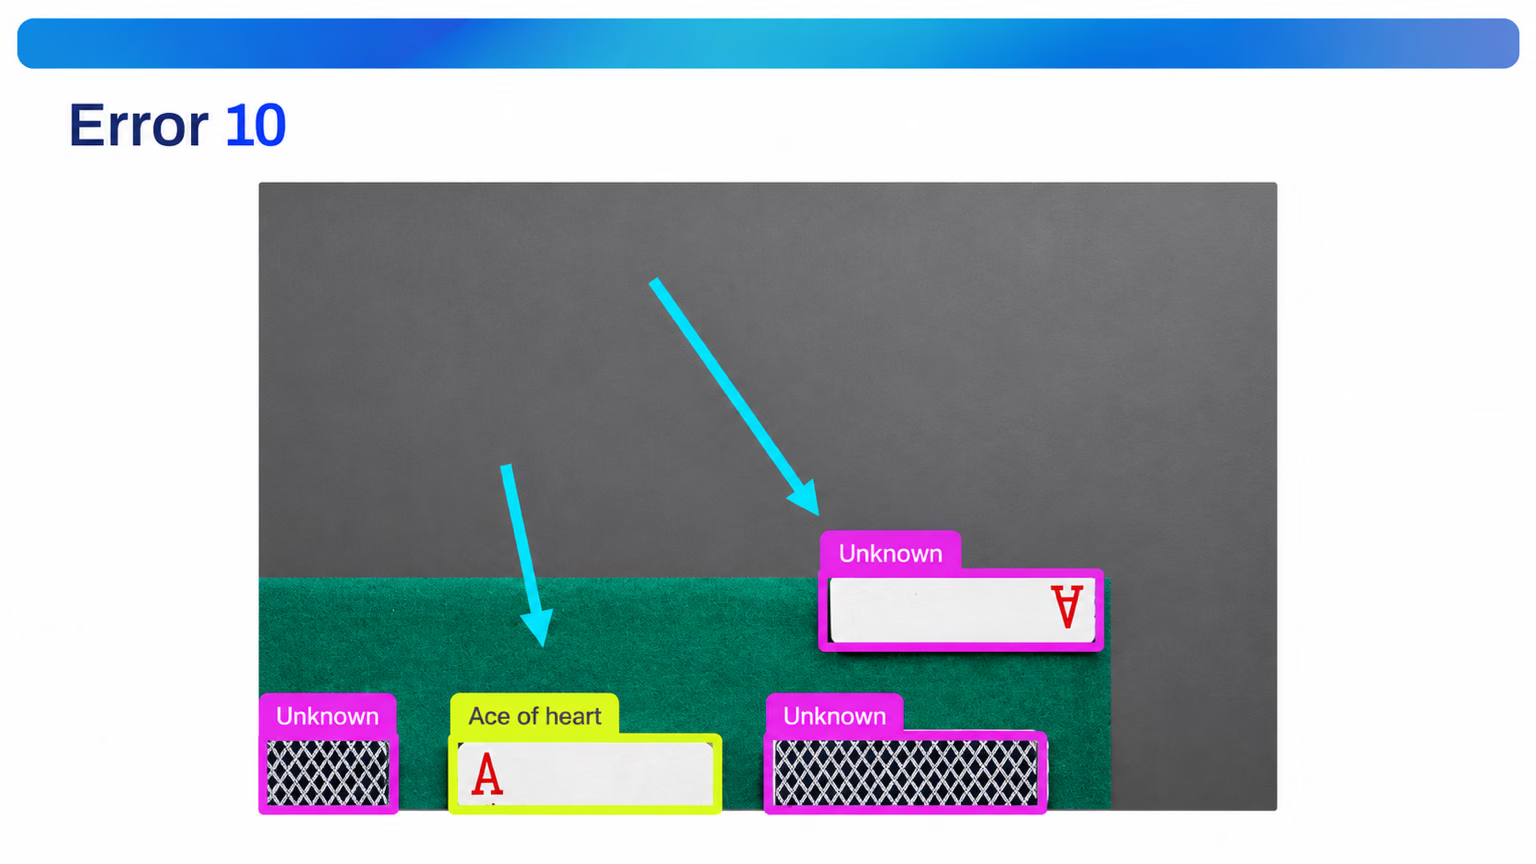
10. Ambigüedad inducida por el aumento de datos. Si un recorte puede eliminar el rasgo que define una clase, dos clases se vuelven idénticas. Recorta el símbolo de la esquina de un as de corazones y se parecerá a las cartas etiquetadas como unknown. Usa el aumento de datos con cuidado explica cómo solucionarlo.
Mide la concordancia, no la calcules a ojo#
Una ronda de calibración entrega las mismas imágenes a dos anotadores y compara sus etiquetas objeto por objeto. Dos etiquetas concuerdan si tienen la misma clase y una superposición con un IoU de al menos 0,5. Este script calcula la puntuación en las imágenes de val de COCO8. Para poder ejecutarlo sin una segunda persona, un modelo preentrenado hace de anotador B; si trabajas con un equipo real, lee los cuadros de B de sus archivos de etiquetas:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%Cómo interpretarlo:
- La puntuación es el número de objetos emparejados dividido entre el total de objetos dibujados por cualquiera de los anotadores: 8 de 17.
- Las discrepancias se concentran. Las nueve están en dos imágenes, y la mayoría corresponden a personas que ocupan bastante menos del 1 % del fotograma. No son nueve errores aleatorios; falta una regla: ¿etiquetamos a las personas lejanas?
- La solución es añadir una regla a la guía, por ejemplo: «Etiqueta a todas las personas que midan al menos 10 píxeles de alto en una imagen de 640 píxeles». Ambos anotadores vuelven a etiquetar esas dos imágenes y se mide de nuevo la puntuación.
La regla de decisión: amplía el etiquetado solo cuando la concordancia alcance el 90 %. Por debajo de ese umbral, cada nuevo anotador multiplica las incoherencias.
Usa la anotación inteligente para acelerar el proceso#
La anotación inteligente permite que un modelo YOLO o SAM proponga etiquetas que una persona acepta o corrige, lo que puede multiplicar varias veces el rendimiento. Avanza por rondas: entrena con un lote revisado, usa ese modelo para proponer el siguiente, revísalo y vuelve a entrenar. Ese es el ciclo de aprendizaje activo, y Anotación inteligente y etiquetado por lotes lo explica paso a paso en Ultralytics Platform.
Un modelo que no detecta a las personas pequeñas no propone cajas para ellas, y un revisor que pulsa «aceptar todo» nunca las añade. El siguiente modelo, entrenado con esas etiquetas, no las detectará con más confianza. Revisa todas las imágenes y añade lo que el modelo no haya detectado, además de corregir lo que haya dibujado.
Verifica visualmente#
Cada ejecución de entrenamiento de Ultralytics guarda labels.jpg y train_batch*.jpg en su carpeta de ejecución. El primero representa gráficamente el recuento de clases y las posiciones y tamaños de los cuadros; los demás muestran imágenes reales de entrenamiento con sus etiquetas superpuestas. Ábrelos antes de que termine la primera época. La vista detecta lo que las métricas nunca detectarán: cuadros dibujados alrededor de sombras, ID de clase intercambiados y polígonos sin cerrar.
Mostrar solución
Las discrepancias de COCO8 se convierten en entradas de la guía como estas:
| Discrepancia | Regla añadida a la guía |
|---|---|
Personas lejanas en 000000000049.jpg etiquetadas solo por A | Etiqueta a todas las personas que midan al menos 10 píxeles de alto en una imagen de 640 píxeles; omite las más pequeñas en todas las imágenes. |
| Planta en maceta en el borde del fotograma etiquetada solo por A | Etiqueta un objeto cortado por el borde del fotograma si se ve al menos la mitad. |
Elefante parcialmente oculto por otro elefante en 000000000061.jpg | Etiqueta a los animales ocluidos si se ve la cabeza o la mitad del cuerpo; encuadra solo la parte visible. |
Para comparar a dos personas en vez de a una persona y un modelo, lee las filas del anotador B de la segunda carpeta de etiquetas, igual que el script lee las de A (Path("labels_b", image.stem + ".txt")), crea b_cls y b_box a partir de ellas con las mismas dos líneas y úsalas donde el script lee b.cls y b.xyxyn. Vuelve a ejecutar el script después de volver a etiquetar; la ronda termina cuando la puntuación supera el 90 %.