Anotación inteligente y etiquetado por lotes
Elige un modelo de etiquetado y un umbral de confianza midiendo el trabajo de revisión; después, ejecuta la anotación por lotes y comprueba el resultado con la tasa de edición.
Dibujar cajas a mano permite procesar quizá 100 imágenes por hora; revisar buenas preetiquetas puede ser varias veces más rápido. Pero un modelo de etiquetado con un umbral de confianza inadecuado puede generar más trabajo del que ahorra, y si no revisas sus resultados, el siguiente modelo aprenderá sus errores. En esta lección medirás el trabajo de revisión para cada umbral con datos reales etiquetados, para que elijas el umbral basándote en cifras y no en suposiciones.
Práctico
Tres formas de preetiquetar#
En el editor de anotaciones, el modo Draw (V) es manual y el modo Smart (S) permite que un modelo proponga etiquetas:
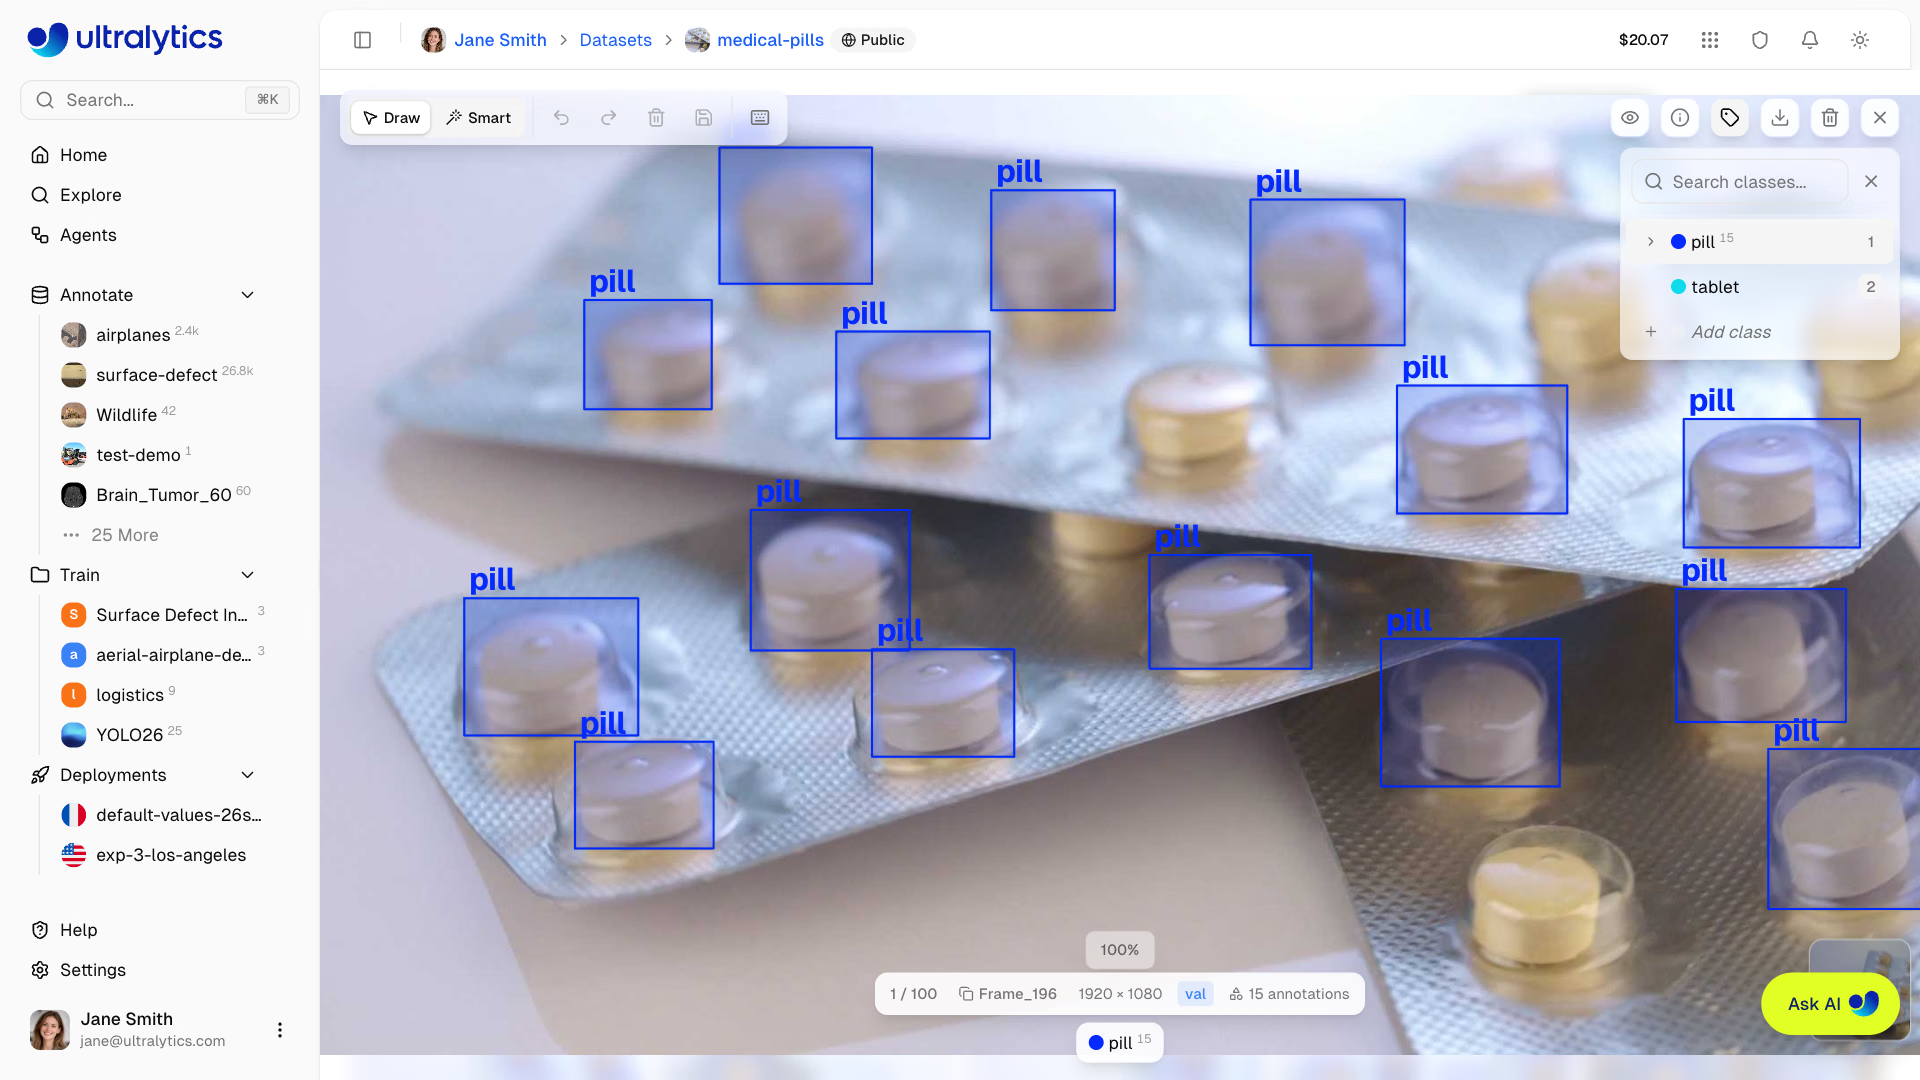
| Familia | Funcionamiento | Tareas | Coste |
|---|---|---|---|
| SAM (SAM 2.1 Tiny a Large, SAM 3, SAM 3.1 predeterminado) | Haz clic en un objeto para crear una máscara; haz clic fuera para añadirla y dentro para restarla; A activa o desactiva la aplicación automática | Detección, segmentación, semántica, OBB | Gratis |
| YOLO (modelos oficiales o propios) | Predict añade las detecciones del modelo; Map classes alinea las clases del modelo y del conjunto de datos; se omiten los duplicados con IoU de 0,7 o más | Detección, segmentación, semántica, OBB, pose | Gratis en el editor |
| Basados en clases indicadas (Moondream 3.1 predeterminado, YOLOE-26x, SAM 3 Text y otros) | Busca en la imagen los nombres de clase del conjunto de datos; los modelos de proveedores de pago se ejecutan con tu propia clave de API | Conjuntos de datos de detección con entre 1 y 200 clases | Modelos alojados gratuitos |
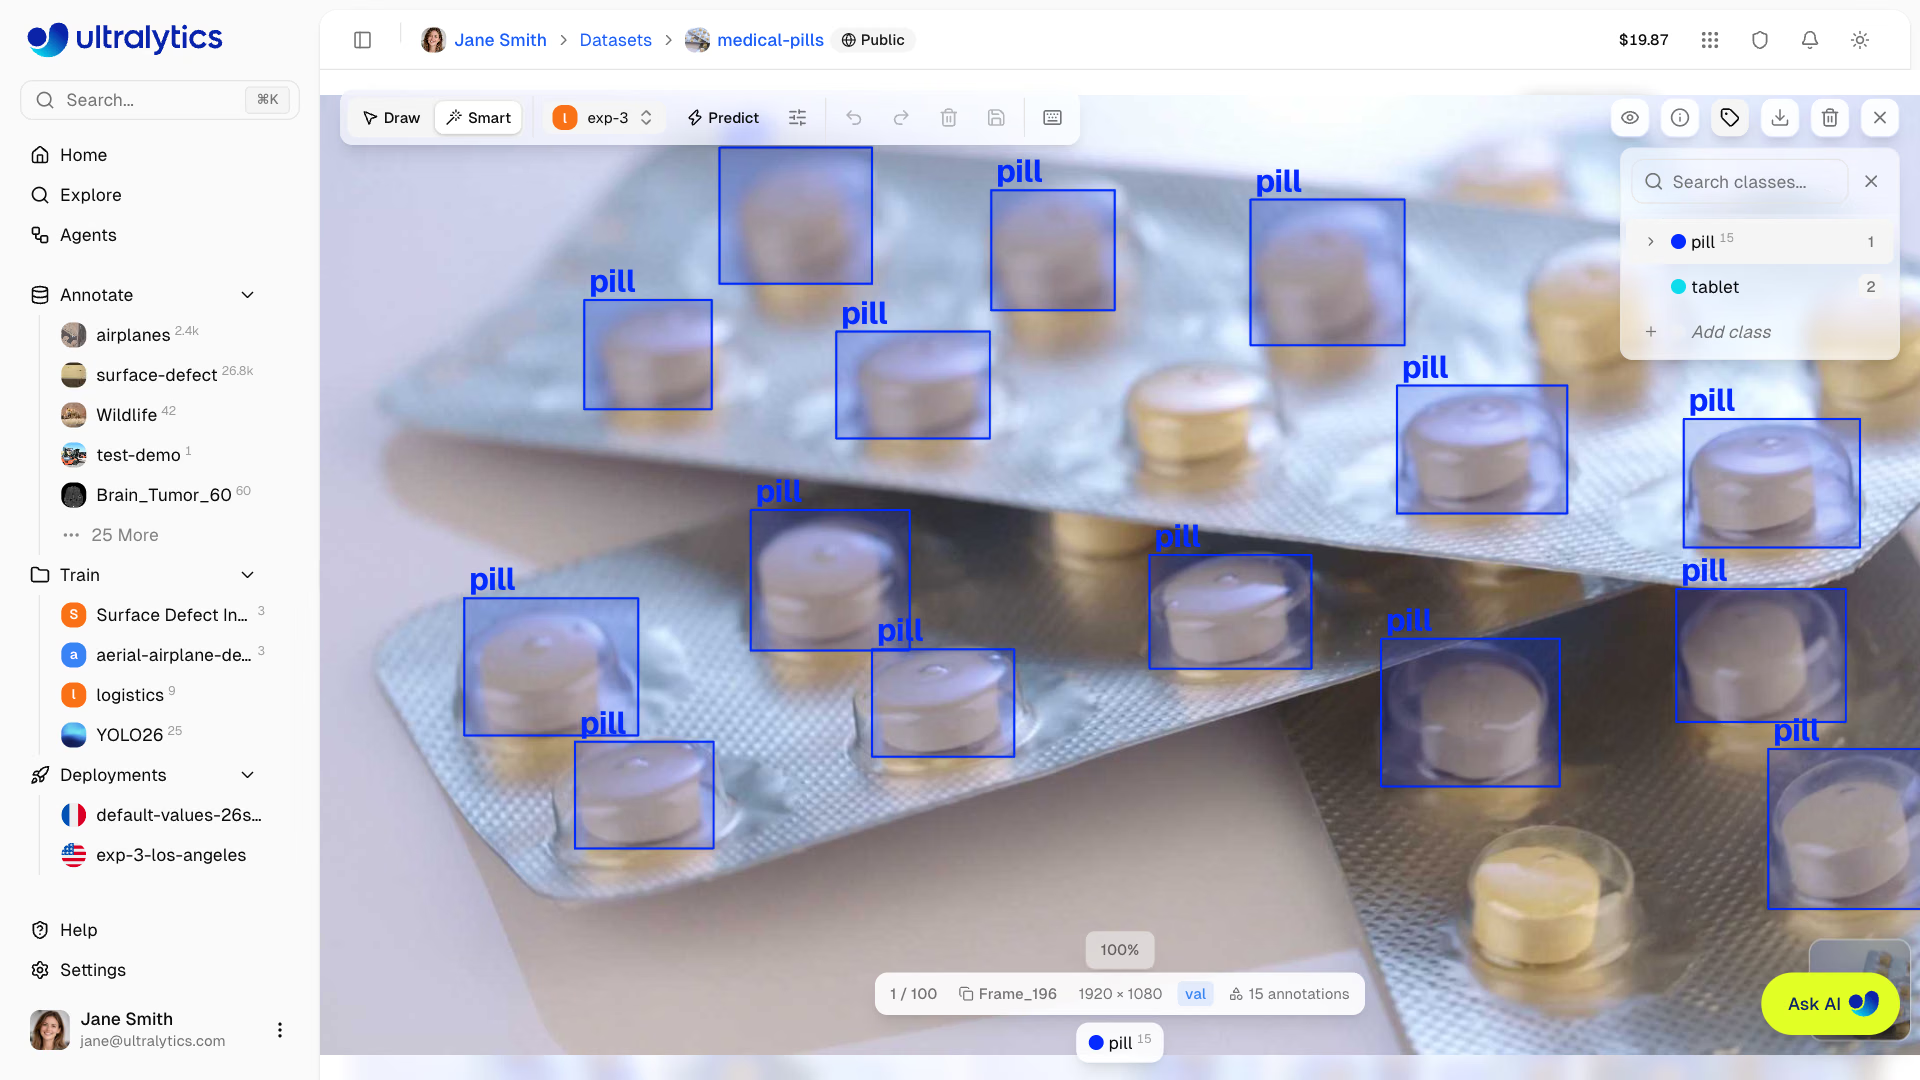
SAM requiere un clic por objeto y genera las formas más ajustadas. Las predicciones del modelo requieren un clic por imagen y su calidad depende del modelo, así que el resto de esta lección trata sobre cómo elegirlo y ajustarlo.
Elige el modelo de etiquetado#
Un modelo v0 poco potente entrenado con 100–200 etiquetas manuales sigue siendo mejor que empezar desde cero, y para v1 suele ser un compañero útil de aprendizaje activo. El rendimiento de los modelos basados en clases indicadas varía mucho según el dominio: algunos detectan casi todo en fotos cotidianas, pero se les escapan la mayoría de los objetos en imágenes de PCB, radiografías o tiendas; por eso, comprueba diez predicciones antes de confiar en uno.
Ejemplo práctico: mide el trabajo de revisión para cada umbral#
El umbral de confianza determina en qué emplean su tiempo los revisores: si es demasiado bajo, borran cajas falsas; si es demasiado alto, dibujan las cajas que el modelo ha omitido. Mídelo con imágenes que ya tengan etiquetas correctas; aquí se usan las 128 imágenes etiquetadas de COCO128 y un YOLO26n preentrenado como modelo de etiquetado:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Cómo funciona y qué indican los resultados:
- El modelo predice una vez con un valor
conf=0.05bajo; luego, cada umbral filtra las mismas predicciones, así que probar varios umbrales es rápido. review_workempareja cada predicción con una caja de referencia de la misma clase cuyo IoU sea de 0,5 o más. Las predicciones sin emparejar son cajas que un revisor borra; los objetos de referencia sin emparejar son objetos que un revisor dibuja.- El número de ediciones por imagen alcanza su mínimo entre 0,25 y 0,4 (4,7). Por debajo de ese intervalo, se disparan los borrados; por encima, las omisiones.
- Incluso con el mejor umbral, los revisores dibujan unas 3,6 cajas por imagen, porque los muchos objetos pequeños de la cola larga de COCO son difíciles de detectar para un modelo nano.
Reglas para decidir: elige el umbral con menos ediciones por imagen. Si dibujar predomina con todos los umbrales, el modelo de etiquetado es demasiado débil para los datos; usa un modelo más grande o el que has ajustado. Si borrar predomina incluso con un umbral de 0,5, el modelo confunde clases parecidas; comprueba la matriz de confusión antes de etiquetar más. En tu propio proyecto, prueba varios umbrales con tu modelo ajustado en 50–100 imágenes que ya hayas etiquetado.
Ejecuta la anotación por lotes#
La anotación por lotes ejecuta un modelo YOLO o basado en clases indicadas en todo el conjunto de datos. Ábrela desde Más acciones > Anotación por lotes o selecciona Anotar todo en la notificación que aparece tras una predicción en el editor:
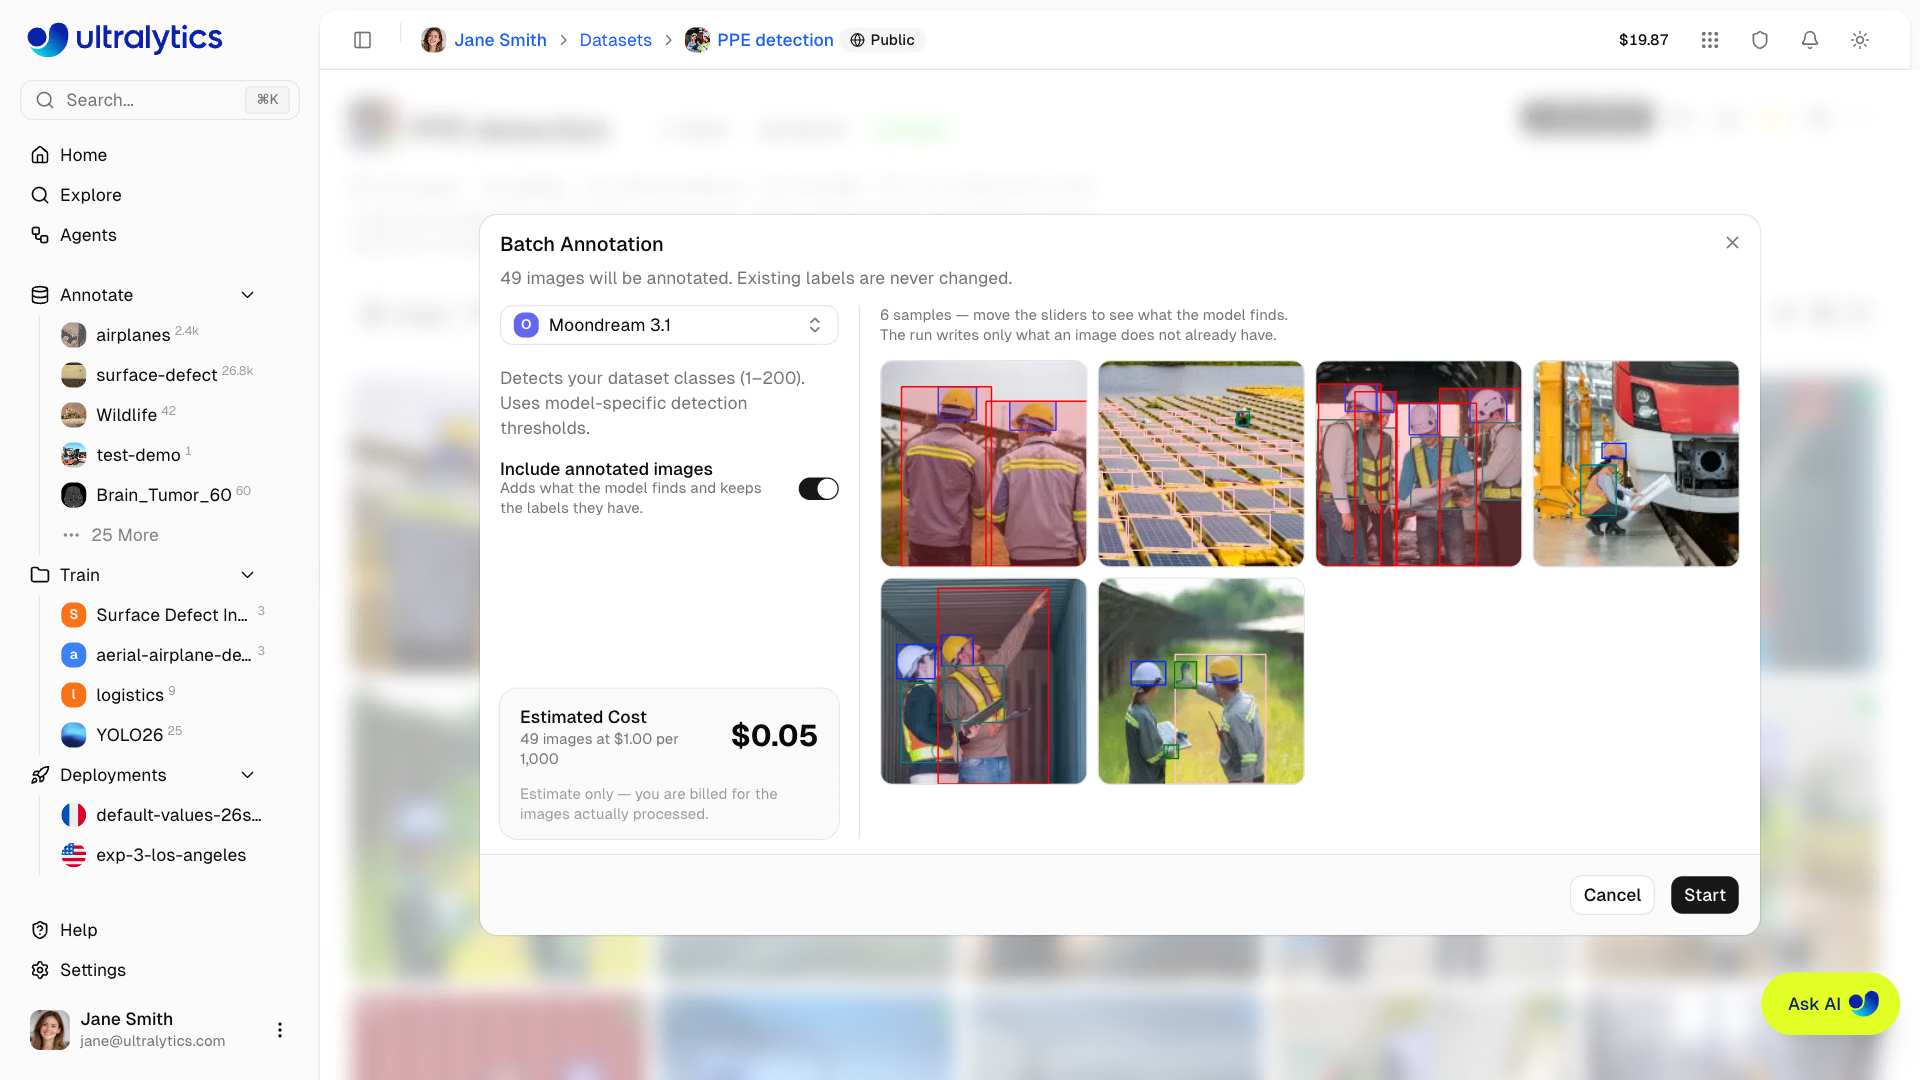
- Elige el modelo. Los conjuntos de datos de detección se abren con Moondream 3.1 seleccionado; cámbialo por tu modelo ajustado o tu modelo YOLO.
- Si usas un modelo YOLO, configura la confianza con el umbral elegido al probar varios valores (el valor predeterminado es
0.25) y el IoU (0.7), y comprueba los ejemplos de predicciones. - Deja desactivada la opción Incluir imágenes anotadas para etiquetar solo las imágenes sin etiquetar.
- Comprueba el Coste estimado (1,00 $ por cada 1000 imágenes; mínimo de 0,01 $) y haz clic en Iniciar.
Al iniciar una ejecución, primero se guarda una versión del conjunto de datos para que puedas restaurar el estado anterior. Detener conserva y cobra las imágenes procesadas hasta ese momento.
Revisa las imágenes y, después, mide la tasa de edición#
Las predicciones se guardan como anotaciones normales, así que nada indica que estén sin revisar. Filtra por clase para comprobar primero las clases poco frecuentes y ordena por Anotaciones de forma ascendente (posibles omisiones) y descendente (escenas abarrotadas en las que se fusionan las cajas). Después, crea una versión, abre Comparar versiones en la pestaña Versions y selecciona v_auto como versión Desde:
| Recuento | Significado |
|---|---|
| Añadidos | Objetos que el modelo no detectó, más la copia corregida de cada caja modificada |
| Eliminados | Falsos positivos, más la versión original de cada caja modificada |
| Tasa de edición | (añadidos + eliminados) ÷ anotaciones en v_auto; es un límite superior porque cada caja corregida cuenta dos veces |
Registra la tasa de edición de cada lote. Si aumenta, es una señal de alerta temprana de que las imágenes nuevas se han alejado de lo que conoce el modelo de etiquetado. La lección sobre buenas prácticas de anotación trata las guías de etiquetado y la concordancia entre revisores.
Errores habituales#
Síntoma: cada nuevo entrenamiento obtiene más o menos la misma puntuación y siempre se pasan por alto los mismos objetos. Solución: las preetiquetas sin revisar incorporan los errores sistemáticos del modelo de etiquetado al conjunto de datos como si fueran verdaderos: clases parecidas, bordes de cajas sistemáticamente holgados u objetos que nunca detecta. Revisa todas las imágenes antes de que se incorporen a una versión de entrenamiento.
Síntoma: termina la anotación por lotes, pero la mayoría de los objetos siguen sin etiquetar. Solución: ejecuta primero el modelo en el editor con diez imágenes representativas. Si no detecta más que unos pocos objetos, etiqueta manualmente un conjunto inicial y entrena una versión v0.
Síntoma: las cajas predichas tienen nombres de clase incorrectos. Solución: cuando las clases del modelo difieren de las del conjunto de datos, el paso Map classes asigna cada clase del modelo a una clase del conjunto de datos o la omite. Asigna las clases con cuidado; una asignación incorrecta cambia la etiqueta de todas las cajas de esa clase.
Mostrar solución
Ejemplo práctico: el barrido elige 0.35 para un ajuste fino de inspección de pastillas. La anotación por lotes guarda v4 con 1,240 anotaciones. Tras la revisión, Comparar versiones v4 → v5 muestra 96 elementos añadidos y 152 eliminados, así que la tasa de edición es (96 + 152) ÷ 1,240 = 20 %. Si hay más elementos eliminados que añadidos, significa que el modelo predice de más: al inspeccionar los cuadros eliminados, ves que el modelo marca como pastillas los reflejos de los blísteres. De ahí se derivan dos acciones: aumenta un paso la confianza (0.35 → 0.45) para el siguiente lote y confirma que la tasa disminuye; y añade 30 imágenes revisadas de envases brillantes a la siguiente versión de entrenamiento para que el ajuste fino aprenda a distinguirlos.