Depurar, eliminar duplicados y dividir
Detecta duplicados entre particiones y carencias de clases con dos scripts breves, divide el conjunto según la unidad que importa y fija una versión auditada.
La validez de una puntuación de validación depende de la calidad de la partición. COCO128, un conjunto de datos de demostración popular, utiliza por diseño las mismas 128 imágenes para entrenamiento y validación; si cometes ese mismo error en tus propios datos, obtendrás un modelo «excelente» que fallará con la siguiente cámara. En esta lección realizarás dos auditorías con datos reales: una comprobación de duplicados y una auditoría de clases por partición. Después, dividirás los datos por cámara y fijarás una versión que haya superado ambas.
Práctico
Ejemplo práctico: detectar imágenes compartidas entre particiones#
La plataforma conserva una copia de cada imagen por partición y te pregunta cómo gestionar las colisiones durante la carga, pero nada impide que la misma imagen o escena acabe tanto en entrenamiento como en validación. Compruébalo antes de cargar los datos y también después de combinar conjuntos de datos:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']Todas las imágenes de validación de COCO128 también son imágenes de entrenamiento. Es intencionado en un conjunto de datos para pruebas rápidas, y precisamente por eso su mAP de validación no dice nada sobre la capacidad de generalización. En tus datos, cualquier recuento distinto de cero indica una filtración: mueve o elimina una copia de cada imagen antes de entrenar.
Detecta duplicados aproximados con Clustering#
Los hashes solo detectan bytes idénticos. Los fotogramas de vídeo consecutivos, las fotos en ráfaga y las copias recodificadas difieren en unos pocos píxeles. Abre el icono del gráfico de dispersión en la barra de herramientas de la galería y haz clic en Analyze Dataset (de 20 a 200 000 imágenes; solo conjuntos de datos cargados):
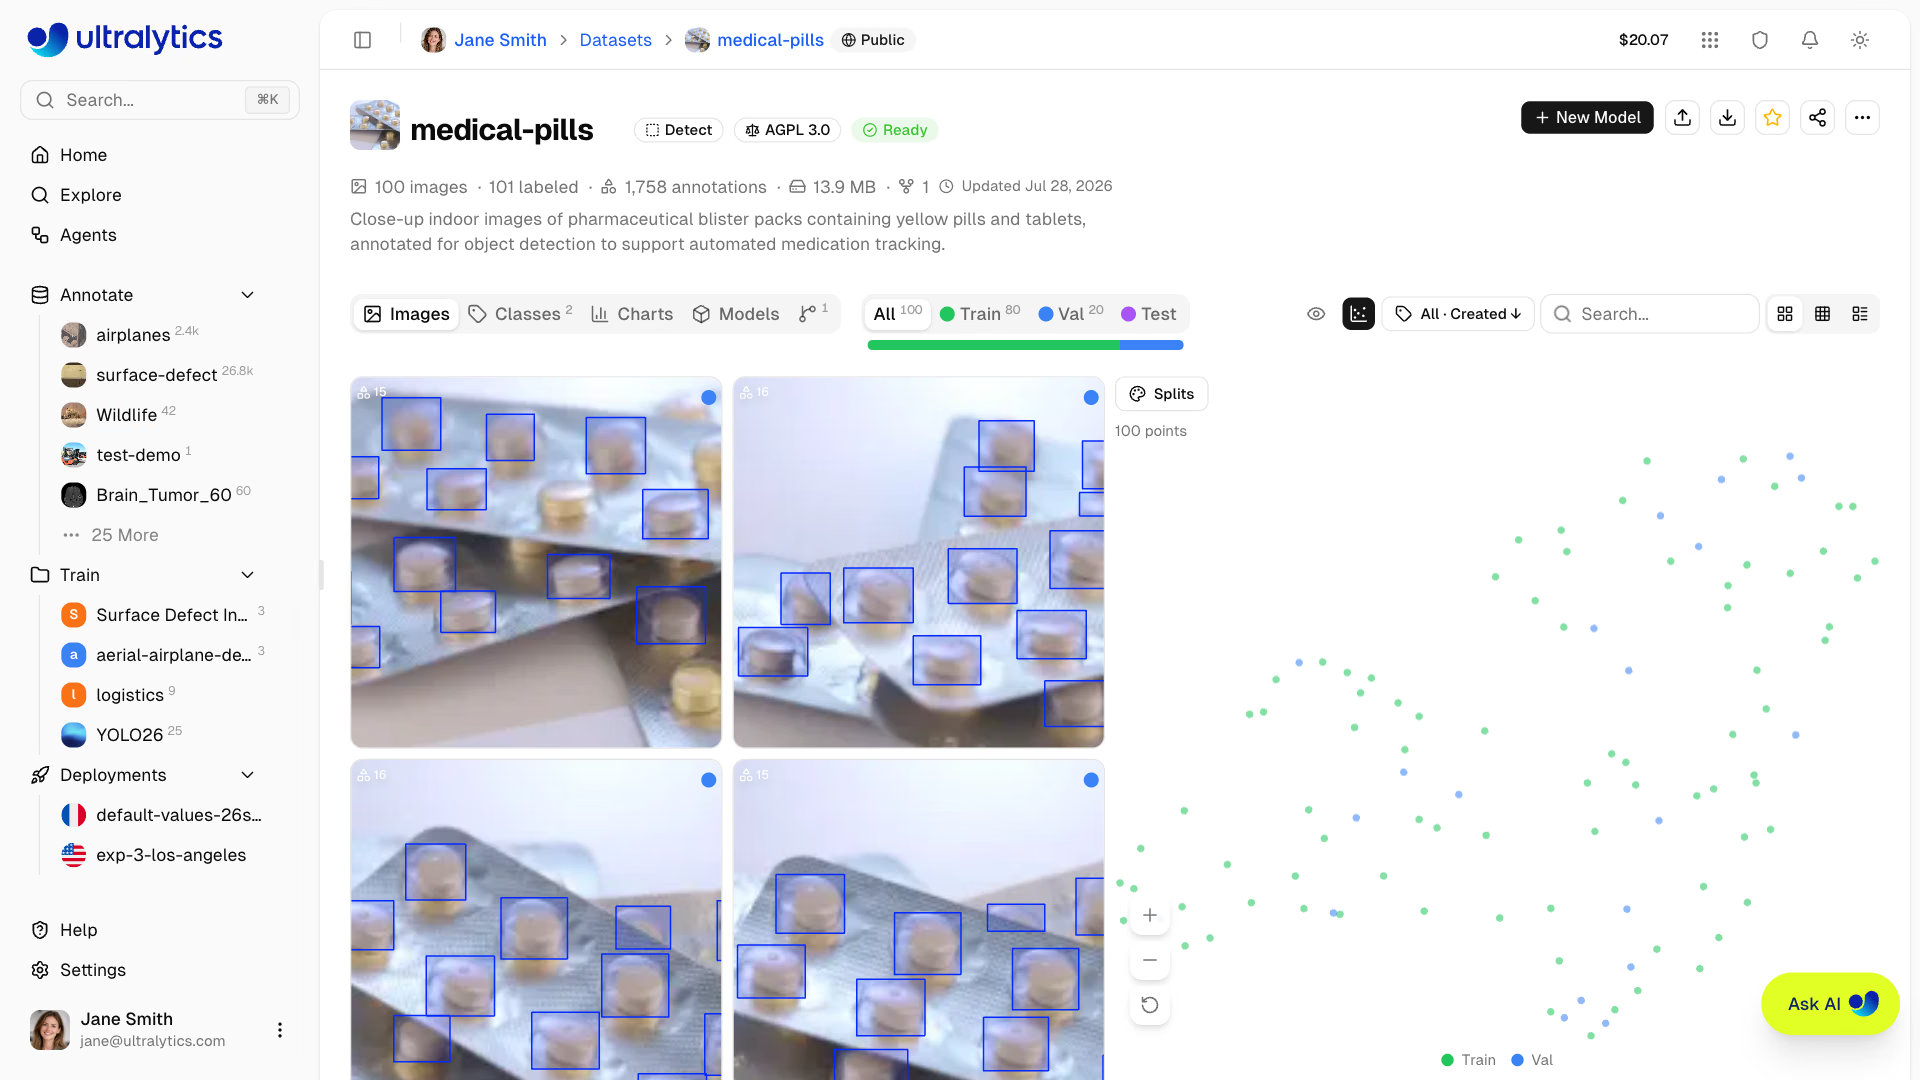
- Colorear por partición: una isla compacta que mezcla puntos de entrenamiento y validación indica una filtración por duplicados aproximados.
- Colorear por clústeres o clases: una isla enorme de una sola clase muestra qué está sobrerrepresentado en el conjunto de datos; los puntos aislados son valores atípicos (cámara incorrecta, fotograma dañado, imagen mal etiquetada).
- Selecciona con el lazo o haz clic en una región para filtrar la galería y mostrar esas imágenes (hasta 1 000); después, elimínalas, muévelas o vuelve a etiquetarlas.
Las mismas incrustaciones permiten Buscar imágenes similares en el menú contextual de la imagen, que añade imágenes parecidas de conjuntos de datos públicos y del equipo a train como imágenes sin etiquetar: la forma más rápida de cubrir una carencia que detecte la auditoría de abajo.
Ejemplo práctico: auditar las clases por partición#
Descarga la exportación NDJSON desde el encabezado del conjunto de datos o desde la pestaña Versiones. Cada línea después del encabezado corresponde a una imagen con su partición y sus etiquetas, así que bastan unas pocas líneas de Python para contar todas las clases en cada partición. Aquí se ejecuta con la exportación pública de COCO8:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valAl leerlo: la línea del encabezado contiene class_names; cada cuadro de detección es [class, x, y, w, h]. Ausente en entrenamiento significa que el modelo no puede aprender esa clase, y su AP de validación será cero. Muy pocos ejemplos en validación significa que su AP variará mucho entre ejecuciones: con 7 palés en validación, basta con no detectar un palé para que el AP de palés cambie unos 14 puntos. COCO8 es una prueba rápida con 8 imágenes, así que todas las clases fallan; tu versión de producción no debería mostrar ninguna alerta. Soluciona las carencias recopilando más ejemplos, no ajustando parámetros.
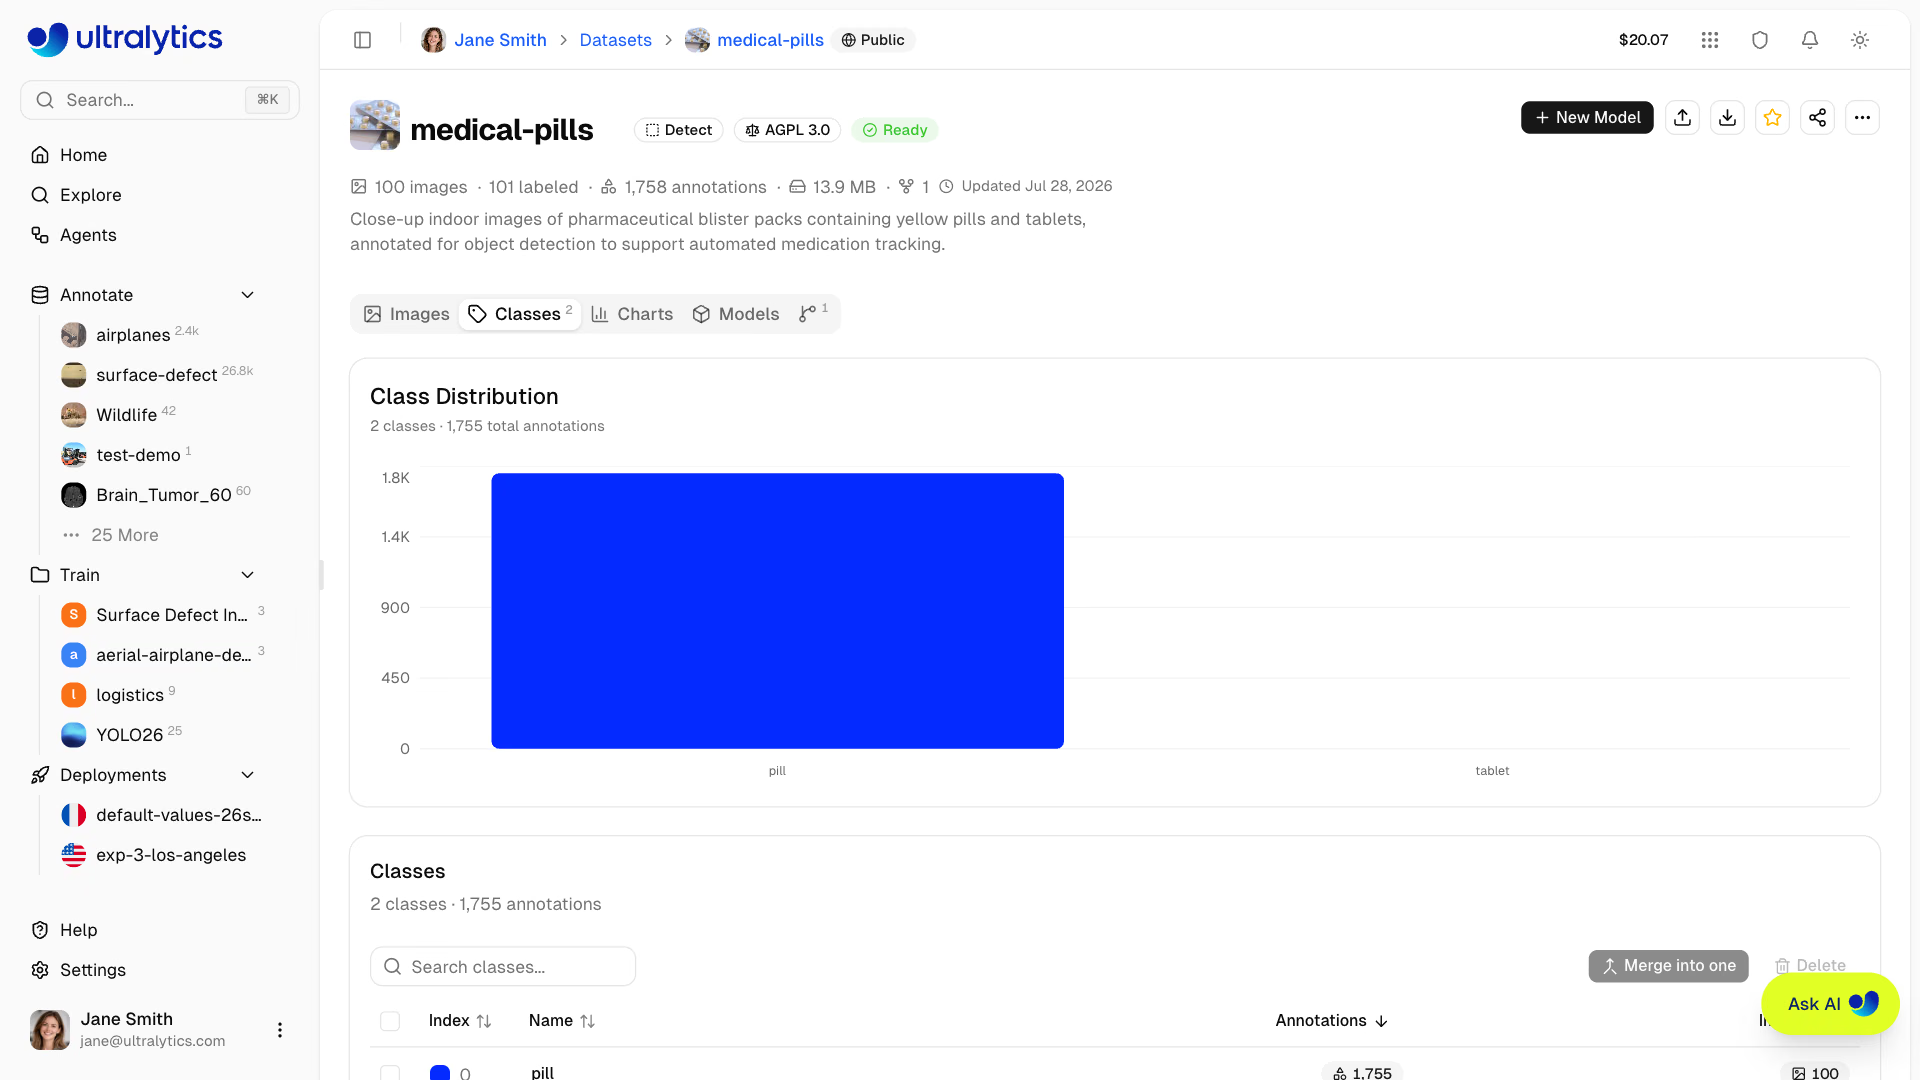
La pestaña Classes muestra los mismos recuentos para el conjunto de datos activo e incluye una opción de escala logarítmica para datos desequilibrados. Combinar en una agrupa clases duplicadas como car, automobile y vehicle en una sola clase sin perder anotaciones; Eliminar borra una clase y todas sus anotaciones.
Divide el conjunto según la unidad para la que quieras generalizar#
Los fotogramas de una misma cámara, sesión o día están correlacionados. Si aparecen tanto en entrenamiento como en validación, el modelo se evalúa con escenas que ya ha visto. Reserva unidades completas de aquello que varíe en producción: si habrá cámaras nuevas, reserva cámaras; si serán las mismas cámaras en días nuevos, reserva días.
Las herramientas de división de la plataforma se diferencian precisamente en este aspecto:
| Herramienta | Cómo asigna | Uso |
|---|---|---|
Carpetas train/, val/, test/ en una carga | Conserva tu asignación | Divisiones por grupos preparadas sin conexión |
| Filtro de partición definido antes de cargar | Todos los archivos de esa carga van a la partición seleccionada | Cargar una cámara por partición |
| Mover a partición en la vista de tabla | Mueve las imágenes seleccionadas | Corregir imágenes concretas |
| Barra de particiones, Redistribuir particiones | Reasigna aleatoriamente todas las imágenes | Solo para fotos independientes |

La lección Dividir correctamente el conjunto de datos explica cómo elegir la unidad; para conjuntos de datos muy pequeños, la validación cruzada k-fold permite extraer más información. Para comprobar los grupos después de la carga, añade una clave de grupo a la auditoría de clases (por ejemplo, record["file"].split("_")[0] para archivos llamados cam07_000123.jpg, o un campo camera en los metadatos de las imágenes) e indica cualquier grupo que aparezca en dos particiones.
Fija una versión que haya superado la auditoría#
El entrenamiento necesita una instantánea fija. En la pestaña Versions, introduce una descripción («v5: cam07 reservada, +80 imágenes de palés») y haz clic en New Version. Cada versión es una instantánea NDJSON numerada e inmutable que puedes descargar, comparar o restaurar; el botón Save Dataset Version del cuadro de diálogo de entrenamiento hace lo mismo al iniciar y reutiliza una versión coincidente si no ha cambiado nada. Las versiones no están disponibles para conjuntos de datos conectados a la nube ni para los alojados en las instalaciones.
Errores habituales#
Síntoma: tras hacer clic en Auto 80/20, el mAP de validación se dispara y la precisión en producción no mejora. Solución: Redistribute Splits reasigna aleatoriamente todas las imágenes (y elimina los duplicados exactos durante el proceso), por lo que coloca fotogramas contiguos en entrenamiento y validación. Usa carpetas de carga o Move to split para los datos agrupados.
Síntoma: una exportación antigua o las predicciones de un modelo muestran de repente nombres de clase incorrectos. Solución: los ID de clase son posicionales, así que combinar o eliminar una clase desplaza hacia abajo todos los índices superiores. Crea una versión antes de cambiar ninguna clase y vuelve a entrenar en lugar de reutilizar archivos de etiquetas antiguos.
Síntoma: una nueva ejecución obtiene una puntuación 5 puntos más baja y no ha cambiado nada más. Solución: las métricas solo se pueden comparar con la misma división. Cuando cambies la división, indícalo en la descripción de la versión y vuelve a ejecutar la línea base con la nueva versión antes de comparar nada.
Mostrar solución
Solución de ejemplo para un conjunto de datos de carretillas elevadoras con 8 cámaras. La comprobación de duplicados encuentra 41 imágenes idénticas entre entrenamiento y validación, todas de una carpeta que se volvió a cargar; elimina las copias de validación. La auditoría, ampliada con group = record['file'].split('_')[0], muestra cam02 tanto en entrenamiento como en validación, así que selecciona sus imágenes de validación en la vista de tabla y Mover a partición > Entrenamiento. También señala pallet: train 63, val 7, too few in val: busca imágenes similares a partir de dos imágenes de palés para añadir 40 imágenes parecidas sin etiquetar, etiquétalas y mueve 15 imágenes de palés de cam07 a validación para mantener cam07 íntegra. Vuelve a ejecutar las comprobaciones: 0 duplicados, 0 grupos con filtraciones y 22 palés en validación. Clustering coloreado por partición no muestra islas mezcladas. Guarda v5: cam07 val, cam08 test, +40 pallets.