Implementa y llama a un endpoint
Crea un endpoint dedicado en una de las 42 regiones, dimensiona su capacidad según el tráfico y llámalo con un cliente que gestione los arranques en frío, los errores 429 y las claves incorrectas.
Un endpoint gratuito que escala a cero puede tardar hasta un minuto en responder a la primera solicitud, y un cliente ingenuo lo convierte en un tiempo de espera agotado que ve el usuario. Una clave filtrada sigue funcionando incluso después de eliminarla. En esta lección implementarás el modelo ganador, dimensionarás el endpoint deliberadamente y escribirás el pequeño cliente que necesita toda integración de producción.
Práctico
Inferencia compartida o endpoint dedicado#
Todos los modelos ya se pueden llamar mediante la API de inferencia compartida de Platform, adecuada para las pruebas. El tráfico de producción debe dirigirse a un endpoint dedicado:
| Inferencia compartida | Endpoint dedicado | |
|---|---|---|
| Servicio | Compartido entre usuarios de Platform | Un modelo, inquilino único |
| Regiones | Tu región de datos (US, EU o AP) | Cualquiera de las 42 regiones |
| Límite de solicitudes | 20 solicitudes por minuto y clave | Platform no limita las llamadas directas |
| Tamaño de solicitud | Unos 4,5 MB | 32 MB, hasta 1 hora por solicitud (compatible con vídeo) |
| Autenticación | Cualquier clave de API del espacio de trabajo | Solo la clave vinculada a la implementación |
Crear y dimensionar el endpoint#
Abre la pestaña Deploy del modelo. El navegador mide la latencia en las 42 regiones (14 en América, 13 en Europa, 12 en Asia-Pacífico y 3 en Oriente Medio y África) y ordena la tabla según esta:
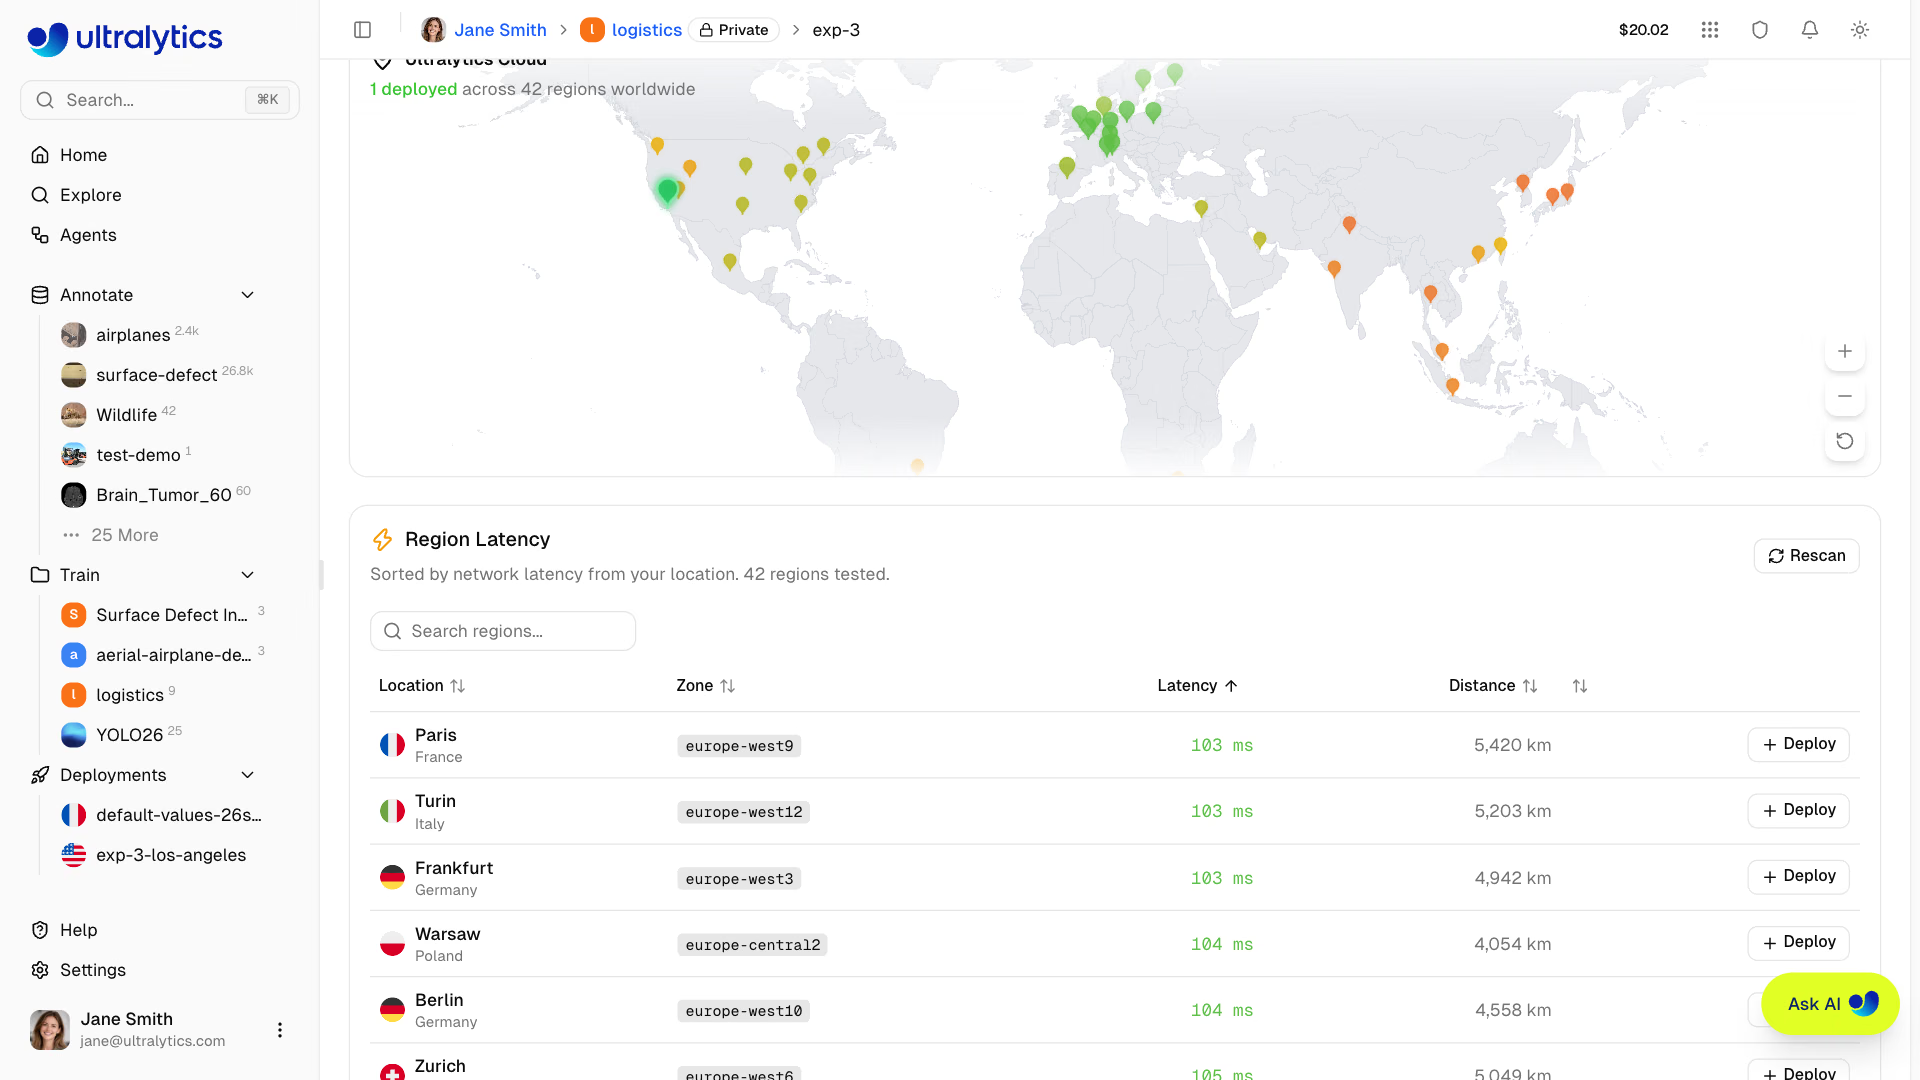
Haz clic en Deploy en la fila más cercana a tus usuarios, revisa la CPU, la memoria, el precio y el nombre generado (como yolo26n-iowa) y haz clic en Create Deployment. También puedes empezar desde New Deployment en la pestaña Deployments de tu perfil:
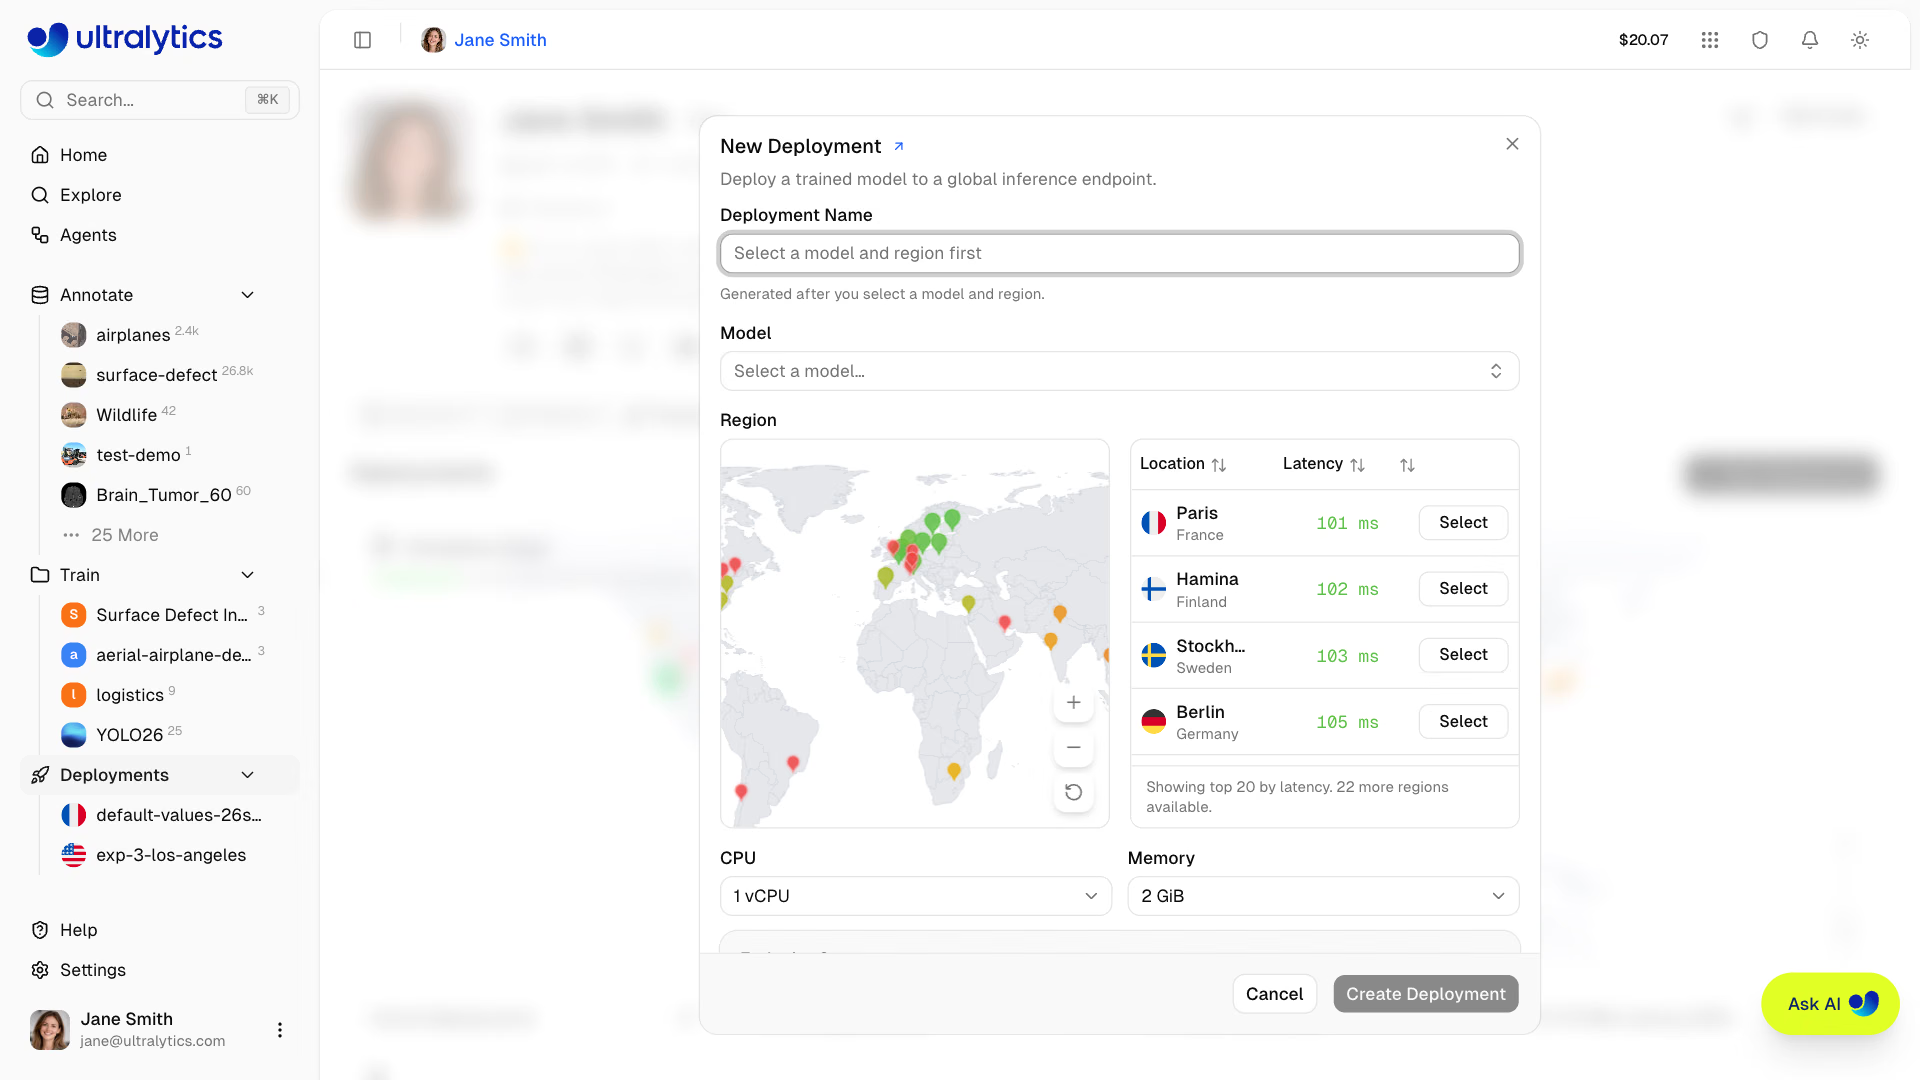
Dimensiona según el patrón de tráfico:
| Tráfico | Cantidad | Coste |
|---|---|---|
| Trabajos por lotes, herramientas internas, demostraciones con picos de tráfico | Tamaño predeterminado de 1 vCPU y 2 GiB; escala hasta cero | Gratis en todos los planes |
| Tráfico constante en tiempo real que no puede esperar a un arranque en frío | Tamaño personalizado (1–8 vCPU, 2–32 GiB) con una instancia activa | Se factura por hora desde que está lista hasta que se detiene, incluido el tiempo inactivo: unos 0,12 $/h para 1 vCPU y 4 GiB en Iowa |
| Usuarios en varios continentes | Un endpoint por región detrás de tu propio enrutador | Cada endpoint se factura según su tamaño |
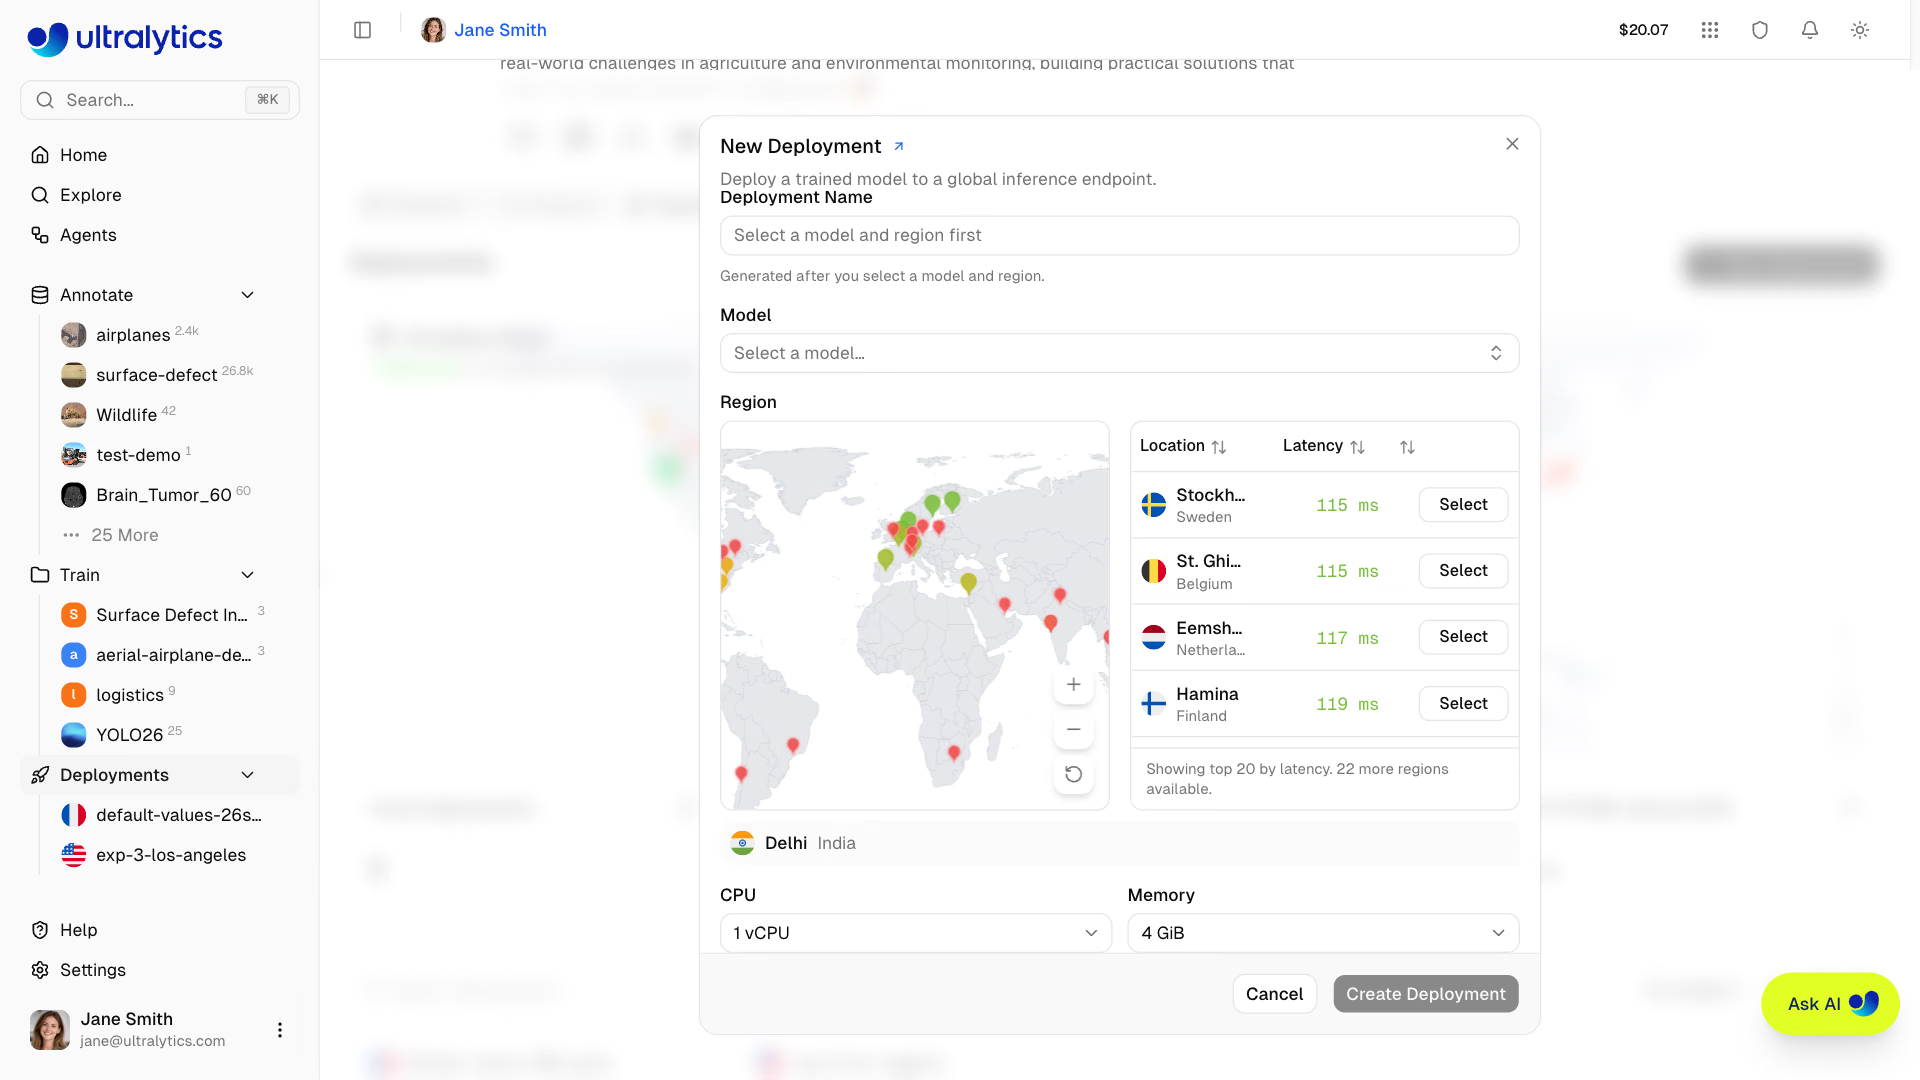
Los planes permiten 3 implementaciones (Free), 10 (Pro) o un número ilimitado (Enterprise), y los endpoints detenidos también cuentan. El endpoint acepta tráfico cuando su indicador muestra Ready:
Ejemplo práctico: un cliente preparado para producción#
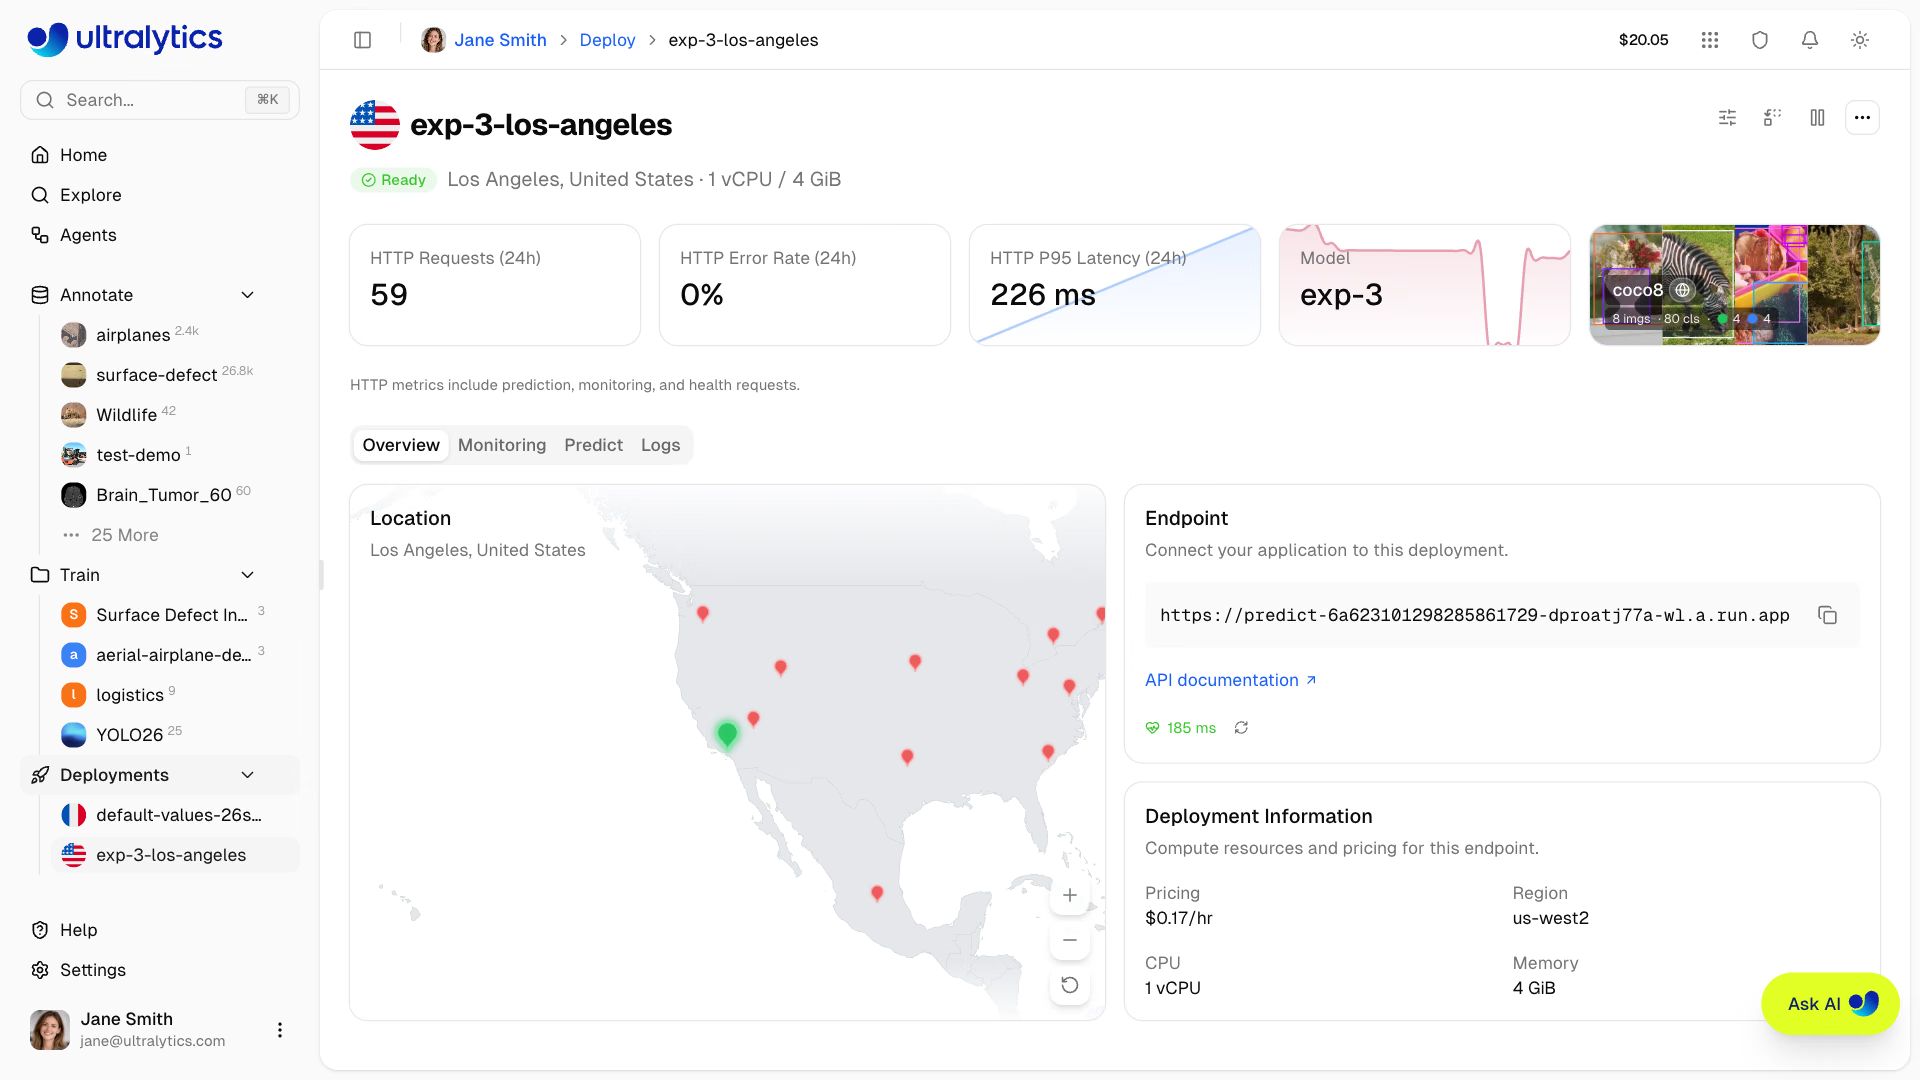
Cada endpoint tiene una URL como https://predict-<id>-<hash>-<region>.a.run.app que sirve /predict (POST), /health y una página interactiva /docs. Solo acepta la clave de API vinculada durante la creación; los propietarios del espacio de trabajo ven esa clave rellenada de antemano en la pestaña Predict de la implementación, en Docs, junto a fragmentos de código para Python, JavaScript y cURL. Los fragmentos de código realizan una solicitud; el código de producción también debe soportar un arranque en frío y una instancia ocupada:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Lo probamos con un stub local que responde a 429 una vez y, después, devuelve un resultado real de YOLO26n para bus.jpg en el formato de respuesta del endpoint:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
Estas son, línea por línea, las decisiones importantes:
timeout=90cubre un arranque en frío que puede tardar hasta aproximadamente un minuto; los tiempos de espera predeterminados de la mayoría de los clientes HTTP son mucho más cortos.- Se reintenta ante errores 429 y 5xx, respetando
Retry-Aftercuando el endpoint lo envía. Cada endpoint sirve desde una única instancia y rechaza carga con429cuando está ocupado. - Los demás errores 4xx fallan enseguida:
401significa que la clave no es correcta y413que el cuerpo supera los 32 MB; ninguno de los dos se soluciona por sí solo. - La respuesta contiene una entrada por imagen (o por fotograma de vídeo) en
images, cada una conresults(class,name,confidence,boxconx1,y1,x2,y2) yspeeden milisegundos.
Los campos opcionales del formulario son conf (0,25 de forma predeterminada), iou (0,7), imgsz (el tamaño de entrenamiento del modelo), vid_stride para vídeo y normalize=true para coordenadas de 0 a 1. El equivalente en cURL es una línea por campo:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Publicar nuevas versiones sin cambiar la URL#
Replace model en la página de implementación sustituye el modelo por otro modelo completado del mismo espacio de trabajo. El modelo anterior sigue sirviendo hasta que el nuevo está listo; la URL, la región y la clave no cambian. Si el despliegue falla, el modelo anterior sigue activo. Para volver a la versión anterior, basta con realizar la misma acción y seleccionar el modelo anterior, así que consérvalo en el proyecto. Update configuration cambia el tamaño de la instancia y Stop pausa la facturación y conserva la URL.
Algunos cambios requieren un endpoint nuevo: las regiones son fijas (para cambiar de región, debes eliminar y volver a crear el endpoint, lo que genera una URL nueva) y no se admiten dominios personalizados. Por tanto, coloca tu propia pasarela delante si los clientes necesitan un nombre de host de marca estable. Para ejecutar el modelo fuera de Platform, expórtalo (Export for Deployment) o alójalo por tu cuenta detrás de Triton Inference Server.
Errores habituales#
Síntoma: tu endpoint recibe tráfico que no puedes explicar. Solución: no pongas nunca la clave en una aplicación web o móvil; llama al endpoint desde tu backend. Eliminar o desactivar la clave asociada no bloquea el endpoint, porque sigue aceptando esa cadena de clave. Para revocar el acceso, detén o elimina el despliegue y crea uno nuevo asociado a una clave nueva.
Síntoma: la primera solicitud de la mañana falla y el reintento funciona. Solución: los endpoints de tamaño predeterminado escalan hasta cero. Usa un tiempo de espera de al menos 90 segundos, activa el endpoint con una llamada /health antes del tráfico previsto o cambia a un tamaño personalizado si todas las solicitudes deben ser rápidas.
Síntoma: las cargas fallan con 413. Solución: los endpoints dedicados aceptan cuerpos de solicitud de hasta 32 MB. Divide los vídeos largos en clips más cortos o envía fotogramas muestreados, y pasa vid_stride para omitir fotogramas en el servidor.
Mostrar solución
Ejemplo de respuesta para la cámara de la línea de fabricación de pastillas: implementa v2-finetune en europe-west1 (St. Ghislain, la región con menor latencia desde la planta alemana) con el tamaño predeterminado. Solicitud en frío tras una hora de inactividad: 38 s, dentro del límite de 90 segundos; solicitud en caliente: 0,3 s. Decisión: el PLC de la línea envía un fotograma cada 30 segundos durante los turnos, por lo que el endpoint permanece activo todo el turno y solo el primer fotograma sufre un arranque en frío. Una llamada a /health desde el controlador de la línea 2 minutos antes de cada turno también elimina ese tiempo, así que se mantiene el tamaño predeterminado gratuito y se ahorran unos 90 $ al mes frente a una instancia personalizada de 1 vCPU y 4 GiB. Al volver a sustituir el modelo por v1-baseline, se obtienen los resultados de v1 en la misma URL; vuelve a sustituirlo por v2 para terminar.