Supervisar el estado y la precisión
Consulta las métricas del endpoint y las estadísticas de predicción de Platform, configura alertas mediante una comprobación de estado programada y detecta desviaciones en la precisión con un trabajo de evaluación sobre un conjunto de prueba.
Un endpoint puede devolver 200 OK en todas las solicitudes mientras su precisión cae 5 puntos porque el turno de noche ha bajado la intensidad de las luces. Platform muestra el comportamiento de cada endpoint, pero no avisa a nadie y no puede medir la precisión sin etiquetas. En esta lección crearás las dos comprobaciones programadas que cubren esta carencia y ensayarás la alerta de precisión con un turno de noche simulado.
Práctico
Qué muestra Platform#

| Señal | Dónde | Durante cuánto tiempo |
|---|---|---|
| Solicitudes HTTP, tasa de errores (4xx y 5xx), latencia P95 | Tarjetas en la página de implementación y en la pestaña Deployments, actualizadas cada minuto | Las tarjetas abarcan 24 horas; la API ofrece datos de 1 hora a 30 días |
| Estado | Tarjeta Endpoint en la pestaña Overview | En tiempo real; se vuelve a comprobar automáticamente mientras el estado no sea saludable |
| Registros | Pestaña Logs: los 20 más recientes, con el filtro Errors | La API devuelve hasta 200 entradas por solicitud, con paginación |
| Estadísticas de predicción y ejemplos temporales (hasta 100 imágenes) | Pestaña Monitoring | Solo en la memoria de la instancia de servicio |
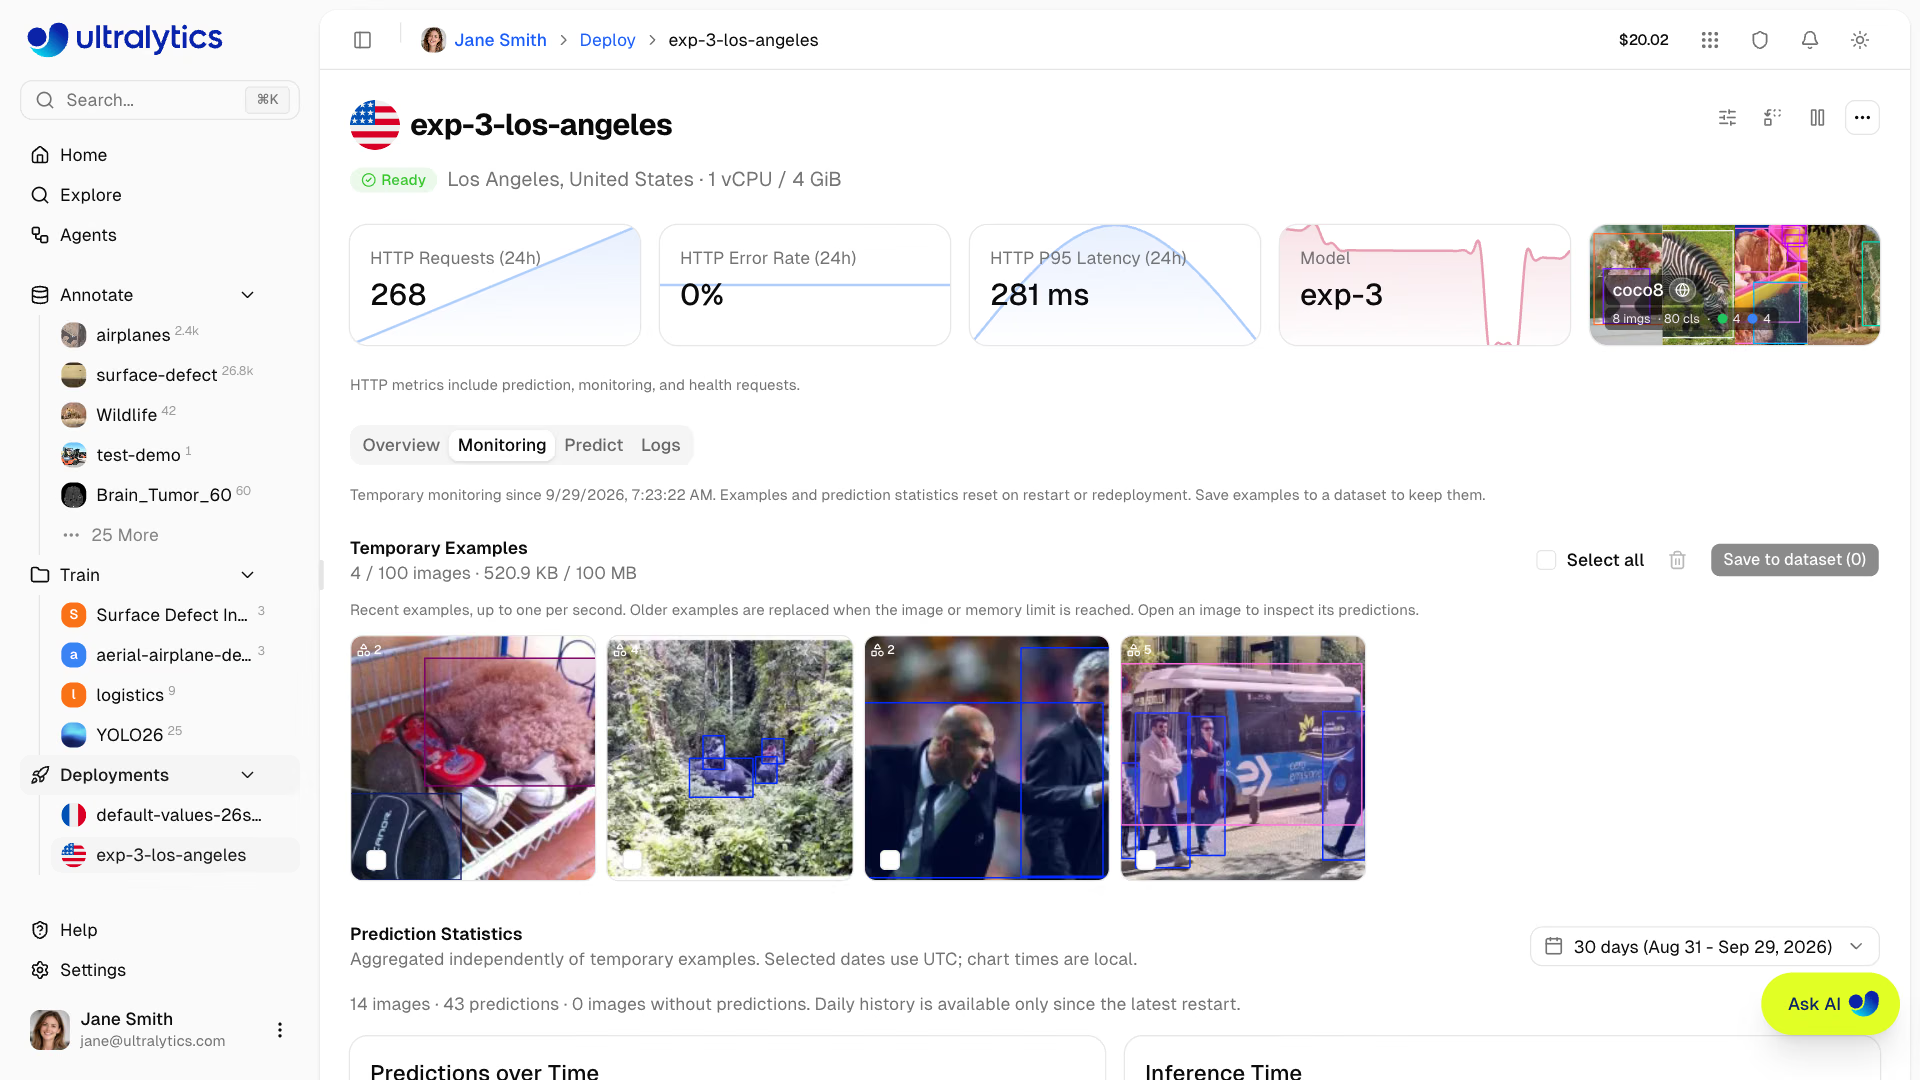
Dos salvedades condicionan todo lo demás. Solo se recopilan métricas mientras el endpoint está Ready, y al eliminar una implementación se pierde el acceso a su historial. Las estadísticas y los ejemplos de la pestaña Monitoring se pierden cada vez que se detiene o reinicia el endpoint, se cambia su tamaño o se sustituye su modelo: es una vista en directo, no un archivo.
Ejemplo práctico: una comprobación programada del endpoint#
Platform pone en rojo la tarjeta de tasa de errores cuando supera el 5 % y Slack puede avisar cuando una implementación está lista o no se inicia, pero no hay alertas por umbral. Ejecuta esta comprobación cada 5 minutos desde cron, CI o tu agente de supervisión, y envía una alerta si devuelve un código distinto de cero:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
Al ejecutarlo con una API simulada que devuelve un endpoint saludable, muestra una línea y devuelve el código 0; con P95_BUDGET_MS = 100, los mismos datos devuelven el código 1:
healthy=True requests=1200 p95=180 ms errors=0.40%healthcomprueba el endpoint y devuelvehealthy,statusylatencyMs. También activa un endpoint cuya escala había llegado a cero, así que una programación cada 5 minutos sirve además como señal para mantenerlo activo.metrics(..., view="overview")devuelvetotalRequests,errorRate(un porcentaje) yp95LatencyMspara el intervalo.logsobtiene los errores y advertencias más recientes, de modo que la alerta incluye una primera pista.
Instala el SDK con pip install -U ultralytics-platform (el SDK requiere Python 3.11 o posterior). Envía alertas solo si los umbrales se superan de forma sostenida; por ejemplo, tras tres comprobaciones fallidas seguidas. Añade a cada alerta una entrada de una línea en el manual de operaciones.
Ejemplo práctico: hacer seguimiento de la precisión con un conjunto de prueba#
Las métricas de solicitudes no pueden medir la precisión; un conjunto de prueba sí: entre 200 y 500 imágenes representativas de producción, etiquetadas con cuidado, en una versión privada propia de un conjunto de datos y nunca utilizadas para entrenar. Evalúa semanalmente el checkpoint implementado y añade los resultados a un archivo de historial:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
La primera ejecución registra la referencia del día de la implementación. Después, ensaya la alerta antes de necesitarla: este script crea una copia del conjunto de prueba para el «turno de noche», con las mismas etiquetas e imágenes al 15 % de brillo:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbookTodas las solicitudes durante el turno de noche seguirían devolviendo 200 en milisegundos, pero el modelo habría perdido 5 puntos de mAP. Solo el conjunto de prueba permite detectarlo. Actualiza el conjunto cada trimestre con imágenes de producción recién etiquetadas y restablece la referencia cada vez que implementes un modelo nuevo. La guía de supervisión de modelos y la lección Observabilidad y desviaciones explican las pruebas estadísticas de desviación.
Consulta la pestaña Monitoring para detectar desviaciones#
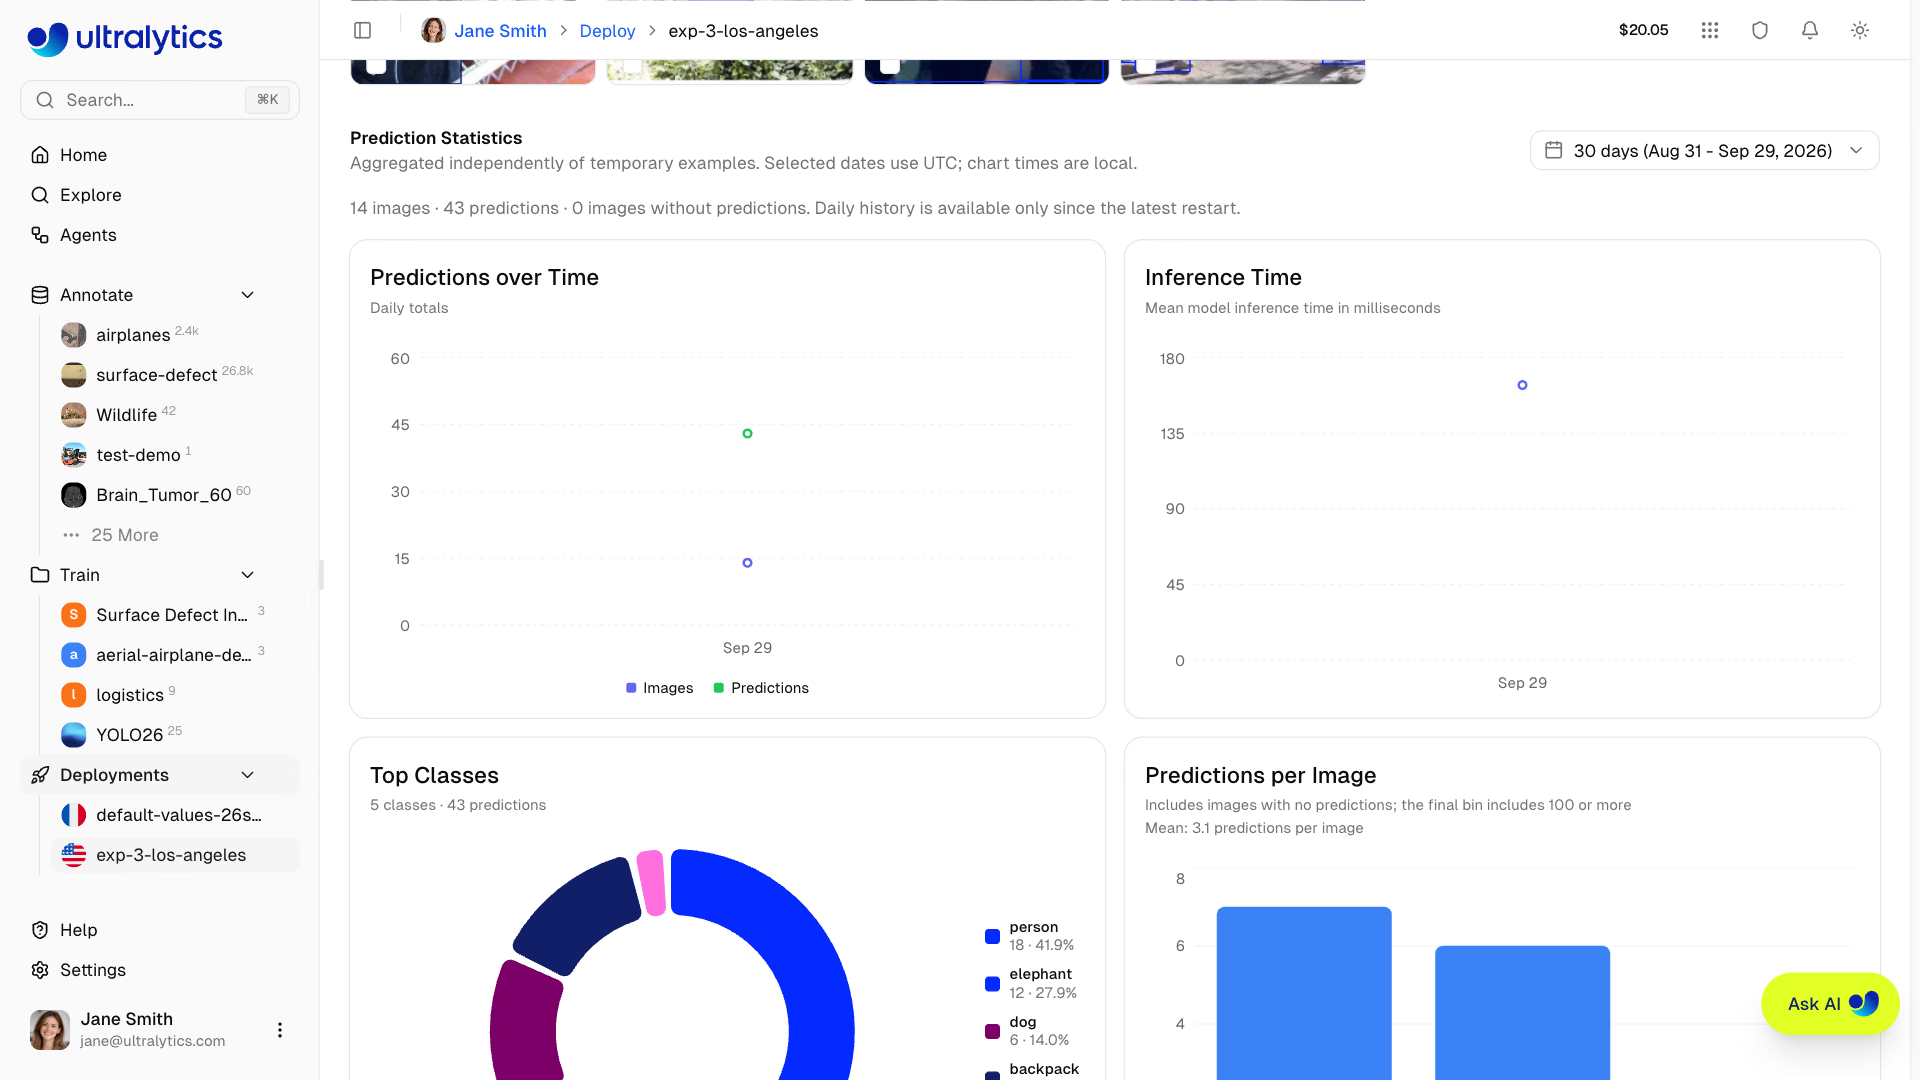
Anota la forma de los gráficos durante la semana en que implementes el modelo y compárala más adelante. La confianza mide la certeza, no la corrección, así que interpreta estos datos junto con los del conjunto de prueba:
| Situación | Causa probable | Acción |
|---|---|---|
| La confianza cae, pero el resultado del conjunto de prueba se mantiene | Cambio de dominio benigno | Vigila la situación; guarda ejemplos para la siguiente versión del conjunto de datos |
| Caen tanto la confianza como el resultado del conjunto de prueba | Regresión real de la precisión | Vuelve a entrenar (lección 10) |
| Los tamaños o las ubicaciones de las cajas cambian de repente | Se ha movido la cámara o ha cambiado el objetivo o la ubicación | Comprueba la cámara antes de tocar el modelo |
| Caen las predicciones por imagen, pero la confianza se mantiene | La cámara está desconectada, la escena tiene menos actividad o hay un error en el cliente | Investiga los sistemas anteriores |
| Aumenta la latencia P95, pero el tiempo de inferencia no cambia | Gestión de solicitudes, tamaño de la carga o capacidad | Es la infraestructura, no el modelo |
Incorpora las imágenes de producción al flujo de trabajo#
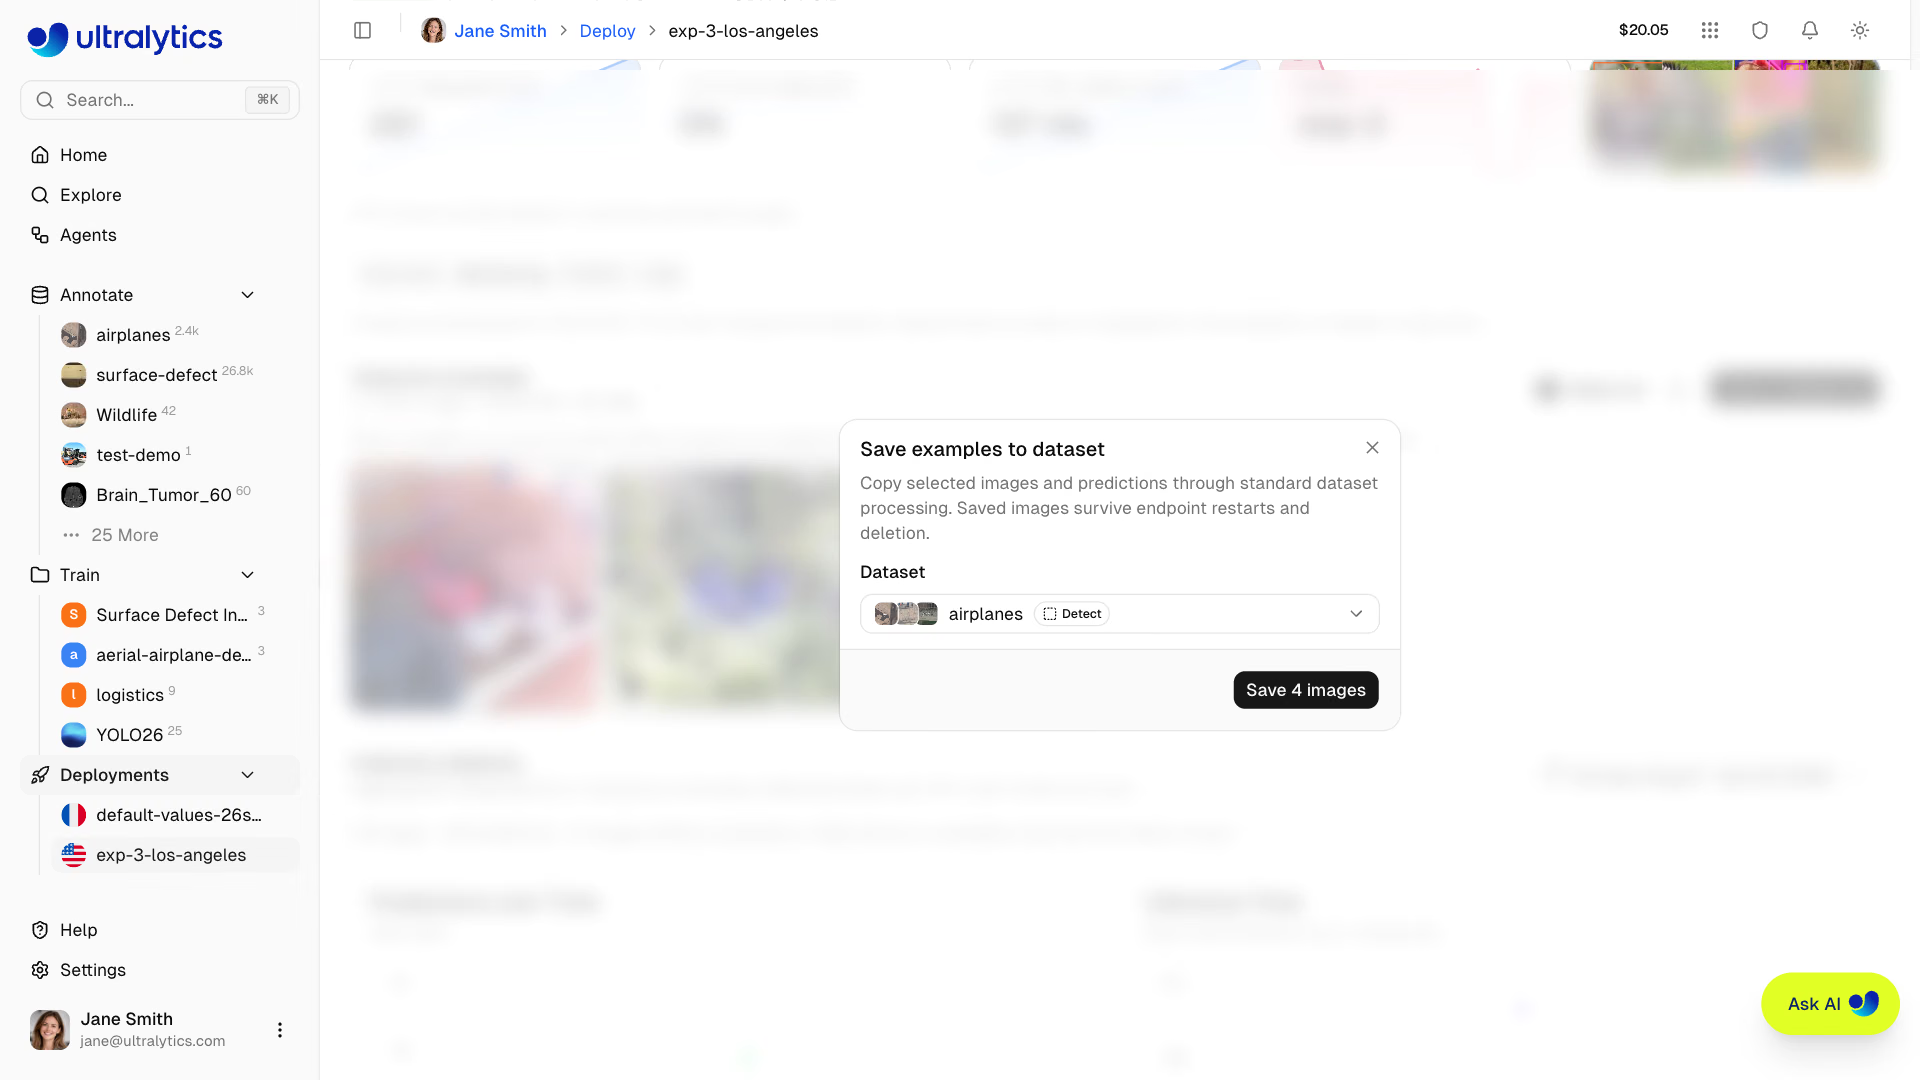
En la pestaña Monitoring, selecciona ejemplos y haz clic en Save to dataset; se incorporan mediante el proceso de ingesta habitual, junto con sus predicciones, y conservan deploymentId y la región en sus metadatos. La plantilla Collect Uncertain Detections de Agents hace lo mismo con todo un conjunto de datos: predice mediante tu implementación y copia las imágenes con detecciones dentro de un intervalo de confianza a un conjunto de revisión.
Errores habituales#
Síntoma: los ejemplos que querías etiquetar desaparecen tras cambiar el tamaño o el modelo. Solución: se guardan en la memoria de la instancia de servicio. Guárdalos en un conjunto de datos y espera a que termine la ingesta antes de detener, cambiar el tamaño o sustituir el modelo.
Síntoma: la alerta del conjunto de reserva se activa justo después de publicar un modelo mejor o no vuelve a activarse. Solución: la línea base es la primera fila del historial. Inicia un nuevo holdout_history.jsonl (o registra una nueva fila de línea base) cada vez que sustituyas el modelo.
Síntoma: la tasa de errores se dispara durante un pico de tráfico mientras el estado sigue en verde. Solución: las respuestas 429 cuentan como errores, pero significan «capacidad agotada». Consulta los registros; si son errores 429, distribuye el tráfico entre más endpoints o usa un tamaño personalizado mayor.
Mostrar solución
Respuesta resuelta para el punto de conexión de píldoras: una entrada de cron */5 * * * * python endpoint_check.py || ./page-oncall.sh con P95_BUDGET_MS = 300 y MAX_ERROR_RATE = 1.0; al establecer el presupuesto en 100 ms frente a un P95 real de 180 ms, termina con el código 1 y envía una alerta, por lo que la configuración funciona. El trabajo semanal de CI ejecuta holdout_check.py con DEPLOYED = "pills-v2.pt" en la versión privada del conjunto de retención de 300 imágenes: línea base 0.69. El ensayo del turno de noche provoca una caída de 0.05 e imprime la línea ALERT con el código de salida 1, lo que hace fallar el trabajo de CI y notifica al canal. Doce ejemplos de Supervisión del turno de tarde se guardan en pill-review mediante Guardar en conjunto de datos, cada uno etiquetado con deploymentId y europe-west1.