Observabilidad y deriva
Registra las métricas que detectan pérdidas silenciosas de precisión, comprueba si hay deriva en las distribuciones de confianza y genera alertas solo ante señales que requieran una acción.
Un servicio de visión puede estar activo, ser rápido y equivocarse. Una cámara se mueve, cambia la iluminación, llega una nueva línea de productos y el modelo sigue devolviendo cajas mientras todos los paneles de infraestructura permanecen en verde. En esta lección, al oscurecer un clip para simular el anochecer, la confianza media solo cambió 0,01 —algo imperceptible en un gráfico—, pero una prueba KS de dos muestras lo detectó con p = 0,007. Crearás esa comprobación y el registro que la alimenta.
Práctico
Tres capas de señales#
| Capa | Pregunta | Señales |
|---|---|---|
| Infraestructura | ¿El servicio está activo y mantiene el ritmo? | Latencia, rendimiento, fotogramas perdidos, uso de CPU y GPU |
| Comportamiento del modelo | ¿Se comporta el modelo como la semana pasada? | Detecciones por fotograma, confianza media, distribución de clases y tamaños de las cajas |
| Precisión del modelo | ¿Sigue acertando el modelo? | mAP del conjunto reservado (métricas de rendimiento), revisión humana de muestras y tasa de falsas alarmas |
La mayoría de los equipos cubre la primera capa con herramientas estándar y se detiene ahí. Los fallos silenciosos de los sistemas de visión se producen en la segunda y la tercera; la guía de supervisión de modelos explica todo el ciclo de mantenimiento.
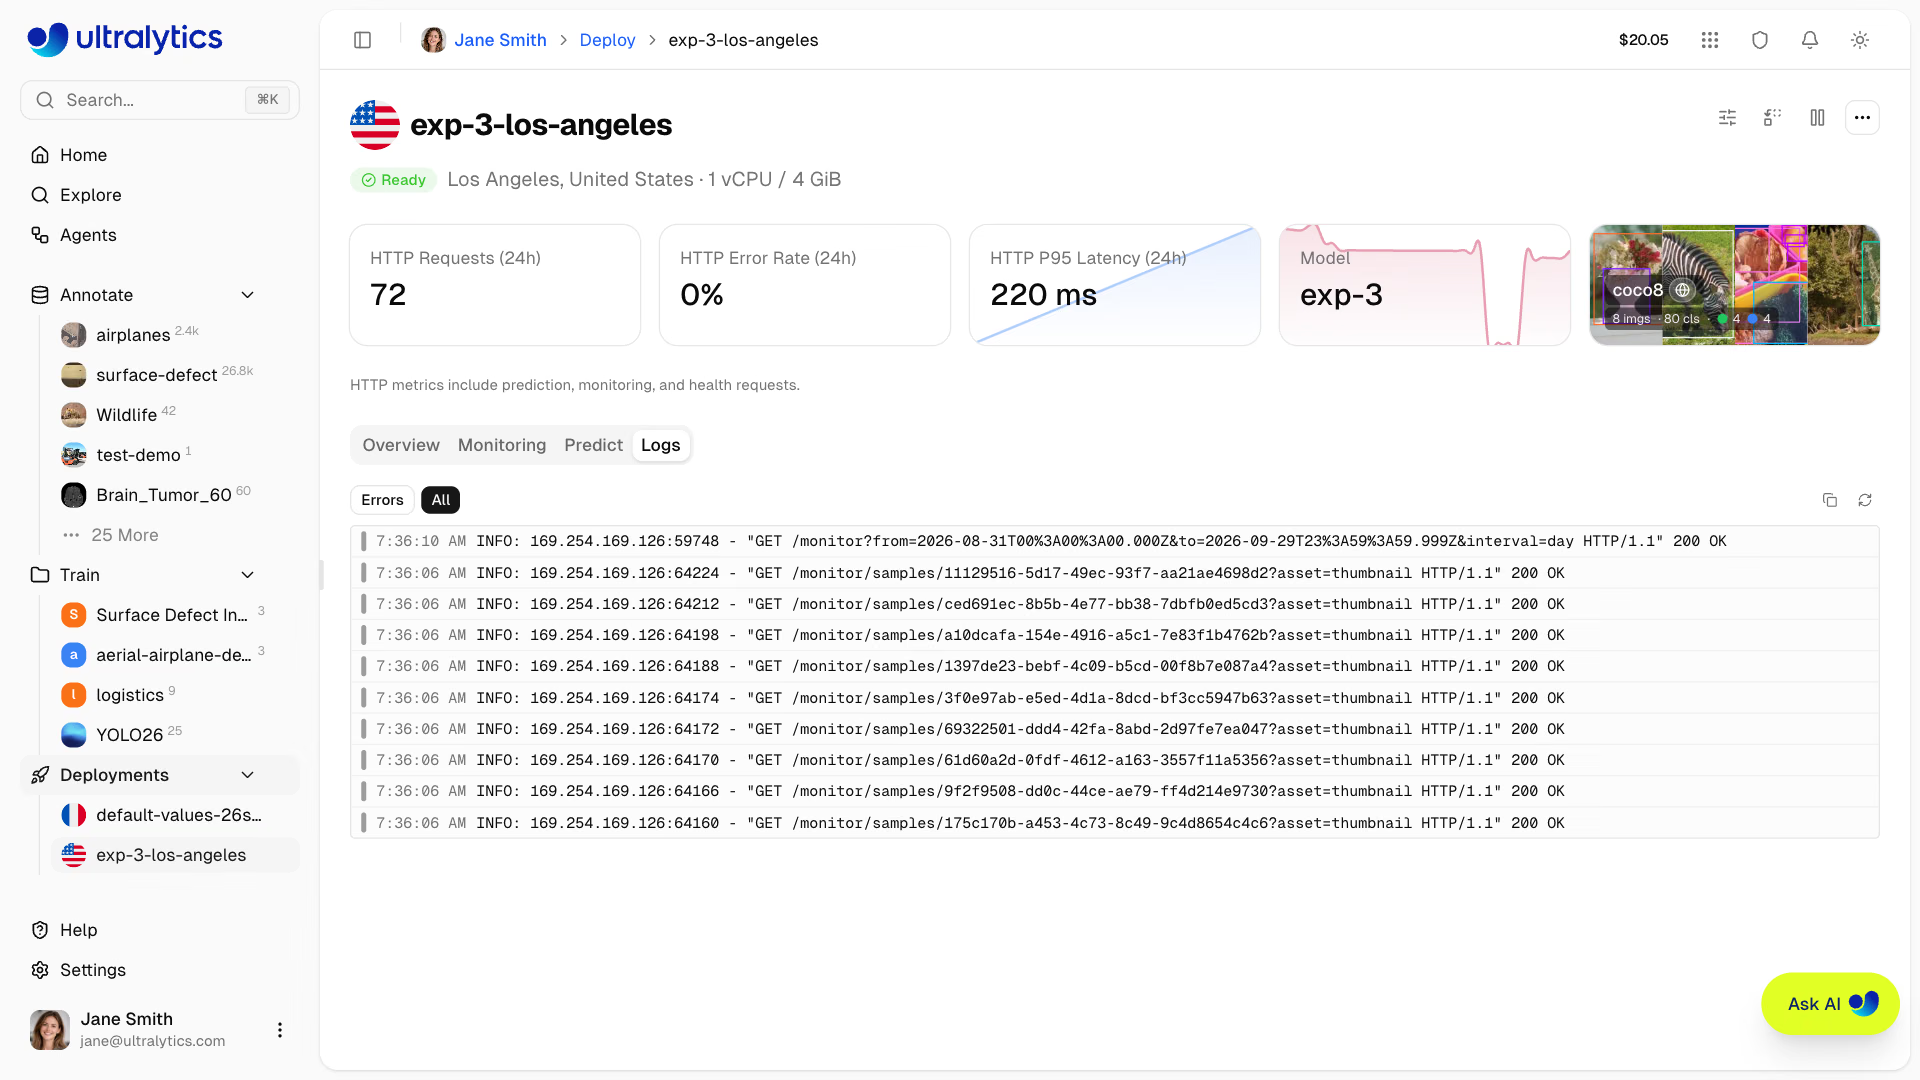
Si implementas mediante Ultralytics Platform, la página de implementación te ofrece la capa de infraestructura (solicitudes, tasa de errores y latencia P95) y registros de solicitudes que puedes filtrar por errores, como se muestra arriba; la lección Supervisar el estado y la precisión los explica. Tú debes crear las capas de comportamiento y precisión; el resto de esta lección te enseña a hacerlo.
Emite métricas por fotograma#
Cada objeto Results incluye tiempos y cajas. Escribe una línea JSON por fotograma y envíala al sistema de métricas que utilices:
import json
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
with open("metrics.jsonl", "w") as log:
    for r in model.predict(video, stream=True, verbose=False):
        conf = r.boxes.conf
        record = {
            "ts": time.time(),
            "camera": "lobby-1",
            "inference_ms": round(r.speed["inference"], 1),
            "detections": len(r.boxes),
            "mean_conf": round(conf.mean().item(), 3) if len(conf) else None,
            "confs": [round(c, 3) for c in conf.tolist()],  # valores sin procesar para la prueba de deriva
        }
        log.write(json.dumps(record) + "\n")
print({k: v for k, v in record.items() if k != "confs"})
{'ts': 1792003254.33, 'camera': 'lobby-1', 'inference_ms': 34.7, 'detections': 22, 'mean_conf': 0.543}Para qué sirve cada campo:
- inference_ms: alerta cuando p95 supere tu presupuesto.
- detections: una caída repentina hasta casi cero suele indicar que una cámara está bloqueada o averiada; un aumento repentino indica un cambio de escena o falsos positivos.
- mean_conf: una línea de tendencia rápida, pero demasiado general para detectar una deriva por sí sola.
- confs: la distribución completa que necesita la prueba de deriva de abajo.
Probar si hay deriva en las distribuciones de confianza#
La deriva de datos se refleja en las confianzas mucho antes de que alguien etiquete datos nuevos. Recopila las confianzas al iniciar para establecer una referencia, recopila una ventana reciente y compara las dos distribuciones con una prueba de Kolmogórov-Smirnov para dos muestras (pip install scipy). Este script simula el anochecer oscureciendo el mismo vídeo:
import cv2
import numpy as np
from scipy.stats import ks_2samp

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

model = YOLO("yolo26n.pt")
video = str(safe_download("https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"))

def confidences(darken=1.0):
    """Collect every detection confidence from the clip, optionally darkened to simulate dusk."""
    cap, out = cv2.VideoCapture(video), []
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        out += model((frame * darken).astype(np.uint8), verbose=False)[0].boxes.conf.tolist()
    return np.array(out)

baseline = confidences()  # what "normal" looked like at launch
for name, recent in (("same scene", confidences()), ("dusk (35% brightness)", confidences(darken=0.35))):
    stat, p = ks_2samp(baseline, recent)
    print(f"{name:22s} n={len(recent):4d} mean_conf={recent.mean():.3f} KS={stat:.3f} p={p:.2g}")
same scene n=1376 mean_conf=0.519 KS=0.000 p=1
dusk (35% brightness) n=1337 mean_conf=0.508 KS=0.064 p=0.0068Léelo línea por línea:
- Misma escena: las distribuciones idénticas dan un estadístico KS de 0 y p = 1; este es el control.
- Anochecer: 39 detecciones menos y una media solo 0,011 inferior, algo que nadie advertiría en un gráfico. El estadístico KS (la mayor diferencia entre las dos distribuciones acumuladas) es 0,064, y p = 0,0068 < 0,01 indica que el desplazamiento es real.
Una alerta de deriva es un motivo para revisar fotogramas de muestra, no una prueba de fallo. Si la deriva es real, recopila y etiqueta fotogramas de las cámaras afectadas: la guía de recopilación y anotación de datos explica qué recopilar y la guía de ajuste fino explica cómo volver a entrenar. El tamaño de las cajas (ancho × alto) ofrece una segunda señal de deriva sencilla: los nuevos soportes y las nuevas ópticas se reflejan primero ahí.
Valida una partición de prueba cada semana#
Las señales de comportamiento indican que algo ha cambiado; solo las etiquetas indican si la precisión ha bajado. Conserva una partición de prueba con entre 200 y 500 imágenes de producción etiquetadas y valida cada versión del modelo, además de hacerlo cada semana:
yolo val model=yolo26n.pt data=coco8.yaml > weekly_metrics.txt # use your production model and holdout YAMLRegistra mAP50-95 y AP por clase a lo largo del tiempo, y activa una alerta cuando mAP baje más de 1 punto de una semana a otra. La causa más habitual es un cambio de modelo que debía ser inocuo; la segunda es la deriva. Una matriz de confusión sobre la misma partición de prueba permite detectar fácilmente las regresiones por clase.
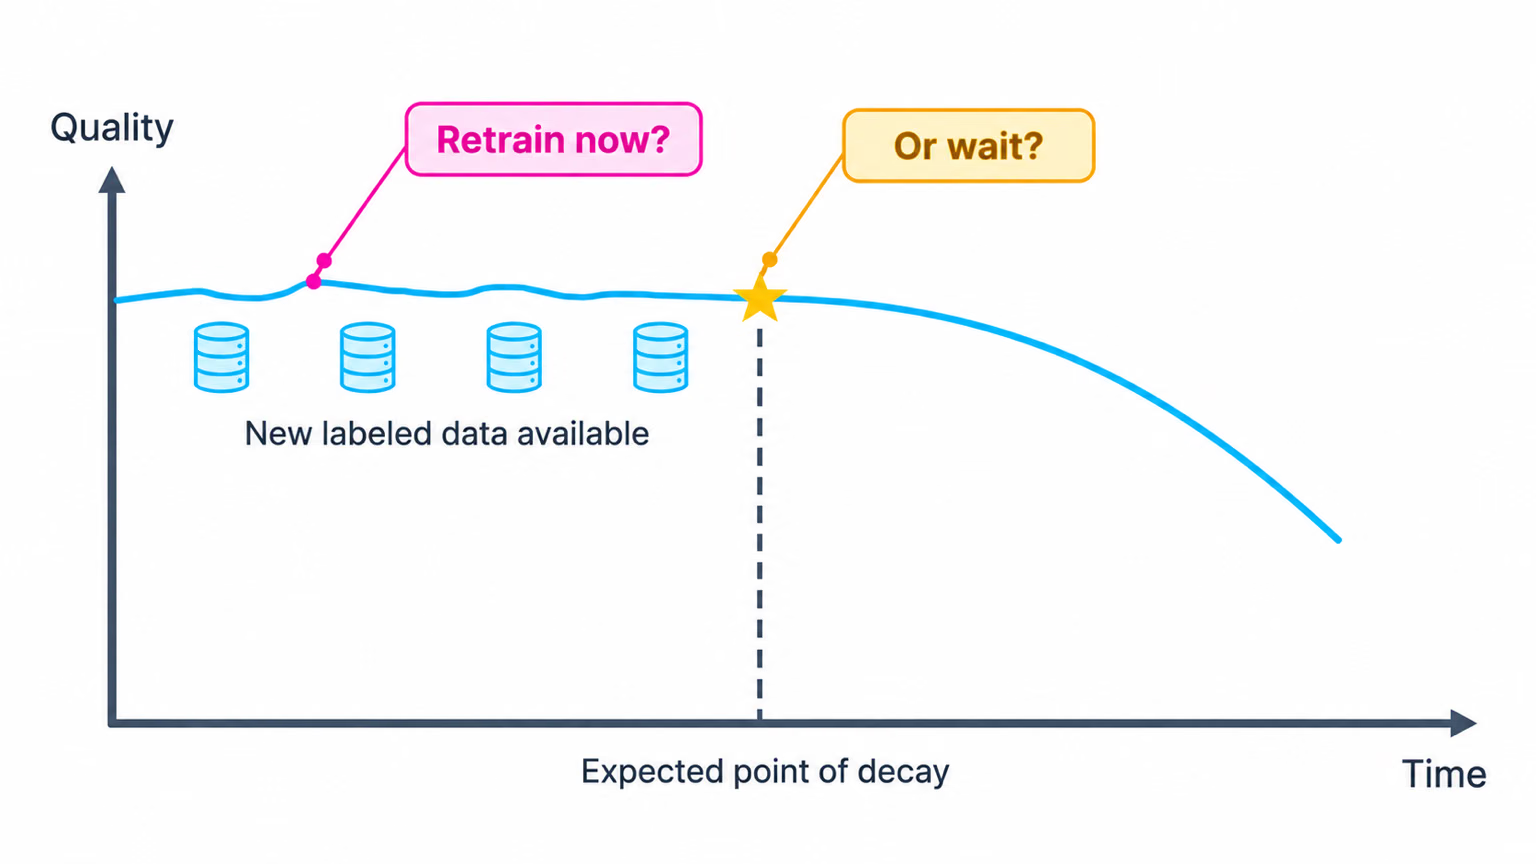
La partición de prueba es lo que responde a la pregunta de este gráfico. Vuelve a entrenar cuando muestre que la calidad empieza a caer o cuando tengas suficientes datos etiquetados nuevos de las condiciones con deriva; no lo hagas siguiendo un calendario fijo.
Activa alertas ante acciones, no ante números#
| Señal | Activar cuando | Acción |
|---|---|---|
p95 inference_ms | Supere el presupuesto durante más de 3 minutos | Escala horizontalmente o cambia a la exportación optimizada |
| Detecciones por fotograma | Bajen un 50 % o más durante 5 minutos | Comprueba la señal de la cámara y, después, la versión del modelo |
| Fotogramas perdidos | Superen el 5 % durante 10 minutos | Añade capacidad o reduce los FPS por flujo |
| Prueba KS de confianza | p < 0,01 en ventanas diarias | Revisa los fotogramas y, después, ejecuta la validación de la partición de prueba |
| mAP50-95 de la partición de prueba | Baje 1 punto o más de una semana a otra | Recopila datos, etiquétalos y ajusta el modelo |
Errores habituales#
Síntoma: la prueba KS se activa todas las tardes y todos los lunes. Solución: los ciclos diarios y semanales son cambios reales en la distribución. Compara situaciones equivalentes (las mismas cámaras, las mismas horas y el mismo día de la semana) y usa ventanas de miles de detecciones.
Síntoma: el mAP del conjunto de prueba parece correcto, pero los usuarios informan de fallos de detección. Solución: el conjunto de prueba debe parecerse a la producción actual. Actualízalo cada trimestre con fotogramas recién etiquetados de las cámaras relevantes.
Cada alerta necesita una siguiente acción por escrito. Si solo quieres observar una señal, debe aparecer en un panel, no activar una alerta.
Mostrar solución
Conserva la primera ventana saludable de resultados de monitor.py como baseline.jsonl y, después, compara cada ventana nueva con ella:
import json

import numpy as np
from scipy.stats import ks_2samp

def load(path):
    """Flatten the per-frame 'confs' lists written by monitor.py."""
    with open(path) as f:
        return np.array([c for line in f for c in json.loads(line)["confs"]])

baseline, recent = load("baseline.jsonl"), load("metrics.jsonl")
stat, p = ks_2samp(baseline, recent)
print(f"KS={stat:.3f} p={p:.2g} -> {'review frames' if p < 0.01 else 'ok'}")
KS=0.000 p=1 -> okEse es el resultado esperado cuando ambos archivos proceden del mismo metraje. Ejecútalo cada día con un programador, envía el estadístico y el valor p al mismo sistema de métricas que los registros por fotograma y dirige review frames a una persona, no a un buscapersonas.