Optimizar con TensorRT
Crea un motor TensorRT FP16, decide si INT8 compensa el coste en precisión y valida el motor antes de publicarlo.
En una GPU NVIDIA, un motor TensorRT FP16 suele ser la mejora de velocidad más económica que conseguirás: es aproximadamente 1,5× más rápido en la prueba de rendimiento de Ultralytics en A100, sin cambios en mAP. INT8 va más allá, pero la cuantización INT8 posterior al entrenamiento restó entre 4 y 6 puntos de mAP a YOLO26s–YOLO26m en COCO. En esta lección aprenderás a saber qué paso estás dando y a medirlo antes de que lo hagan tus usuarios.
Práctico
El código de esta lección requiere una GPU NVIDIA con TensorRT instalado. Todos los argumentos que se muestran están disponibles para format=engine en la documentación del modo de exportación.
FP16 es el primer paso seguro#
Las GPU NVIDIA a partir de Volta cuentan con núcleos tensoriales FP16, y los modelos de detección rara vez necesitan FP32 durante la inferencia. Empieza aquí:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # Motor FP16, hasta 4 GiB de espacio de trabajo para el compilador
workspace limita la memoria de la GPU que TensorRT puede usar durante la compilación; déjalo sin establecer para que TensorRT decida. La página de integración de TensorRT publica este resultado en A100 (YOLOv8n, 640 px):
| Precisión | Predicción, lote de 8 (ms) | mAP50-95 de validación en COCO |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
El modelo es anterior a YOLO26, pero la relación entre coste y beneficio se mantiene: FP16 fue aproximadamente 1,5× más rápido sin coste; INT8 aportó otro 1,2× y costó 4 puntos. Si FP16 cumple tu presupuesto, publícalo.
¿No tienes una GPU NVIDIA local? La pestaña Export de Ultralytics Platform compila el motor en la GPU en la nube que elijas, con las mismas opciones de tamaño de imagen, precisión, lote, modo dinámico, NMS y espacio de trabajo:

Elige la familia de GPU en la que vayas a desplegar: el motor de la captura se compiló en una RTX 5090 y solo se ejecutará en esa familia.
INT8 necesita datos de calibración#
La cuantización INT8 asigna las activaciones de cada capa a 256 niveles. Para elegir esos rangos, el exportador ejecuta imágenes de calibración a través del modelo y registra las activaciones que encuentra, así que las imágenes deben parecerse a las de producción:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # las imágenes de calibración proceden de la partición val de este conjunto de datos; usa my_dataset/data.yaml
    fraction=1.0,  # proporción (o número) de esas imágenes que se usarán
    batch=8,  # los lotes de calibración más grandes proporcionan rangos más estables
    dynamic=True,  # con batch=8, el motor acepta lotes de 1 a 8
    workspace=4,
)
El coste de INT8 depende del modelo. La documentación del modo Export midió motores TensorRT de YOLO26 en COCO val (mAP50-95):
| Modelo | Motor FP32 | INT8, calibrado (PTQ) | INT8 tras entrenamiento consciente de la cuantización (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
La calibración por sí sola resta 1 punto a YOLO26n y entre 4 y 6 a los modelos más grandes. QAT ajusta el modelo con quantize=8 en train para que sus pesos toleren INT8; el punto de control incluye sus propios rangos, la exportación INT8 no necesita datos de calibración y queda a menos de 1–2 puntos de FP32. La decisión:
Valida el motor antes de publicarlo#
Todos los motores deben superar las mismas comprobaciones en la GPU de despliegue:
| Comprobación | Criterio |
|---|---|
| mAP50-95 en tu conjunto de validación | A menos de 0,5 puntos de FP32 para FP16; tu presupuesto documentado para INT8 |
| AP por clase | Ninguna clase pierde más de 1 punto aproximadamente (las clases pequeñas suelen variar más) |
| Latencia p95 | Por debajo del presupuesto con el tamaño de lote de producción |
| Umbral operativo | conf vuelve a seleccionarse a partir de la propia curva F1 del motor |
| Determinismo | La misma imagen produce exactamente las mismas cajas dos veces |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
De dónde viene la aceleración#
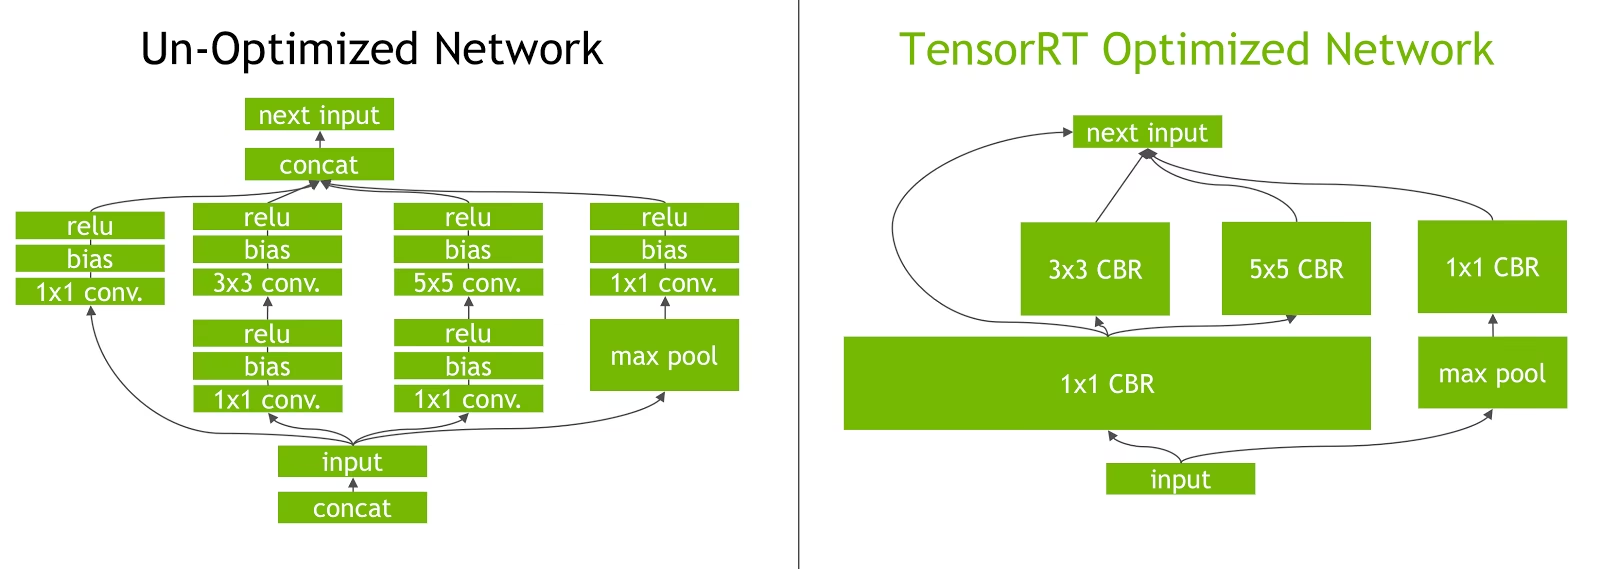
TensorRT fusiona cada convolución, sesgo y ReLU en un único kernel (los bloques «CBR» de la derecha) y elimina los pasos de concatenación, por lo que la GPU ejecuta muchos menos kernels y mueve menos datos. En YOLO26, esto resulta útil en todas las cadenas conv-BN-activación de la red, en el bloque de atención (PSA) del backbone y en las numerosas operaciones pequeñas del cabezal de detección. Si un motor sigue siendo lento, perfílalo con trtexec o NVIDIA Nsight: a menudo una capa representa el 30 % o más del tiempo.
Errores habituales#
Síntoma: INT8 pierde 1 punto en COCO y 6 en tus cámaras. Solución: calibra con una parte reservada de tu conjunto de validación; NVIDIA recomienda al menos 500 imágenes representativas. La calibración también varía según el dispositivo, así que calibra en la GPU de destino.
Síntoma: el recall cae al cambiar a INT8 con el mismo valor de conf. Solución: INT8 puede desplazar los valores de confianza; vuelve a elegir conf a partir de la curva F1 del propio motor INT8.
Síntoma: el motor no se deserializa o funciona más despacio de lo esperado en el equipo de despliegue. Solución: compílalo en una GPU de la misma familia que la GPU de despliegue, con versiones compatibles de TensorRT y del entorno de ejecución de CUDA, y distribuye .onnx para que los dispositivos puedan volver a compilarlo. Si la calibración falla durante la compilación, aumenta workspace o reduce imgsz o batch.
En Jetson, DeepStream ejecuta los motores resultantes en una canalización de vídeo acelerada por hardware; en el centro de datos, los sirve Triton Inference Server.
Mostrar solución
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
Un informe satisfactorio indica: diferencia inferior a 0,5 puntos, p95 por debajo del presupuesto, decisión publicar FP16. Si p95 no cumple, exporta INT8 con tu propio YAML de calibración, vuelve a ejecutar las mismas dos líneas y publica INT8 solo si la diferencia se mantiene dentro del presupuesto que anotaste antes de empezar; de lo contrario, prueba QAT o un modelo más pequeño.