Inferencia con varios flujos
Ejecuta varias cámaras con un mismo modelo mediante inferencia por lotes, colas con límites y mediciones de los fotogramas perdidos.
Un sistema que puede seguir el ritmo de una cámara puede acumular minutos de retraso con cuatro, sin que se produzca ningún fallo: los resultados simplemente llegan cada vez más tarde hasta que se agota la memoria. En la CPU del portátil utilizada aquí, un flujo de 30 FPS mantuvo el ritmo; cuatro perdieron la mitad de sus fotogramas y ocho perdieron más de dos tercios. En esta lección crearás la canalización que mide esa cifra, porque así se dimensiona el hardware.
Práctico
En qué se va el tiempo#
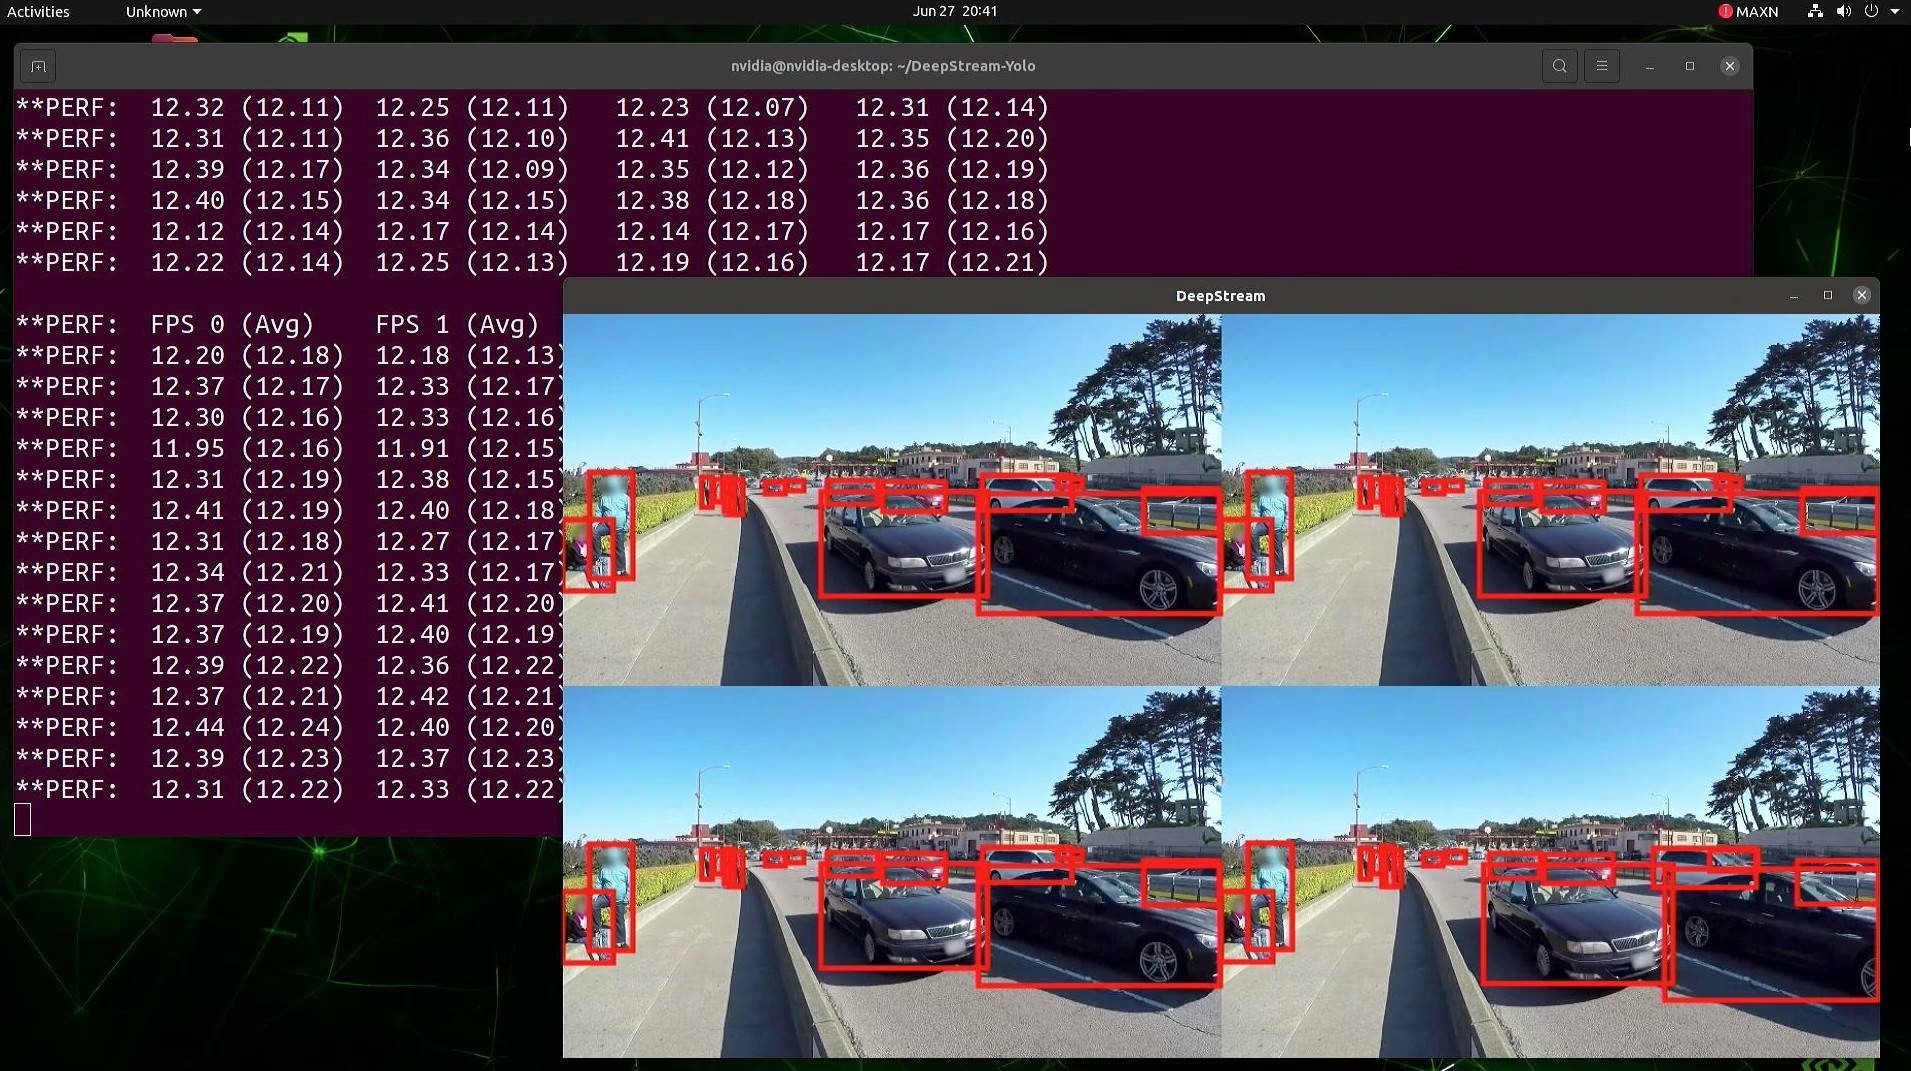
Cada fotograma pasa por cuatro etapas:
| Etapa | Coste típico | Se ejecuta en |
|---|---|---|
| Decodificación (RTSP o archivo → matriz) | 5–20 ms por fotograma de 1080p | CPU |
| Preprocesamiento (letterbox, normalización) | unos 1 ms | CPU |
| Inferencia | unos pocos ms (GPU) hasta decenas de ms (CPU) | Acelerador |
| Posprocesamiento, seguimiento y destinos | unos pocos ms; más si las bases de datos son lentas | CPU |
Si ejecutas las etapas una tras otra, cámara por cámara, en un solo hilo, el acelerador permanece inactivo mientras se decodifican los fotogramas. La solución es separar las etapas, como hace la canalización de DeepStream de arriba: cuatro flujos comparten un dispositivo y cada uno informa de sus propios FPS (unos 12 en este caso). La misma estructura en Python:
Integrado: un archivo .streams#
Ultralytics agrupa varias fuentes en lotes por ti. Pon una fuente por línea en un archivo .streams y pásalo a Predict o al modo Track. Cada flujo tiene su propio hilo lector y su propio rastreador, y en cada iteración se ejecuta una pasada hacia delante por lotes en todos los flujos:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # producción: una URL rtsp:// por línea

model = YOLO("yolo26n.pt")  # usa tu exportación optimizada en producción
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path indica de qué flujo procede este resultado
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Ambos flujos produjeron 62 resultados porque la iteración se detiene cuando termina el flujo más corto (el clip del aeropuerto tiene 150 fotogramas). stream_buffer=True procesó todos los fotogramas, lo adecuado para archivos grabados; con cámaras en directo, mantén el valor predeterminado False para que un modelo lento omita los fotogramas obsoletos en lugar de quedarse atrás. Combínalo con una exportación a TensorRT o OpenVINO para obtener el mayor rendimiento por flujo.
Personalizado: productor-consumidor con contadores de pérdidas#
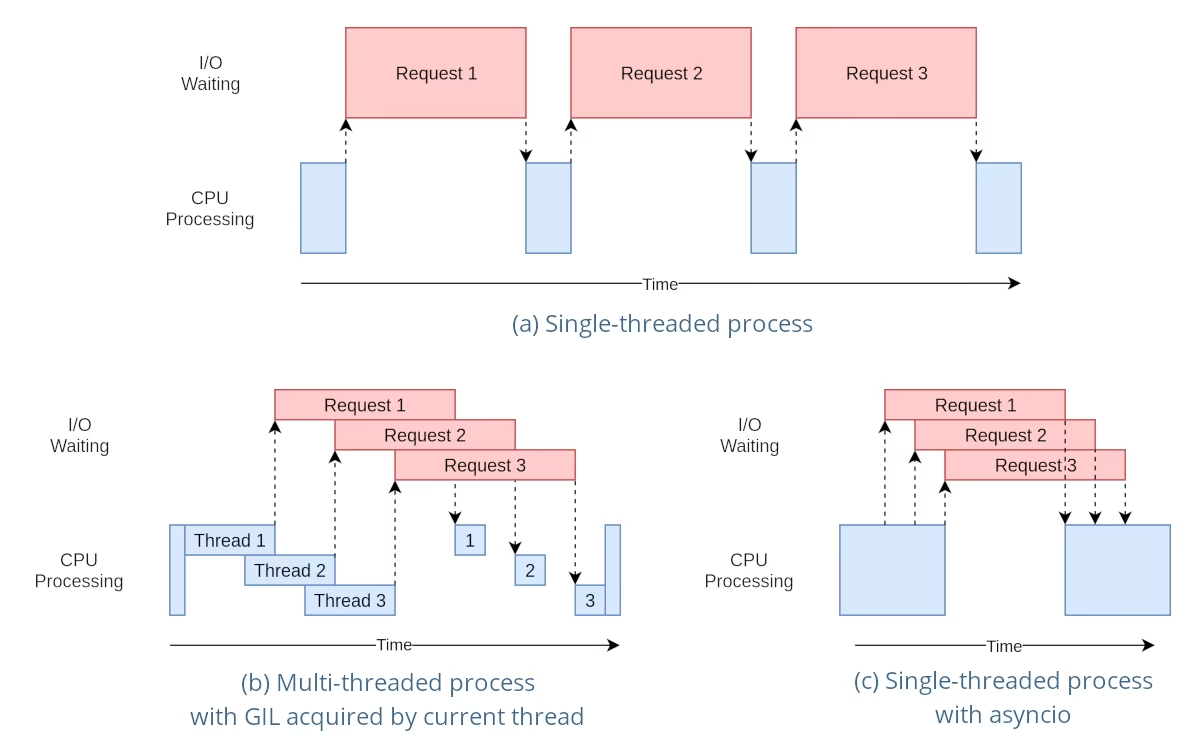
El diagrama muestra por qué los hilos funcionan en esta canalización. La decodificación consiste sobre todo en esperar (las barras rosas de E/S), y OpenCV y PyTorch liberan el GIL de Python mientras trabajan, por lo que los hilos de decodificación se solapan bien (panel b). El posprocesamiento de Python intensivo no se solapa; pásalo a procesos independientes.
Si necesitas destinos propios, lógica específica para cada cámara o métricas explícitas de pérdida, crea tú mismo la canalización. Los hilos de decodificación nunca acceden al modelo; un único bucle consumidor lo controla, lo que también te permite cumplir las reglas de inferencia segura para hilos:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]Los dos clips tienen 62 y 150 fotogramas, y todos los fotogramas se procesan o se pierden (56 + 6 = 62, 131 + 19 = 150), así que los contadores dan cuenta de todos ellos. Se perdieron 25 de los 212 fotogramas: la CPU de este portátil no puede ejecutar yolo26n en PyTorch con dos flujos de 30 FPS. Repite los clips para simular más cámaras; aquí tienes una pasada:
| Flujos (30 FPS cada uno) | Fotogramas perdidos |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Planifica la capacidad a partir de mediciones#
Flujos por dispositivo ≈ rendimiento sostenido (fotogramas por segundo que procesa el modelo con el tamaño de lote utilizado) ÷ FPS necesarios por flujo. Mide el rendimiento con la exportación optimizada de las lecciones anteriores en el hardware real, reserva un margen del 20–30 % para los picos y genera una alerta cuando las pérdidas superen cero. El coste de una resolución más alta es, aproximadamente, proporcional al número de píxeles: 1280×1280 requiere unas 4 veces más capacidad de cálculo que 640×640. Para grandes flotas, Triton Inference Server y DeepStream en Jetson son las opciones naturales para producción.
Errores habituales#
Síntoma: model.track(["cam1.mp4", "cam2.mp4"]) trata la lista como un lote de imágenes, no como secuencias. Solución: escribe las fuentes en un archivo .streams, una por línea.
Síntoma: cada archivo solo produce uno o dos fotogramas. Solución: stream_buffer=False descarta los fotogramas obsoletos y los lectores de archivos se adelantan al modelo; establece stream_buffer=True para los archivos y conserva el valor predeterminado para las cámaras en directo.
Síntoma: aparecen resultados incorrectos o mezclados de forma ocasional cuando hay carga. Solución: no llames nunca a una misma instancia de YOLO desde varios hilos a la vez. Deja que un único consumidor sea su propietario, como se ha explicado, o crea un modelo dentro de cada hilo de inferencia.
Síntoma: la latencia aumenta cada minuto y la memoria sigue creciendo hasta que el proceso falla. Solución: usa una cola acotada que descarte elementos cuando esté llena, junto con un contador de descartes. Los sistemas en tiempo real deben descartar fotogramas cuando hay sobrecarga, no acumular retraso.
Mostrar solución
Convierte el número de flujos en un argumento de línea de comandos añadiendo estas líneas a producer_consumer.py, justo después de la línea SOURCES:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # número de cámaras simuladas
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
A continuación, recorre los valores:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]La respuesta para esta máquina es un flujo: las pérdidas empiezan con dos. Para gestionar cuatro cámaras, exporta a un entorno de ejecución más rápido (lecciones 3 y 4), reduce imgsz o pásate a un acelerador; después, vuelve a recorrer los valores.