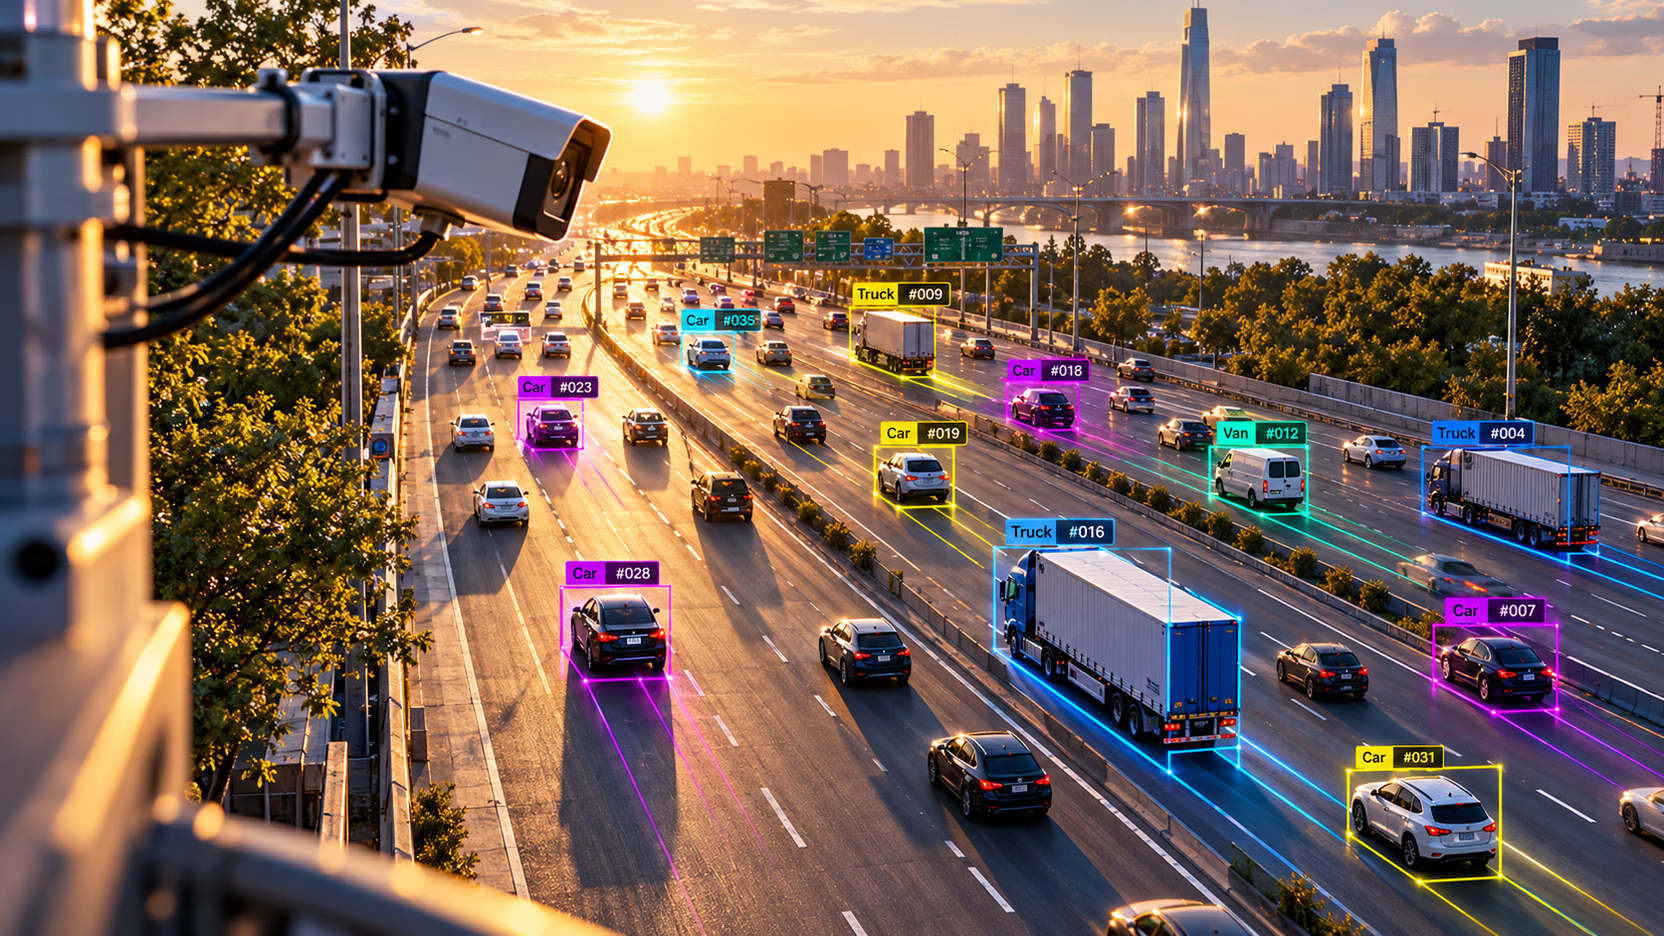
Ultralytics YOLO en producción
Lleva un modelo Ultralytics YOLO entrenado a producción: elige un entorno de ejecución, expórtalo y verifícalo, optimízalo para tu hardware, sigue objetos, crea canalizaciones de recuento, procesa numerosas secuencias y detecta la deriva antes que los usuarios.
Por Ultralytics Academy
Despliega un modelo YOLO26 en el entorno de ejecución adecuado, con una equivalencia verificada; convierte sus detecciones en identificadores y recuentos con seguimiento en numerosas secuencias, y monitorízalo para que los problemas de latencia, precisión y deriva te avisen antes de que los usuarios los detecten.
Elige un entorno de ejecución y un valor de
format=según el dispositivo, el presupuesto de latencia y la flota; después, confírmalo con pruebas comparativas repetidas.Exporta a ONNX y demuestra la equivalencia con PyTorch, incluida la trampa de letterbox con formas estáticas.
Decide entre FP32, FP16 e INT8 en TensorRT y OpenVINO, con datos de calibración y un umbral de precisión.
Sigue objetos con ByteTrack, BoT-SORT o TrackTrack y ajusta los umbrales del seguidor a las confianzas de tu detector.
Crea contadores de líneas, ocupación de zonas, mapas de calor y estimaciones de velocidad calibradas a partir del seguimiento.
Procesa varias secuencias de cámaras con un solo modelo mediante inferencia por lotes, colas limitadas y medición de los fotogramas descartados.
Registra métricas por fotograma, detecta la deriva de confianza con una prueba KS y aplica la medida más económica para reducir la latencia y el coste.
Una decisión sobre el entorno de ejecución para tu dispositivo, respaldada por resultados de pruebas comparativas repetidas frente a un presupuesto en milisegundos.
Una exportación ONNX con una comprobación de equivalencia registrada (cuadros, confianzas y mAP) frente al modelo PyTorch.
Una exportación optimizada (OpenVINO o TensorRT) que haya superado un umbral de mAP y latencia en el hardware de destino.
Una canalización de recuento con una línea de conteo, un recuento por zona, un mapa de calor y una estimación de velocidad calibrada sobre vídeo real.
Un proceso de trabajo multistream que agrupe fotogramas de varias cámaras e informe de los fotogramas procesados y descartados por secuencia.
Un bucle de monitorización: métricas JSON por fotograma, una prueba KS de deriva sobre las confianzas y una validación semanal con un conjunto de retención.
Un modelo entrenado, como
runs/detect/pills_v1/weights/best.ptde Entrena tu primer modelo YOLO, o el punto de control preentrenadoyolo26n.ptpara seguir los pasos.Python 3.10 o posterior con
pip install "ultralytics[solutions]" onnxruntime scipy(solutions añade shapely y lap).Familiaridad con Python, la línea de comandos y las fuentes de vídeo (archivos, webcams y RTSP).
Recomendación: completa primero Entrena tu primer modelo YOLO y Creación de conjuntos de datos YOLO de alto rendimiento.
Contenido del curso
4 módulos · 9 leccionesMódulo 1
Elige un destino de despliegue
A partir del dispositivo, el presupuesto de latencia y la flota, elige un entorno de ejecución y un formato de exportación; después, confírmalo en el dispositivo.
Exportar a ONNX (y verificar la paridad)
Exporta un modelo ONNX portátil y comprueba que coincide con PyTorch en los cuadros delimitadores, las confianzas y mAP antes de implementar nada.
Módulo 2
Módulo 3
Sigue objetos con ByteTrack, BoT-SORT y TrackTrack
Asigna a cada objeto un ID estable entre fotogramas, elige un rastreador y ajusta sus umbrales a tu detector.
Recuentos, mapas de calor y estimación de velocidad
Crea contadores de líneas, ocupación de zonas, mapas de calor y estimaciones de velocidad a partir del seguimiento, y calibra los valores con rigor.
Módulo 4
Inferencia con varios flujos
Ejecuta varias cámaras con un mismo modelo mediante inferencia por lotes, colas con límites y mediciones de los fotogramas perdidos.
Observabilidad y deriva
Registra las métricas que detectan pérdidas silenciosas de precisión, comprueba si hay deriva en las distribuciones de confianza y genera alertas solo ante señales que requieran una acción.
Ajuste de costes y latencia
Perfila todo el pipeline, acciona por orden las palancas que realmente reducen la latencia y el coste, y detente al alcanzar el presupuesto.