OpenVINO en CPU
Exporta modelos OpenVINO en FP32, FP16 e INT8, valida cada uno y conserva INT8 solo cuando te aporte ventajas en tu propia CPU.
Una CPU Intel que ya tengas puede sustituir a menudo una instancia con GPU: en las pruebas de rendimiento de Ultralytics, YOLO26m pasa de 192 ms en PyTorch a 36 ms con OpenVINO INT8 en una CPU Core Ultra de portátil. Sin embargo, las mejoras dependen del chip y, en el portátil de prueba ARM de este curso, una exportación INT8 calibrada con cuatro imágenes perdió 3 puntos de mAP. Aprenderás a medir en qué caso estás antes de publicar.
Práctico
Qué ofrece OpenVINO#
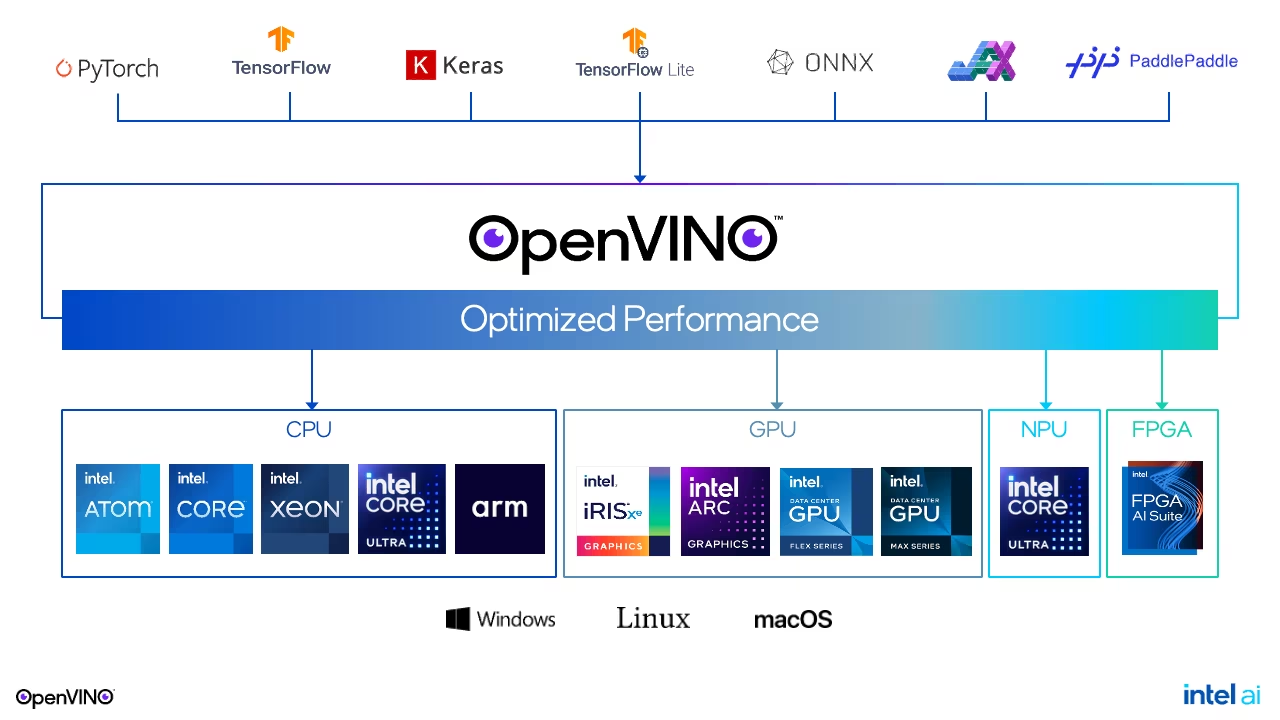
OpenVINO acepta modelos de PyTorch y ONNX y los ejecuta en CPU Intel, GPU integradas y discretas y NPU mediante una única API. Sus kernels de CPU están optimizados para los conjuntos de instrucciones de Intel (AVX2, AVX-512, AMX), y su ruta INT8 está muy desarrollada. Fíjate en el recuadro ARM de la columna de CPU: OpenVINO también funciona en ARM, pero sus kernels están optimizados para Intel, así que mide el rendimiento antes de confiar en él.
La prueba de rendimiento publicada en una CPU Intel Core Ultra 7 155H (COCO128):
| Modelo | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 de FP32 a INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
De esa tabla se desprenden tres reglas:
- OpenVINO FP32 por sí solo reduce aproximadamente a la mitad la latencia de PyTorch en una CPU Intel. Empieza por aquí.
- INT8 aporta más ventajas a medida que crece el modelo: 1,2× para
n, 2,9× param, a cambio de entre 1,2 y 1,7 puntos de mAP. Enn, INT8 rara vez compensa la pérdida de precisión. - Prueba la GPU integrada antes de comprar hardware: la iGPU Arc del mismo chip (
device="intel:gpu") ejecutó YOLO26n FP32 en 9,13 ms y YOLO26m en 34,47 ms.
Compara los niveles de precisión en tu propia CPU#
Exporta cada nivel de precisión, valídalo inmediatamente y solo entonces exporta el siguiente:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/Qué indica cada línea:
- FP32 y FP16 obtienen la misma puntuación y FP16 ocupa la mitad (5,1 frente a 9,6 MB), pero ambos se escribieron en la misma carpeta. Si hubieras exportado ambos primero y los hubieras validado después, habrías medido FP16 dos veces.
- INT8 ocupa 3,2 MB y perdió 3,2 puntos, porque se calibró con las cuatro imágenes de COCO8. La advertencia lo indica: una calibración real necesita cientos de imágenes representativas de producción de tu propio YAML (
fractionlimita cuántas se usan). - Nada de esto mide la velocidad. Para eso, usa la prueba de rendimiento de abajo.
Para ejecutar un modelo exportado en un dispositivo Intel concreto:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # o intel:gpu, intel:npu
Publica la carpeta completa: yolo26n.xml (el grafo), yolo26n.bin (los pesos) y metadata.yaml. intel:gpu y intel:npu necesitan hardware Intel.
Mídelo frente a ONNX Runtime#
La precisión ya está resuelta; la velocidad se determina en el dispositivo de destino, bajo la carga de trabajo real que deberá soportar. Ejecuta pick_runtime.py de la primera lección con CANDIDATES = ("onnx", "openvino"). En el portátil de prueba con Apple silicon, mientras otros trabajos compartían la CPU:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO tuvo una mediana mejor y una cola mucho peor. El wrapper de Ultralytics compila OpenVINO con la sugerencia LATENCY (el registro indica Using OpenVINO LATENCY mode for batch=1 inference on CPU), que distribuye cada solicitud entre los núcleos de la CPU; cuando otras tareas compiten por esos núcleos, las solicitudes más lentas son las que más sufren. En un equipo Intel dedicado, los resultados suelen parecerse a los publicados arriba, pero solo tu propio p95 puede confirmártelo.
Reglas para decidir:
Errores habituales#
Síntoma: la exportación FP16 ocupa la mitad y es igual de lenta. Solución: en la mayoría de las CPU, el complemento elige su propia precisión de ejecución; usa FP16 para reducir el tamaño de las descargas e INT8 o la iGPU para ganar velocidad.
Síntoma: FP32 y FP16 muestran cifras idénticas porque eran el mismo archivo. Solución: las exportaciones FP32 y FP16 comparten la carpeta *_openvino_model/; valida (o cambia el nombre de la carpeta) justo después de cada exportación.
Síntoma: la media parece correcta, pero se siguen perdiendo fotogramas en los momentos de mayor actividad. Solución: mide el tiempo de inferencia con la carga de producción en marcha y fíjate en el p95, no en la media. Para ejecutar muchas secuencias en un servidor, compila con la sugerencia THROUGHPUT cargando .xml directamente con el entorno de ejecución de OpenVINO, como se explica en la guía sobre modos de latencia y rendimiento.
En macOS y Windows, la validación inicia procesos de trabajo que vuelven a importar tu script. Sin if __name__ == "__main__":, la prueba de esta lección repitió las exportaciones dentro de esos procesos, desperdició minutos y compitió por la CPU que intentaba medir.
Mostrar solución
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Una decisión práctica con los valores anteriores del Core Ultra 7 155H:
| Opción | mAP50-95 | Cantidad | ms por imagen |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Despliega OpenVINO FP32 en la GPU integrada: es la opción más rápida y no pierde precisión, mientras que INT8 en la CPU costaría 1,2 puntos para ahorrar 2 ms. En un despliegue de YOLO26m, la respuesta cambia a CPU INT8 (2,9 veces más rápido por 1,7 puntos), si esa pérdida entra en tu presupuesto.