Ajuste de costes y latencia
Perfila todo el pipeline, acciona por orden las palancas que realmente reducen la latencia y el coste, y detente al alcanzar el presupuesto.
Los equipos pierden semanas arañando milisegundos al modelo mientras que el verdadero cuello de botella es una escritura en la base de datos o un decodificador RTSP. Hay pocas palancas importantes y se pueden medir bien: YOLO26s tarda 2,2 veces más que YOLO26n en CPU para obtener 7,7 puntos más de mAP, y ejecutar la detección en uno de cada dos fotogramas reduce el trabajo a la mitad. En esta lección aprenderás a perfilar primero, accionar la palanca más eficaz que encaje y detenerte al alcanzar un presupuesto definido de antemano.
Práctico
Mide primero todo el pipeline#
Cada objeto Results divide su propio tiempo en etapas:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameAquí la inferencia representa el 95 % del tiempo del modelo, así que las palancas relacionadas con el modelo serán útiles. Mide también la decodificación y tus propios procesos de envío de resultados de la misma manera (con time.perf_counter() alrededor de cada uno) y, después, aplica la regla correspondiente a lo que encuentres:
| Lo que mides | Qué corregir primero |
|---|---|
| 60 ms de decodificación RTSP, 5 ms de inferencia | Decodificación por hardware, menor resolución del flujo o más hilos de decodificación |
| 30 ms de inferencia, 100 ms de posprocesamiento en Python | Vectoriza con NumPy o trasládalo a un proceso de trabajo |
| 5 ms de inferencia, 200 ms de escrituras en la base de datos | Agrupa las escrituras o hazlas de forma asíncrona |
| La inferencia es el factor dominante | La clasificación de palancas de abajo |
Clasificación de palancas#
Empieza por arriba y detente cuando alcances el presupuesto:
| Medida | Aumento de velocidad habitual | Coste habitual en precisión |
|---|---|---|
| Modelo más pequeño (m → s, s → n) | 1.5–2.5× | Entre 4,5 y 7,7 puntos de mAP en COCO; menos en tareas específicas |
imgsz más pequeño (640 → 480) | Aproximadamente 1,8× | Primero, objetos pequeños y lejanos |
| Entorno de ejecución más rápido, FP16 | Aproximadamente 1,5× en GPU | Normalmente ninguno; verifica que haya paridad |
| INT8 con calibración | Un 1,2× adicional en GPU; hasta 2,9× en CPU | 1 punto (YOLO26n) a 4–6 puntos (modelos más grandes); QAT recupera la mayor parte |
Menos fotogramas (vid_stride=N) | Hasta N× | Se pueden perder objetos rápidos y eventos breves |
| Lotes más grandes (servidores) | Mayor rendimiento, no menor latencia | Ninguno |
Las cifras proceden de las tablas de pruebas de rendimiento de YOLO26, TensorRT y OpenVINO, así como de las mediciones de abajo; tus resultados serán distintos, así que mide.
Modelo más pequeño#
La tabla de pruebas de rendimiento de YOLO26 en COCO:
| Modelo | mAP50-95 | CPU ONNX (ms) | T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
En CPU, cada paso hacia un modelo más pequeño es entre 2,2 y 2,5 veces más rápido. La diferencia de precisión en COCO representa el peor caso: un detector de almacén con 3 clases y objetos grandes suele perder mucho menos al pasar de m a n que un detector general de 80 clases, así que siempre merece la pena probar el modelo más pequeño con tu propio conjunto de validación.
Entrada más pequeña#
El cálculo escala aproximadamente con el número de píxeles, así que imgsz=480 requiere alrededor del 56 % del trabajo que requiere 640. Medición en la CPU del portátil de pruebas con ONNX Runtime y lote 1 (mediana de 25 ejecuciones en bus.jpg):
| Modelo | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Criterio de decisión: si el objeto importante más pequeño sigue ocupando unos 10 píxeles o más con el nuevo tamaño, pruébalo; si los objetos son pequeños o lejanos (drones, estanterías alejadas de la cámara), conserva la resolución y reduce el tamaño del modelo.
Menos fotogramas#
Si la inferencia limita tu frecuencia de fotogramas y la escena se mueve despacio, ejecuta la detección en uno de cada N fotogramas con vid_stride=N y deja que el rastreador cubra los intervalos:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsProcesar la mitad de los fotogramas cuesta aproximadamente la mitad de tiempo, y el rastreador mantuvo 30 de las 32 identidades. Con vid_stride=3 perdió 4, lo que indica que debes detenerte en esta escena a ritmo de paseo.
Reduce los costes en la nube#
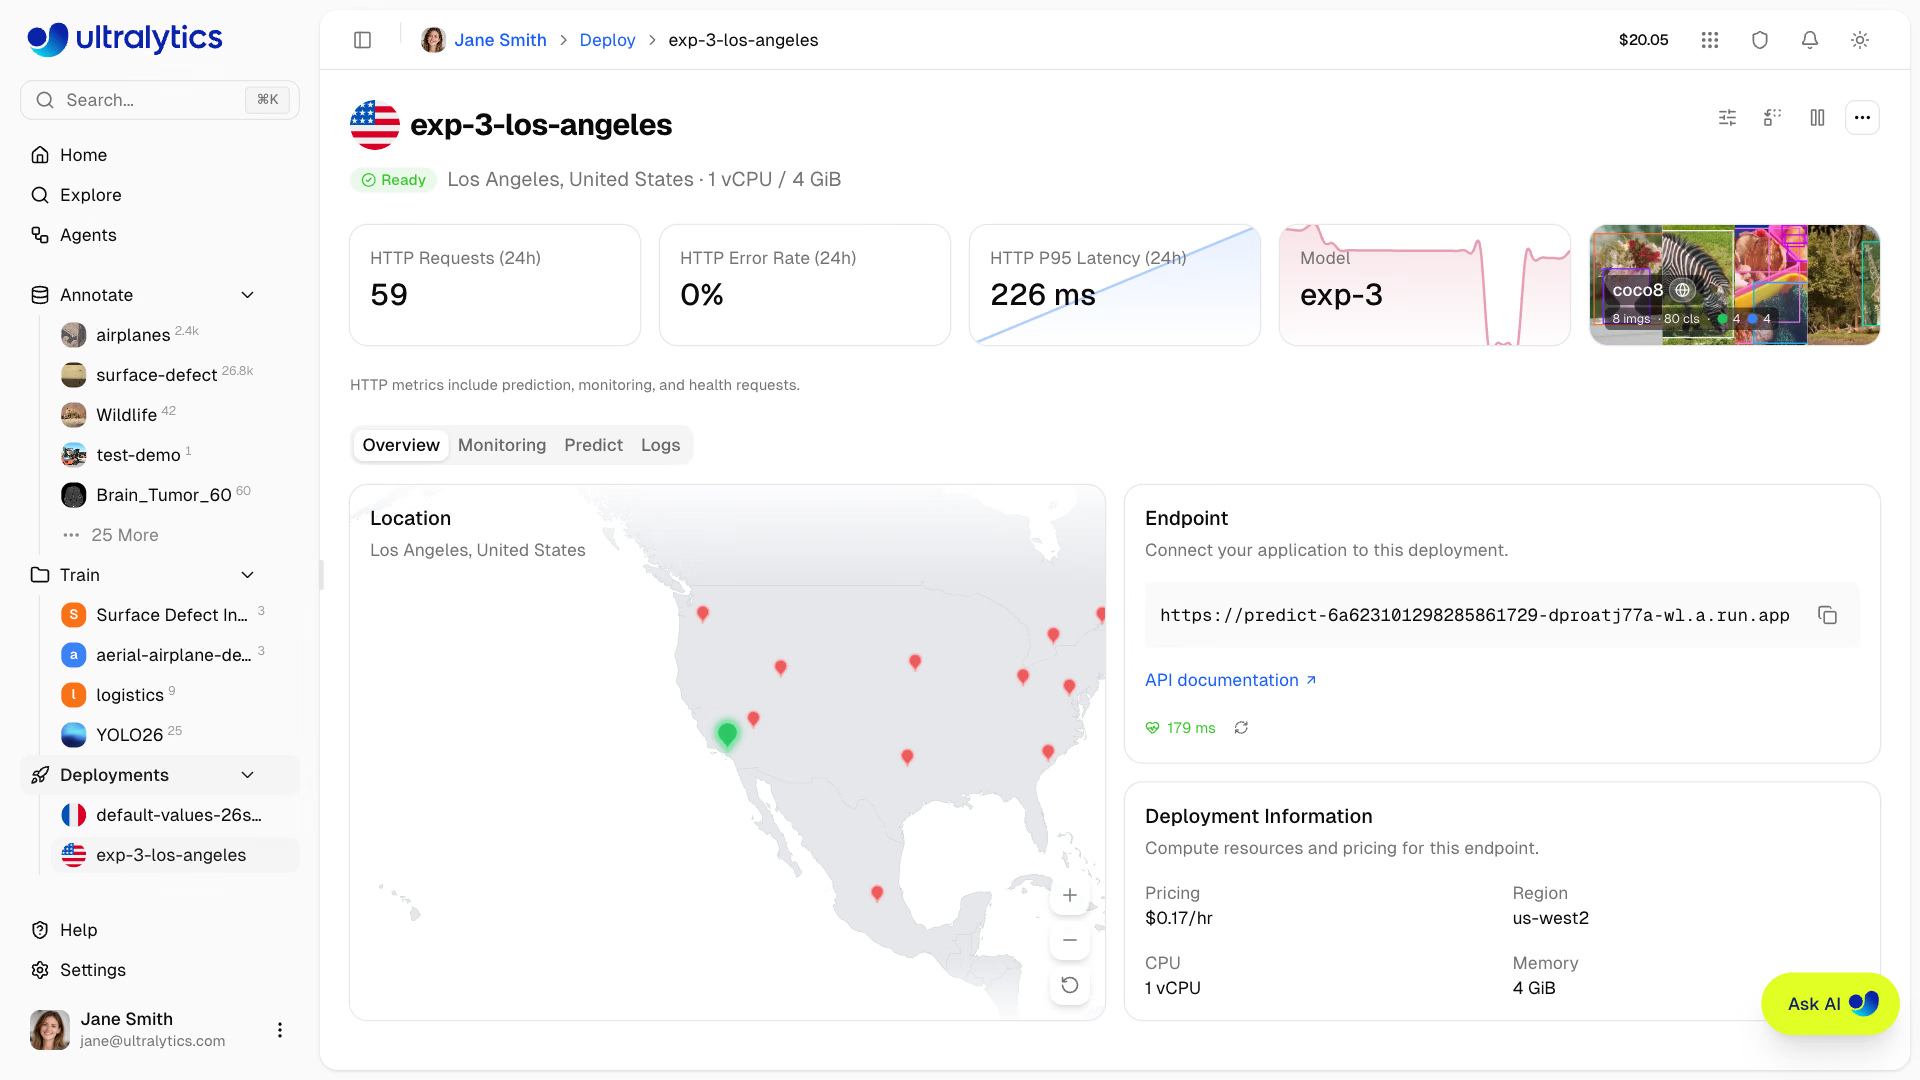
El coste equivale a las horas de instancia divididas entre el trabajo útil. Una tarjeta como esta muestra las dos cifras que necesitas: cuánto cuesta una hora (0,17 $ por 1 vCPU y 4 GiB en este caso) y cuánto trabajo realiza (59 solicitudes en 24 horas, con una latencia P95 de 226 ms; el endpoint está inactivo la mayor parte del tiempo). A continuación:
- Aumenta la utilización. Una GPU con una utilización del 30 % desperdicia el 70 % de lo que pagas. Agrupa los flujos (lecciones anteriores) o sirve el modelo mediante Triton Inference Server.
- Ajusta el tamaño. Compara el rendimiento en una GPU más pequeña o en una CPU con OpenVINO antes de dar por hecho que necesitas una GPU grande.
- Usa capacidad bajo demanda o interrumpible para trabajos por lotes. El reprocesamiento de vídeo archivado tolera las interrupciones; los flujos en directo, no.
Errores habituales#
Síntoma: dos semanas de ajustes ahorran 10 ms y el sistema sigue siendo lento. Solución: analiza primero el perfil de toda la cadena de procesamiento y corrige la etapa más lenta, sea cual sea.
Síntoma: usar if i % 2: continue dentro del bucle de resultados no ahorra nada. Solución: el modelo ya se ha ejecutado en ese fotograma; sáltatelo en la fuente con vid_stride.
Síntoma: ha aumentado el rendimiento, pero ahora cada fotograma llega más tarde. Solución: los lotes más grandes aumentan el rendimiento por euro, no reducen la latencia por fotograma; úsalos con muchas secuencias o en tareas sin conexión, no con una sola cámara en tiempo real.
Cuando ya hayas agotado las opciones de mejora del modelo, la siguiente es mejorar los datos. Un conjunto de datos que se ajuste a la producción permite que un modelo más pequeño alcance la precisión que antes requería uno más grande: reduces los costes sin perder precisión.
Mostrar solución
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Cada fila descarta las cinco primeras ejecuciones como calentamiento y muestra la mediana del resto. Elige la primera fila que cumpla el presupuesto de latencia con una pérdida de mAP dentro de tu presupuesto. Un presupuesto de ejemplo: «dos días, como máximo 1 punto de mAP y 20 FPS en el equipo de la tienda». Si yolo26s a 640 no baja de 50 ms por fotograma y yolo26n a 640 sí lo consigue con una pérdida de hasta 1 punto en tu conjunto de validación, detente ahí; no dediques el segundo día a 480.