Compara ejecuciones y elige una ganadora
Compara ejecuciones en un proyecto de Platform, registra el motivo de cada ejecución y decide si publicar un candidato mediante un criterio de promoción automatizado.
Los modelos más grandes suelen ganar en la métrica principal y luego fallan en una clase que nadie ha comprobado. Sin una regla decidida de antemano, se publica la ejecución que más le ha gustado a alguien. En esta lección se registra cada ejecución para poder consultar más adelante el razonamiento y se convierte «¿es mejor?» en un script de evaluación que devuelve PASS o FAIL.
Práctico
Compara ejecuciones en un proyecto#
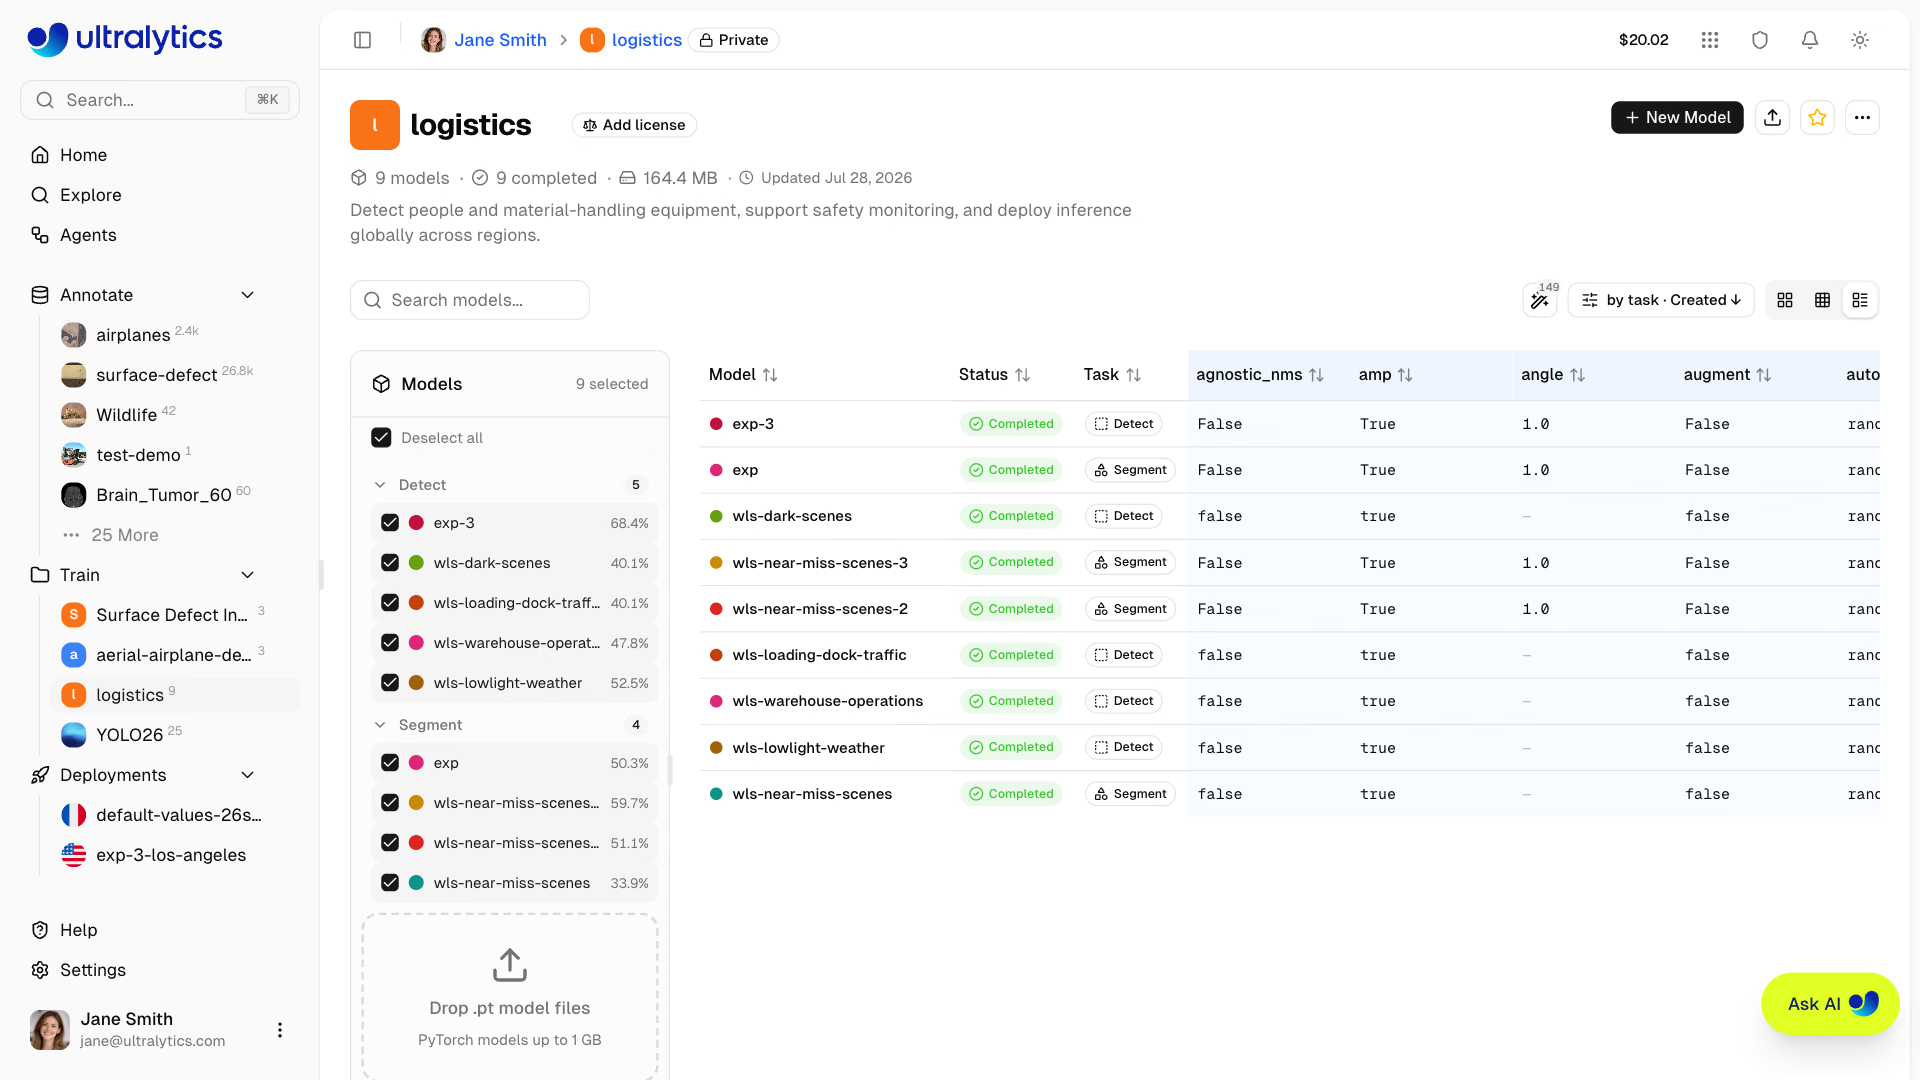
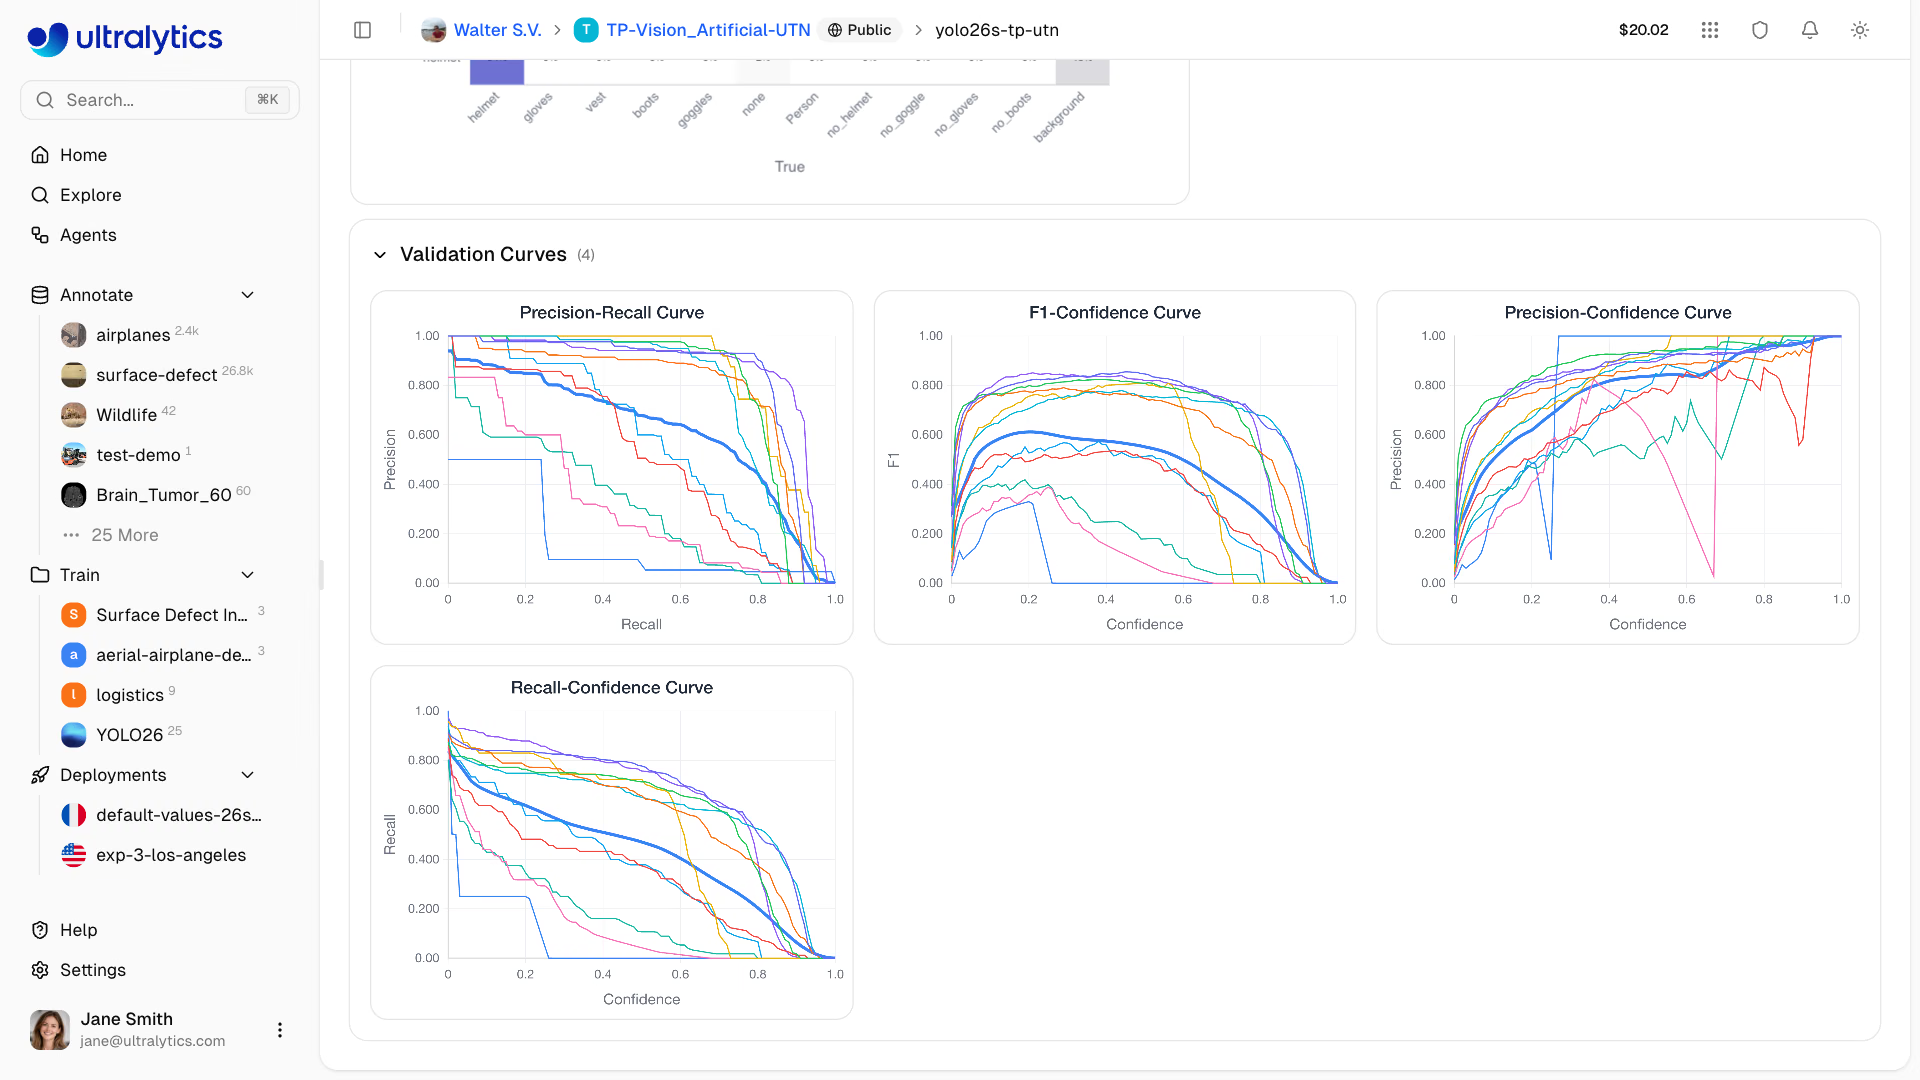
Un proyecto muestra sus modelos con casillas de selección. Los modelos seleccionados se superponen en el panel Charts; la vista Table alinea los argumentos de entrenamiento y las métricas finales, y Diff oculta las columnas idénticas para que veas de un vistazo que dos ejecuciones solo difieren en imgsz. La comparación solo funciona dentro de un proyecto, así que reúne los experimentos relacionados (puedes cortar y pegar modelos entre proyectos). Al leer las curvas, compara el valor final, cuánto tardó cada ejecución en alcanzarlo y la suavidad de la evolución.

Con dos o más modelos completados, Compare with AI pide a Ask AI que resuma las diferencias y proponga el siguiente experimento. Trata su propuesta como una hipótesis para tu próxima ejecución, no como un veredicto.
Haz que cada ejecución se pueda explicar#
Los nombres transmiten el significado: run_5 no dice nada, mientras que v3_pallets_added y v4_imgsz1024 indican la versión del conjunto de datos y qué ha cambiado. Para registrar el razonamiento, abre More actions > Information en la página del modelo y guarda una nota JSON como Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Platform registra el resto: la tarjeta Run Information muestra la GPU, la tarifa por hora, el coste total, la versión ultralytics, el host, el modelo principal, la versión fijada del conjunto de datos, el commit de Git cuando está disponible y un comando yolo train que puedes copiar. Las comparaciones solo son justas entre ejecuciones con la misma versión del conjunto de datos, por eso cada ejecución debe tener una versión fijada.
Elige la métrica y los criterios antes de mirar#
| Métrica | Cuándo es la opción adecuada |
|---|---|
| mAP50-95 | Valor predeterminado para detect, segment, pose y OBB: premia las cajas ajustadas y es lo bastante estable para comparar |
| mAP50 | Objetos grandes y bien separados, donde importa poco el ajuste de las cajas |
| AP por clase para una sola clase | Una clase determina el valor para el negocio |
| Exhaustividad con precisión fija | Sistemas de seguridad y alarma |
| Latencia de inferencia en el dispositivo de destino | Siempre, como límite estricto |
La guía de métricas de rendimiento de YOLO explica cada una. Un candidato solo se publica si supera todos los criterios:
Ejemplo práctico: script para evaluar una promoción#
Descarga los archivos best.pt de los finalistas y evalúalos con los mismos datos y el mismo código. Este ejemplo utiliza dos puntos de control oficiales, así que puede ejecutarse en cualquier sitio:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsQué ha ocurrido: el modelo más grande gana en conjunto por 2,4 puntos, pero dos clases pierden más del 10 % de su AP, así que no supera la evaluación. Esa es la regresión que oculta una comparación de la métrica principal. El diccionario por clase procede de ap_class_index y ap, que solo incluyen las clases presentes en los datos; la latencia se mide en la máquina que ejecuta el script, así que ejecuta la evaluación en un hardware parecido al de tu destino de implementación. COCO8 solo tiene 8 imágenes de validación, demasiado pocas para tomar una decisión real. Usa un conjunto reservado de al menos unos cientos de imágenes y pasa split="test" exactamente una vez, para la decisión final.
Analiza las imágenes problemáticas#
En las ejecuciones de detección entrenadas con una versión guardada del conjunto de datos, la vista Validation añade Validation insights: las imágenes con mejores y peores resultados según el F1 por imagen, con la verdad fundamental superpuesta; un explorador de características que correlaciona el F1 con el tamaño, la relación de aspecto y el número de instancias de la imagen; y las clases más asociadas a los fallos. Find similar en las imágenes con peores resultados añade imágenes parecidas al conjunto de entrenamiento como imágenes sin etiquetar, y convierte una evaluación fallida en una tarea de datos concreta.
Errores habituales#
Síntoma: el mAP de prueba comunicado es excelente, pero en producción es peor. Solución: ajusta con validación. Si comparaste diez ejecuciones con los datos de prueba, ya los has usado para ajustar y la cifra es optimista. Evalúa a los finalistas con los datos de prueba una sola vez, al final.
Síntoma: una ejecución «gana» por 4 puntos y nadie puede reproducir el motivo. Solución: comprueba la versión fijada del conjunto de datos en la tarjeta Run Information de cada ejecución. Si son distintas, vuelve a ejecutar la línea base con la nueva versión antes de comparar.
Síntoma: el ganador cambia cada vez que vuelves a entrenar con una nueva semilla. Solución: en la mayoría de los conjuntos de datos, las diferencias inferiores a unos 0,5 puntos de mAP son ruido entre ejecuciones. Mantén el umbral de ruido en el criterio de aceptación y usa un conjunto de reserva más grande cuando los resultados estén tan igualados.
Mostrar solución
Ejemplo resuelto para el modelo de pastillas: línea base v1-baseline (10 épocas) frente al candidato v2-finetune (5 épocas más, SGD, lr0 0.001). Establece DATA = "medical-pills.yaml" y los dos pesos en gate.py. Resultado: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms, veredicto «publicar el candidato». Custom Metadata en v2: hipótesis «v1 seguía mejorando en la época 10», cambio «ajustar durante 5 épocas, SGD lr0 0.001», resultado «mAP50-95 0.659 -> 0.687». Anota esta salvedad en los metadatos: el conjunto val medical-pills también orientó el entrenamiento, así que confirma el resultado con un conjunto reservado independiente antes de pasar a producción.