Planifica y presupuesta un proyecto en Platform
Asigna cada etapa del ciclo de vida de tu proyecto a Platform o a tu propia pila tecnológica, y calcula su coste mensual antes de gastar créditos.
Los proyectos de visión rara vez fracasan por el modelo. Fracasan en los traspasos: una corrección de etiquetas que nunca llega a la copia de entrenamiento, un punto de control cuyo origen de datos nadie puede rastrear, un endpoint siempre activo que consume discretamente 150 $ al mes. Ultralytics Platform conecta esos traspasos en un único espacio de trabajo, y en esta lección decidirás, antes de cargar nada, qué etapas gestionará para tu proyecto y cuánto costarán.
Práctico
El ciclo que conecta Platform#
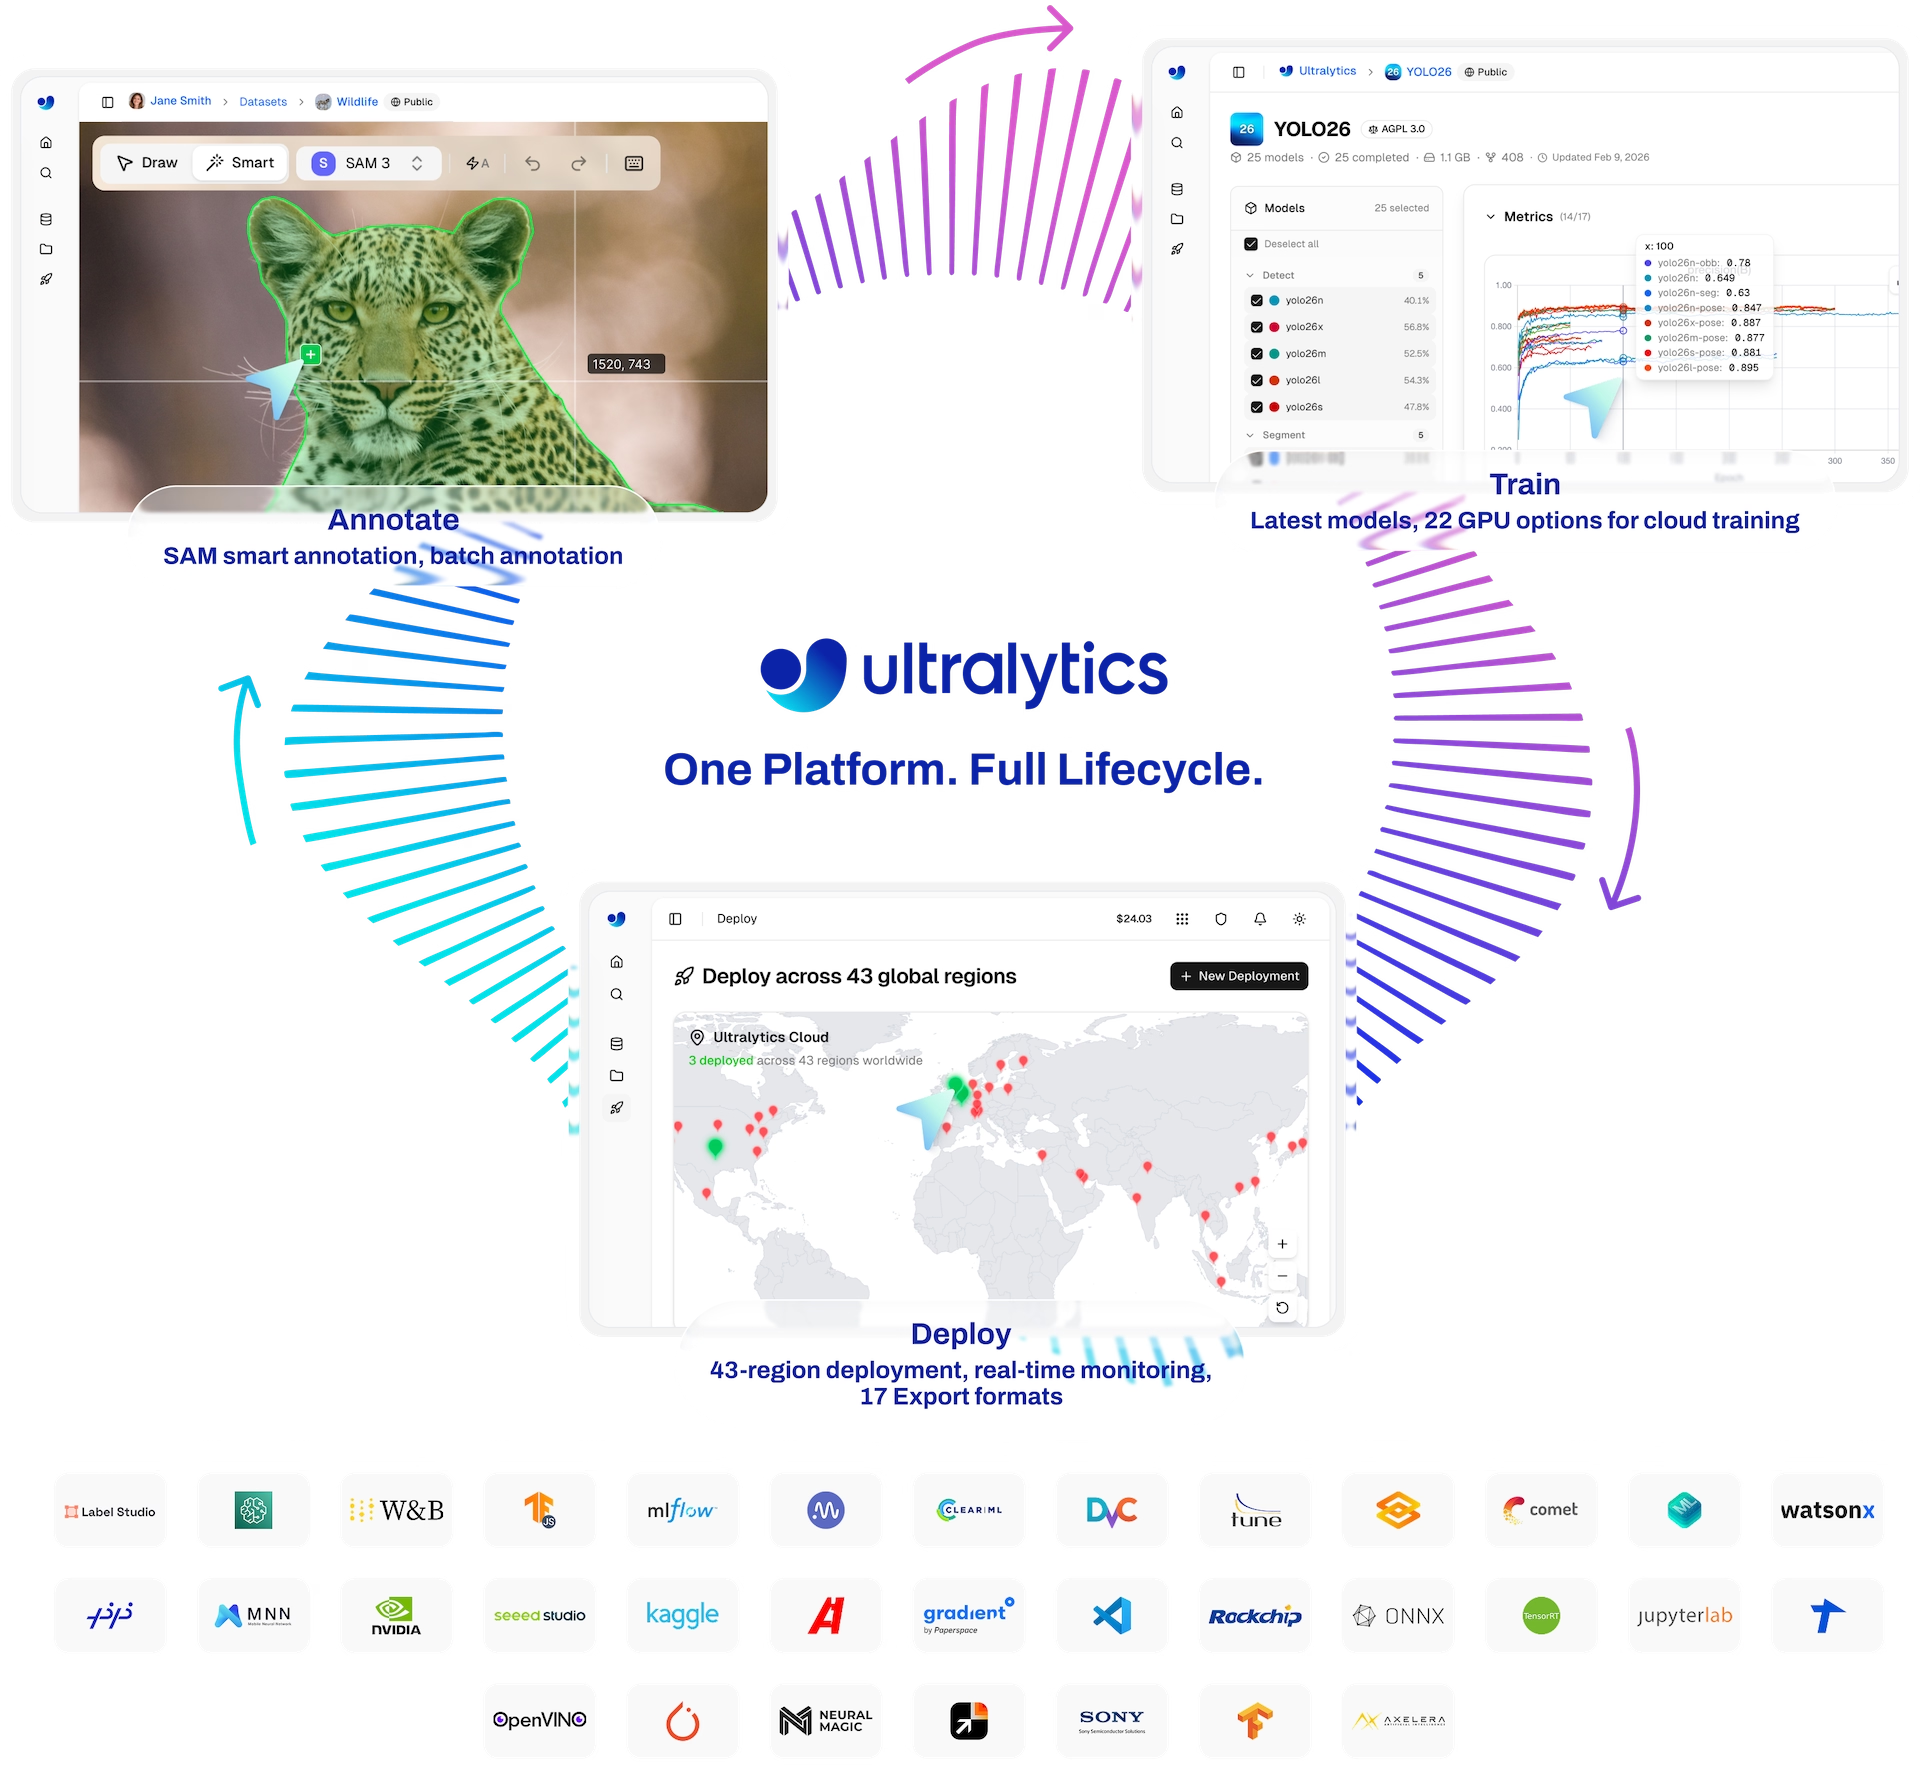
Todos los sistemas de visión en producción siguen el mismo ciclo, y la parte costosa es la flecha entre dos cajas, no la caja en sí:
El valor de Platform reside en que cada etapa registra lo que necesita la siguiente. Usa esta tabla como guía; la última columna indica la lección que explica la etapa:
| Etapa | En Ultralytics Platform | Qué entrega a la siguiente etapa | Lección |
|---|---|---|---|
| Datos | Carga imágenes, vídeos y archivos comprimidos (YOLO, COCO, NDJSON); importa una URL; lee Google Cloud Storage, Amazon S3 o Azure Blob Storage directamente (Pro); instalación local (Enterprise) | Un conjunto de datos con un tipo de tarea y particiones | 2 |
| Anotar | Herramientas manuales para todas las tareas de YOLO excepto profundidad (se importa como mapas emparejados), SAM, anotación inteligente con YOLO y basada en clases, anotación por lotes | Etiquetas, además de una versión guardada antes de cada ejecución por lotes | 3 |
| Seleccionar | Agrupación, búsqueda de imágenes similares, combinación de clases, herramientas para dividir, versiones numeradas | Una versión inmutable del conjunto de datos | 4 |
| Train | 26 tipos de GPU en la nube con una estimación de costes, o ejecuciones locales transmitidas a un proyecto | Un modelo vinculado a su versión del conjunto de datos, su coste y su comando | 5 |
| Comparar | Gráficos del proyecto, vista de tabla con diferencias, información de validación | La ejecución que merece la pena poner en producción | 6 |
| Implementar | Puntos de conexión dedicados en 42 regiones; sustituye el modelo en la misma URL | Una URL de punto de conexión vinculada a su modelo | 7 |
| Supervisar | Métricas de solicitudes, errores y latencia P95, registros, estadísticas de predicción, guardar en el conjunto de datos | Imágenes de producción de vuelta en un conjunto de datos | 8 |
Dos herramientas cubren todo el ciclo. Agents crea flujos de trabajo visuales, como recopilar detecciones inciertas en un conjunto de datos de revisión, y Ask AI puede entrenar, comparar, anotar, exportar e implementar desde una conversación mediante los mismos comandos ul cloud que puedes ejecutar tú mismo.
Decide qué aspectos sigues gestionando tú#
La plataforma tiene unos pocos límites bien definidos. Asigna un responsable con nombre a cada uno en tu plan:
- Extraer fotogramas de sistemas propietarios (archivos DICOM, cámaras OEM, historiadores de planta): tu código los carga en un bucket o los sube.
- Avisos. La plataforma muestra las métricas de los puntos de conexión y publica eventos de tareas en Slack, pero no avisa cuando se superan los umbrales de latencia o errores. Crearás esa comprobación en la lección 8.
- Precisión a lo largo del tiempo. El conjunto de validación etiquetado y su historial son tuyos (lección 8).
- Lógica de la aplicación. El recuento, el seguimiento y las reglas de zona residen en tu servicio; Ultralytics Solutions y el curso Ultralytics YOLO in Production los explican.
- Enrutamiento del tráfico. Los puntos de conexión tienen URL generadas y no admiten dominios personalizados, así que necesitarás tu propia pasarela para canarios, enrutamiento multirregional y nombres de host personalizados.
La plataforma no es un framework independiente. Un modelo de Platform se descarga como un best.pt normal que YOLO("best.pt") carga, valida y exporta; y un model.train(..., project="username/my-project") local se transmite a Platform con una clave de API configurada. Pasar de uno a otro no implica convertir nada.
Ejemplo práctico: calcula el presupuesto del proyecto antes de empezar#
Tres cosas consumen créditos: el entrenamiento en la nube (tarifa de la GPU × tiempo de uso), la anotación por lotes y el difuminado de caras de todo el conjunto de datos (1,00 $ por cada 1.000 imágenes), y los puntos de conexión de tamaño personalizado (se facturan por hora de disponibilidad). Todo lo demás de este curso es gratis. Esta calculadora utiliza las tarifas reales de Platform para un pequeño proyecto de detección:
# Monthly Platform budget for a small detection project (rates from the billing and deployment docs)
TRAIN_RUNS = 8  # experiments per month
COST_PER_RUN = 0.23  # dialog estimate: ~1,000 images, YOLO26n, 100 epochs, RTX PRO 6000 ($2.09/h)
BATCH_ANNOTATION_IMAGES = 3_000  # $1.00 per 1,000 images
HOURS_PER_MONTH = 730

# Custom endpoint sizes keep one warm instance; us-central1 rates are $0.000024/vCPU-s and $0.0000025/GiB-s
warm_endpoint_hourly = (2 * 0.000024 + 4 * 0.0000025) * 3600  # 2 vCPU, 4 GiB

lines = {
    "cloud training": TRAIN_RUNS * COST_PER_RUN,
    "batch annotation": BATCH_ANNOTATION_IMAGES / 1000 * 1.00,
    "default endpoint (1 vCPU, 2 GiB, scales to zero)": 0.0,
    "warm endpoint (2 vCPU, 4 GiB, always on)": warm_endpoint_hourly * HOURS_PER_MONTH,
}
for item, usd in lines.items():
    print(f"{item:<50} ${usd:>7.2f}")
print(f"{'total with a warm endpoint':<50} ${sum(lines.values()):>7.2f}")
cloud training $ 1.84
batch annotation $ 3.00
default endpoint (1 vCPU, 2 GiB, scales to zero) $ 0.00
warm endpoint (2 vCPU, 4 GiB, always on) $ 152.42
total with a warm endpoint $ 157.26Cómo interpretarlo:
COST_PER_RUNprocede de la estimación del cuadro de diálogo de entrenamiento, que tiene en cuenta el tamaño del conjunto de datos, el modelo, las épocas, el tamaño de imagen y la GPU. Sustitúyelo por la estimación de tu propio conjunto de datos (lección 5); 5.000 imágenes × YOLO26s × 100 épocas en una H100 SXM cuestan unos 1,56 $.- La partida del punto de conexión es la más cara. Entrenar y etiquetar un proyecto pequeño cuesta unos pocos dólares; mantener una instancia activa 730 horas al mes cuesta unos 150 $ en Iowa (las tarifas varían según la región y el cuadro de diálogo de implementación muestra el precio exacto por hora).
- Regla para decidir: empieza siempre con el tamaño gratuito predeterminado para cada punto de conexión. Pásate a un tamaño personalizado solo cuando los usuarios no puedan tolerar un arranque en frío de hasta un minuto y el tráfico sea lo bastante constante como para justificar el coste por tiempo de actividad.
Planes#
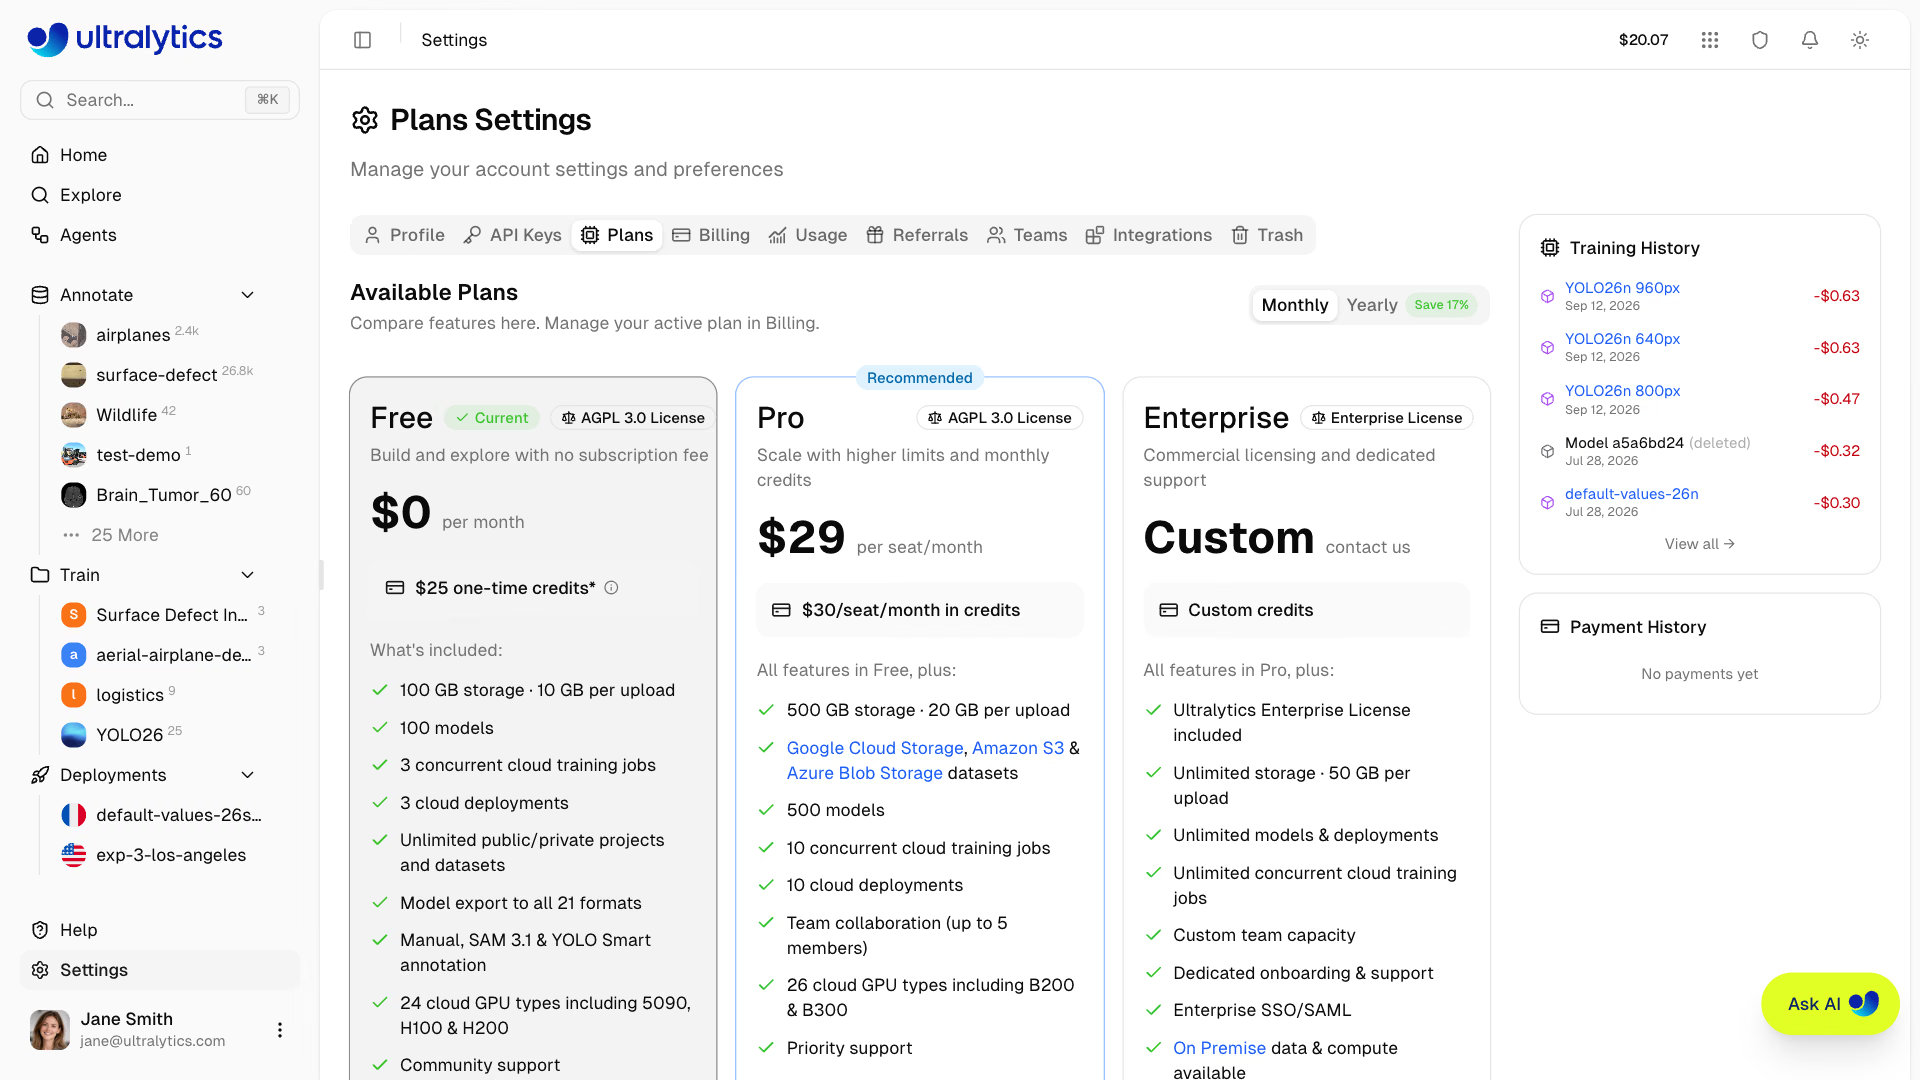
| Gratis | Pro (29 $/usuario/mes) | Enterprise | |
|---|---|---|---|
| Créditos | 5 $ al registrarte, 25 $ con un correo electrónico de empresa verificado | 30 $/usuario/mes, sin acumulación | Personalizado |
| Almacenamiento / carga individual | 100 GB / 10 GB | 500 GB / 20 GB | Ilimitado / 50 GB |
| Modelos / entrenamientos simultáneos | 100 / 3 | 500 / 10 | Ilimitados |
| Implementaciones dedicadas | 3 | 10 | Ilimitados |
| Tipos de GPU en la nube | 24 | 26 (incluye B200 y B300) | 26 |
| Conjuntos de datos en almacenamiento en la nube, equipos | — | Sí, hasta 5 miembros | Sí, tamaño personalizado |
| En local, inicio de sesión único, licencia Enterprise | — | — | Sí |
Regla para decidir: sigue con Free mientras aprendes; pásate a Pro cuando necesites almacenamiento en la nube conectado, un equipo, más de tres puntos de conexión o más de tres entrenamientos simultáneos. El crédito mensual de 30 $ de Pro cubre las partidas de entrenamiento y etiquetado del presupuesto anterior. En la documentación de facturación se indican todas las tarifas.
Errores habituales#
Síntoma: aparece en Explore un conjunto de datos con imágenes de clientes y personas desconocidas pueden clonarlo. Solución: en los planes Free y Pro, los conjuntos de datos y proyectos nuevos son Public de forma predeterminada. Cambia el ajuste de visibilidad en los cuadros de diálogo New Dataset y New Project cada vez; hacer privado un conjunto de datos más tarde no elimina los clones que ya existen.
Síntoma: un cliente de la UE pide que los datos residan en la UE, pero tu espacio de trabajo almacena los datos en EE. UU. Solución: la región de datos (US, EU o AP) se elige al registrarse y solo el equipo de asistencia puede cambiarla. Decide la región basándote en tus contratos antes de registrarte (lección 9).
Síntoma: los créditos disminuyen unos 5 $ al día sin tráfico. Solución: los tamaños personalizados se facturan por el tiempo de actividad, estén inactivos o no. Detén los endpoints que no uses o vuelve al tamaño predeterminado, que puede escalar a cero sin coste.
Mostrar solución
Plan de ejemplo para una cámara de inspección de pastillas en una línea de producción. Datos: carga nocturna de volcados de fotogramas en Platform (responsable: Ana). Anotación: anotación por lotes con el ajuste fino más reciente y, después, revisión (Ana). Selección, entrenamiento y comparación: Platform (Ravi). Implementación: un punto de conexión de tamaño predeterminado en europe-west1, porque el PLC de la línea lo llama cada 30 segundos, por lo que rara vez permanece inactivo el tiempo suficiente para escalar a cero (Ravi). Supervisión: paneles de Platform, además de una comprobación de estado con cron y una tarea semanal con el conjunto de validación en el CI del equipo (guardia). Presupuesto: 10 ejecuciones × 0,23 $ + 2.000 imágenes × 0,001 $ = unos 4,30 $ al mes en un punto de conexión gratuito, cubiertos por el crédito de 30 $ de Pro. Región de datos: UE, porque la planta está en Alemania; todos los conjuntos de datos son privados.