Primer ajuste fino y ciclo de iteración
Ajusta pesos de YOLO26 preentrenados con la configuración predeterminada, ordena las clases por AP según los recuentos de errores por omisión y confusión, y convierte la clase más débil en la siguiente corrección del conjunto de datos.
La ejecución de práctica de esta lección obtiene un mAP50 de 0,66, lo que parece indicar un problema con la tasa de aprendizaje. Sin embargo, una tabla por clase cuenta otra historia: cup tiene 14 objetos etiquetados en val y el modelo no encuentra ninguno. Es un problema de datos, y ningún hiperparámetro lo habría solucionado. Considera la primera ejecución como un diagnóstico que te indica qué clase corregir a continuación.
Práctico
Empieza con pesos preentrenados#
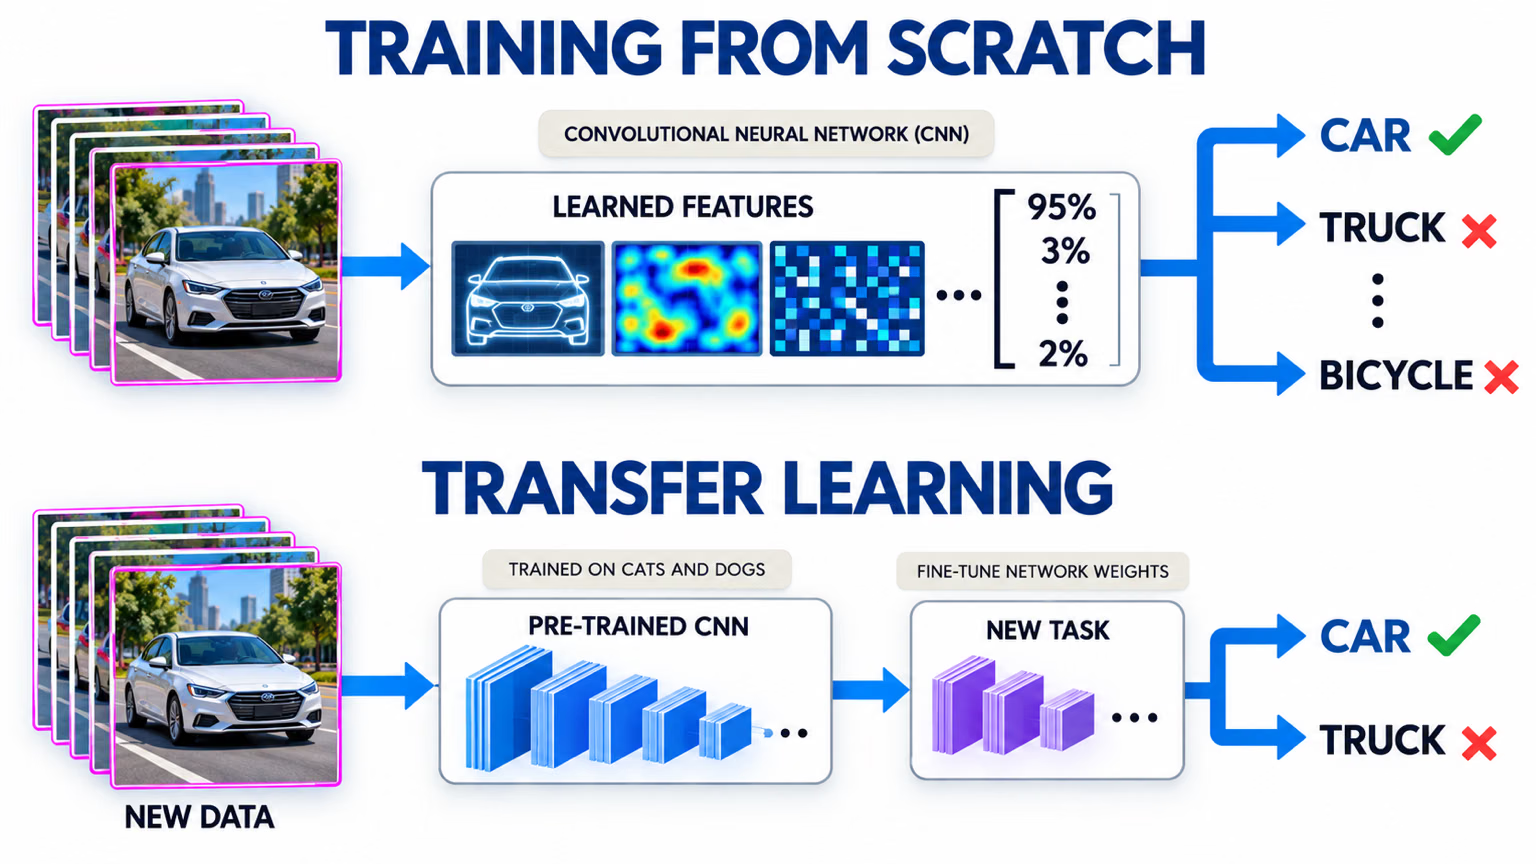
El ajuste fino parte de pesos que ya reconocen bordes, texturas y formas, por lo que converge más rápido y necesita muchos menos datos que el entrenamiento con pesos aleatorios. Elige el punto de control de YOLO26 que corresponda a tu tarea:
| Tarea | Punto de control preentrenado | Preentrenado con |
|---|---|---|
| Detección | yolo26n.pt | COCO |
| Segmentación | yolo26n-seg.pt | COCO |
| Semántica | yolo26n-sem.pt | Cityscapes |
| Pose | yolo26n-pose.pt | Puntos clave de COCO |
| OBB | yolo26n-obb.pt | DOTAv1 |
| Clasificación | yolo26n-cls.pt | ImageNet |
| Profundidad | yolo26n-depth.pt | Una amplia combinación de datos de profundidad en interiores y exteriores |
El backbone y el neck se transfieren tal cual; la cabeza de la tarea se reinicializa parcialmente para adaptarse al número de clases. Entrenar desde cero solo compensa con conjuntos de datos muy grandes en dominios muy poco habituales. Empieza con el modelo nano (n) para obtener rápidamente un resultado de referencia y pasa a tamaños mayores solo cuando el ciclo de mejora de los datos deje de dar frutos. La guía de ajuste fino explica qué ocurre internamente.
Ejecuta el modelo de referencia#
Entrena con la configuración predeterminada; el objetivo de la primera ejecución es obtener una referencia, no batir un récord. Esto entrena con la división del conjunto de práctica de Divide correctamente el conjunto de datos, escribiendo primero su YAML de datos:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # el conjunto de práctica conserva los nombres de clase de COCO
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # preentrenado con COCO; usa el punto de control de tu tarea
model.train(data="practice.yaml", epochs=3, imgsz=320)  # una ejecución real: epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486La carpeta de ejecución (runs/detect/train/) ahora contiene weights/best.pt. En la primera ejecución solo vale la pena plantearse tres argumentos:
| Parámetro | Predeterminado | Cuándo cambiarlo |
|---|---|---|
epochs | 100 | Menos para conjuntos de datos pequeños; 200–300 para conjuntos muy grandes |
imgsz | 640 | 1024 o 1280 si hay muchos objetos pequeños en el fotograma |
batch | 16 | -1 para el ajuste automático del tamaño del lote; bájalo si se producen errores de falta de memoria |
Entrena tu primer modelo explica en detalle la llamada de entrenamiento y su registro en tiempo real.
Ordena las clases y analiza los errores por omisión#
El mAP global oculta dónde está el problema. Ordena las clases por AP50-95 y usa la matriz de confusión para separar los errores de cada clase entre los objetos que el modelo ha omitido por completo y los que ha clasificado como otra clase:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classCada tipo de error apunta a una corrección distinta del conjunto de datos:
- Muy pocas instancias en val (
fork,handbag,sink, con 1 cada una): el AP es ruido. No actúes sobre una clase hasta que val tenga al menos unas cuantas decenas de instancias suyas; primero recopila más grupos para val. - Omitidos (
car: 4 de 4;cup: 10 de 14): el modelo no detecta ningún objeto. Comprueba la cobertura de ese escenario en train y busca etiquetas que falten consuspect_labels.py. - Clasificados como otra clase (
cup: 4 de 14): las definiciones de clase se solapan. Abre esas imágenes, precisa las definiciones e identifica en la guía el elemento parecido.
cup es el hallazgo que requiere actuar: 14 instancias etiquetadas y ninguna detectada.
Interpreta la carpeta de ejecución como información sobre los datos#

Cada ejecución de entrenamiento escribe estos archivos, y Ultralytics Platform muestra en tiempo real las mismas curvas durante el entrenamiento en la nube:
| Archivo | Qué te indica sobre los datos |
|---|---|
confusion_matrix_normalized.png | Qué clases se confunden entre sí o se omiten como si fueran fondo |
BoxPR_curve.png | Precisión y exhaustividad por clase; una curva baja señala una clase débil |
val_batch0_pred.jpg | Predicciones sobre imágenes reales de val; busca errores sistemáticos por omisión |
labels.jpg | Recuentos de clases y tamaños de cajas con los que se entrenó el modelo |
results.png | Curvas de pérdida y métricas; si la pérdida de val sube mientras baja la de train, es señal de sobreajuste |
Valida y diagnostica explica cada gráfico; aquí, la pregunta siempre es qué falta en los datos.
El ciclo de trabajo centrado en los datos#
Una iteración típica: elige la clase más débil que tenga suficientes instancias en val, audita unas 50 imágenes que la contengan, corrige los datos, vuelve a entrenar con la misma configuración y división, y compara el AP por clase. Después, pasa a la siguiente clase más débil.
Si añades 300 imágenes y aumentas imgsz en el mismo reentrenamiento, no podrás saber qué cambio modificó la puntuación. Mantén idénticos los ajustes y la división mientras iteras con los datos, para que cada comparación aísle un solo cambio en los datos.
Cuándo recurrir a los hiperparámetros#
Tras dos o tres iteraciones con los datos, cuando las clases débiles restantes ya no se deban a la cobertura, las etiquetas o las definiciones, el ajuste puede aportar los últimos puntos. La guía de ajuste fino explica la congelación de capas, las tasas de aprendizaje y la elección del optimizador. Pero si ajustas los parámetros antes de tener los datos bien, pasarás semanas optimizando un modelo para un conjunto de datos equivocado.
Cuando un modelo supere acceptance_test.py en el conjunto de prueba bloqueado, YOLO de Ultralytics en producción aborda la exportación y el servicio, y Supervisa el estado y la precisión y Automatiza el ciclo de reentrenamiento, en Desarrolla con Ultralytics Platform, abordan el ciclo de reentrenamiento.
Mostrar solución
En la prueba, cup es la clase en la que hay que actuar: 14 etiquetadas en validación, 0 detectadas, 10 omitidas y 4 clasificadas como otra clase. Un plan con cantidades:
| Hallazgo | Acción sobre el conjunto de datos | Cantidad |
|---|---|---|
| 10 de 14 tazas omitidas | Comprueba la cobertura de entrenamiento: cuenta las imágenes de entrenamiento con tazas por cámara y día; recopila imágenes de tazas en los grupos que no tengan ninguna | 40 imágenes nuevas con tazas, repartidas en 4 días de cámara |
| 4 de 14 clasificadas como otra clase | Ábrelas en val_batch0_pred.jpg y en la matriz de confusión; si están clasificadas como wine glass o bowl, añade ambas clases parecidas a la definición de cup | Vuelve a etiquetar unas 30 imágenes de entrenamiento según la nueva regla |
| Clases con 1 instancia | No actúes todavía; añade grupos de validación que las contengan | Siguiente ronda de recopilación |
Después, vuelve a entrenar con epochs, imgsz y la misma división, vuelve a ejecutar rank_classes.py y compara el AP de cup antes y después. Si aumenta, el cuello de botella eran los datos; si no, audita las 50 imágenes siguientes antes de tocar ningún hiperparámetro.