Calidad de las anotaciones
Descubre qué contiene una etiqueta YOLO, comprueba los archivos de etiquetas para detectar filas incorrectas y mantén la coherencia entre anotadores con una guía y una ronda de calibración cuantificada.
Un modelo entrenado con etiquetas incoherentes aprende esa incoherencia. Cincuenta mil recuadros dibujados con una regla clara superan a medio millón dibujados según veinte interpretaciones particulares, y volver a etiquetar casi siempre cuesta menos que usar un modelo más grande. En esta lección tendrás un validador de etiquetas, una guía de una página y una medida del acuerdo entre anotadores.
Práctico
Qué es realmente una etiqueta#
En el formato YOLO, cada imagen tiene un archivo .txt correspondiente, con una fila por objeto. Las coordenadas se normalizan de 0 a 1 según la anchura y la altura de la imagen, por lo que las etiquetas se conservan al cambiar el tamaño. La estructura de la fila depende de la tarea:
| Tarea | Una etiqueta | Notas |
|---|---|---|
| Detección | class x_center y_center width height | Centro y tamaño del recuadro |
| Segmentación de instancias | class x1 y1 x2 y2 ... xn yn | Contorno del polígono |
| Pose | class x y w h px1 py1 v1 ... pxn pyn vn | Recuadro y, a continuación, puntos clave con visibilidad opcional |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Cuatro esquinas del recuadro girado |
| Clasificación | Sin archivo de etiquetas | Imágenes clasificadas en una carpeta por clase |
| Segmentación semántica | Una máscara PNG por imagen | Cada valor de píxel es un índice de clase |
| Estimación de profundidad | Un PNG o NPY de profundidad por imagen | Cada valor de píxel es una distancia |
Los índices de clase empiezan en 0 y se corresponden con los nombres del YAML del conjunto de datos. Una imagen sin objetos no necesita archivo de etiquetas: así funcionan las imágenes de fondo. Las páginas de conjuntos de datos sobre el formato de detección, la segmentación semántica y la profundidad incluyen ejemplos prácticos.
Comprueba tus archivos de etiquetas#
Las filas incorrectas pueden fallar sin avisar: una coordenada superior a 1, un ID de clase que el YAML no define o el mismo objeto encerrado en dos recuadros se convierten en ruido que el modelo intenta aprender. Un validador breve los detecta antes del entrenamiento:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesLa muestra creada a mano muestra cada error que detecta el validador; el conjunto de datos real no presenta errores. Ejecútalo después de cada lote de etiquetado y antes de cada entrenamiento: solo tarda unos segundos.
Por qué varían las etiquetas#
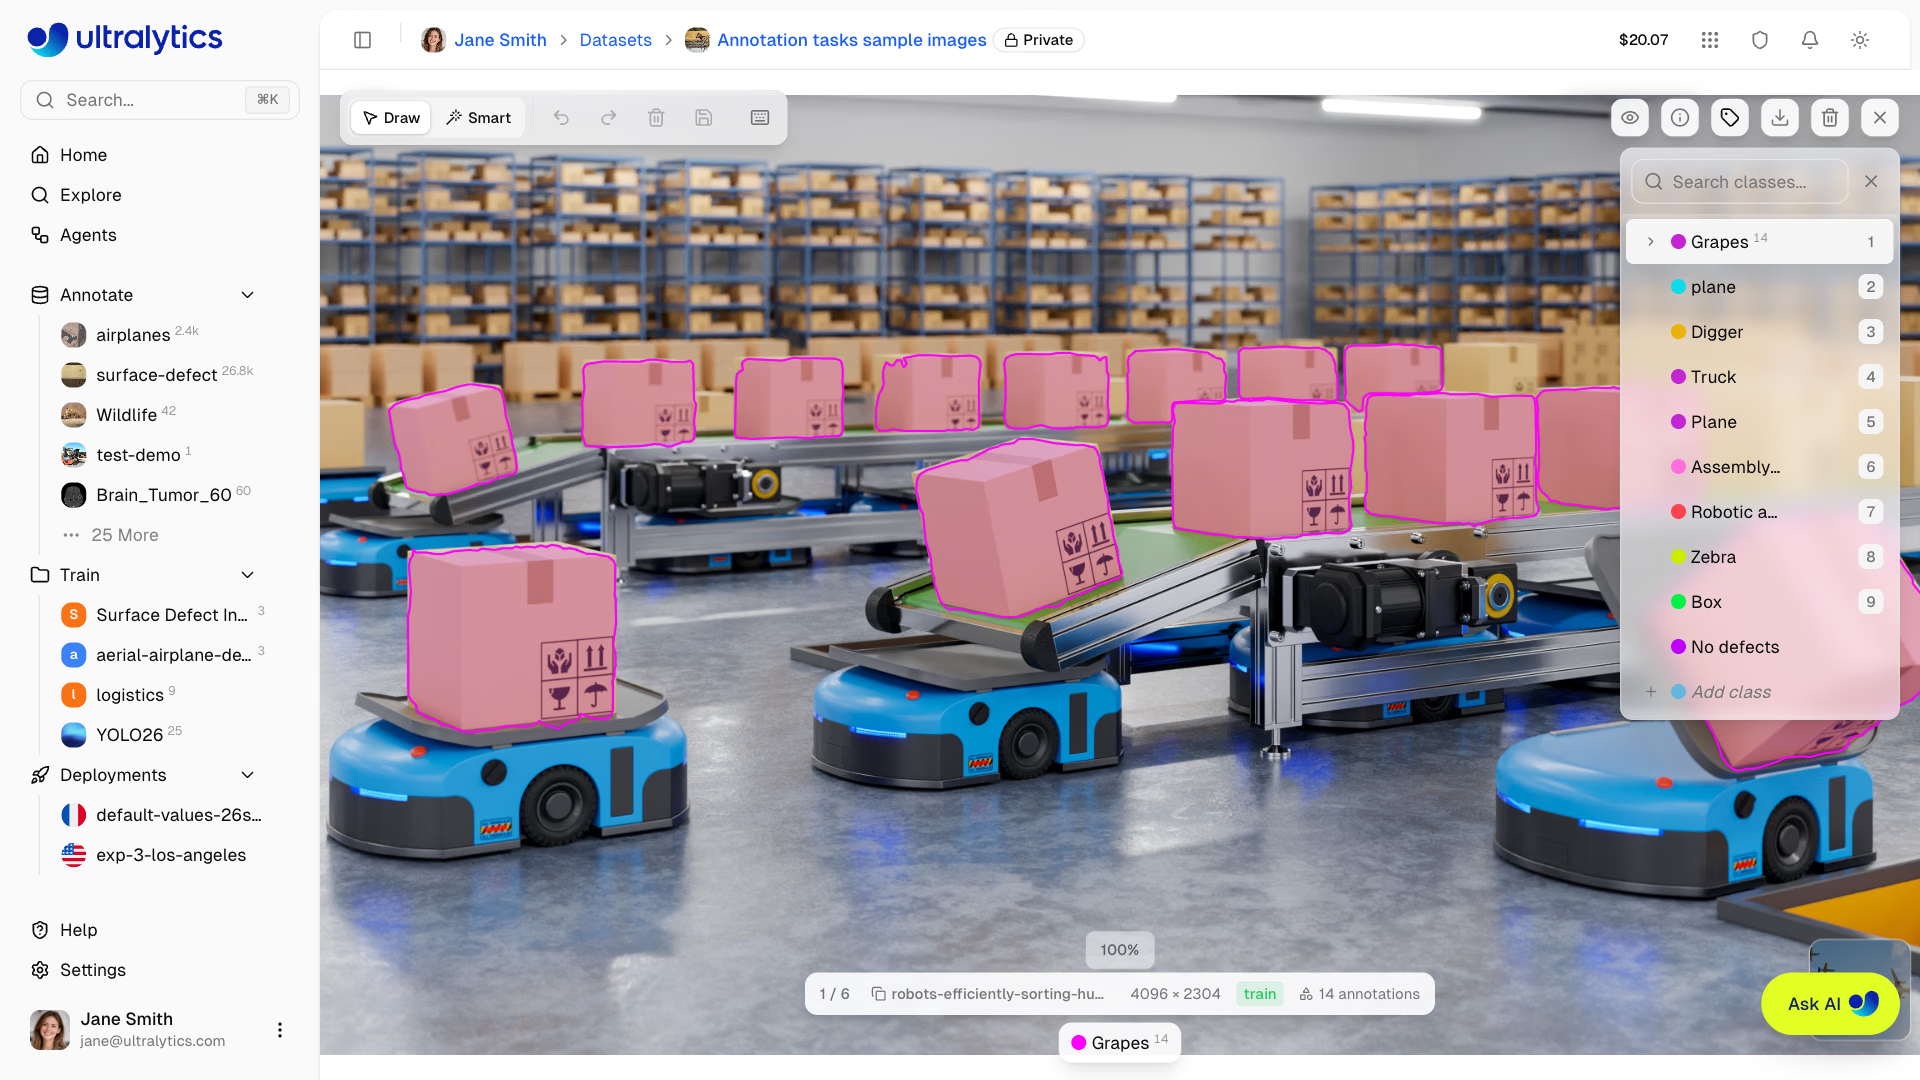
Fíjate en el panel de clases de este editor: los 14 polígonos de cajas de cartón están guardados en Grapes, mientras que más abajo en la lista aparece una clase Box; además, plane y Plane existen como dos clases distintas. Un validador no puede detectar ninguno de los dos problemas, porque todas las filas son válidas, pero un revisor que compruebe las etiquetas según la guía detectaría ambos en segundos. La mayoría de los errores de etiquetado son así: archivos válidos, decisiones equivocadas.
Rara vez los anotadores etiquetan mal por descuido. Etiquetan de forma incoherente porque las reglas son ambiguas y cada persona hace una suposición razonable, pero distinta:
- ¿Dónde termina el recuadro? ¿En la sombra, en una bolsa transportada o en la carga de las horquillas de una carretilla elevadora?
- Truncamiento. Si una persona está medio fuera del encuadre, ¿sigue siendo un
person? ¿A partir de qué fracción visible? - Oclusión. Si un coche solo es visible por una rueda, ¿se etiqueta o se omite?
- Límites entre clases. ¿Una camioneta es un
caro untruck? ¿Un patinete es unbicycleo unother? - Casos que no se deben etiquetar. Reflejos, carteles y pantallas que muestran el objeto.
Cada opción es válida siempre que todos elijan la misma.
Una guía de una página#
Cabe en una página, incluye una imagen de ejemplo para cada regla y presenta primero los casos límite:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Mide el acuerdo en una ronda de calibración#
Antes de pasar de un anotador a veinte, todos etiquetan las mismas 50 imágenes y comparas los resultados:
El acuerdo es la proporción de objetos que ambos anotadores dibujaron con la misma clase y un IoU de al menos 0.5: la versión práctica de la fiabilidad entre evaluadores:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%En ese 67 % se esconden dos tipos de desacuerdo. El recuadro de la carretilla elevadora de Bob empieza 80 píxeles más arriba —incluyó la punta del mástil—, pero aun así coincide con un IoU de 0.83, así que cuenta como acuerdo; concreta la regla del recuadro si tu producto mide la altura. El tercer objeto es un conflicto real: Alice dice person y Bob dice pallet_jack. Hace falta una regla más clara y una imagen de ejemplo, y después otra ronda. Conserva las 50 imágenes de calibración: se convertirán en la prueba de incorporación de cada nuevo anotador.
Un revisor que corrige las etiquetas discretamente elimina el ciclo de retroalimentación, y los anotadores nunca aprenden qué han hecho mal. Rechaza la etiqueta indicando el motivo y deja que el anotador la corrija. Será más lento con las primeras cien imágenes, pero mucho más rápido después.
Qué debes medir#
| Métrica | Qué te indica |
|---|---|
| Ritmo de trabajo (objetos por hora) | Capacidad y coste |
| Tasa de rechazo | Si la calidad está empeorando |
| Acuerdo en un conjunto común de imágenes superpuestas | Si los anotadores siguen aplicando las mismas reglas |
Cuando baja el acuerdo, algo ha cambiado: un nuevo anotador, una cámara nueva, un lote ambiguo o el cansancio. Si más adelante el modelo falla en una condición concreta, vuelve a etiquetar esas imágenes exactas: es el ciclo que automatiza el aprendizaje activo y la fuente de la mayoría de las mejoras de precisión en el mundo real. Examina y filtra los errores en tus conjuntos de datos en Ultralytics Platform y consulta Control de calidad de conjuntos de datos y Buenas prácticas de anotación para aplicar este proceso a gran escala.
Mostrar solución
Una guía para la clase pill de medical-pills, redactada tras una ronda de calibración con 10 imágenes:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
Cómo interpretar la puntuación de acuerdo: supongamos que la primera ronda obtiene un 82 %. Ordena los objetos sin correspondencia por causa. En los blísteres, los dos casos más habituales son los recuadros dibujados alrededor de la burbuja de plástico en vez de la pastilla (se corrige con la primera regla sobre recuadros y una imagen de ejemplo) y las pastillas tapadas por reflejos que un anotador omitió (se corrige con la segunda regla de inclusión). Repite la prueba con 10 imágenes nuevas; amplía el trabajo solo cuando la puntuación supere el umbral del 90 %.