Anlamsal Segmentasyon: Her Piksele Etiket Ver
yolo26n-sem.pt ile piksel başına bir sınıf haritası tahmin et, bunu kapsama değerlerine dönüştür, PNG sınıf haritası veri kümeleri oluştur ve piksel doğruluğuna aldanmadan mIoU değerini yorumla.
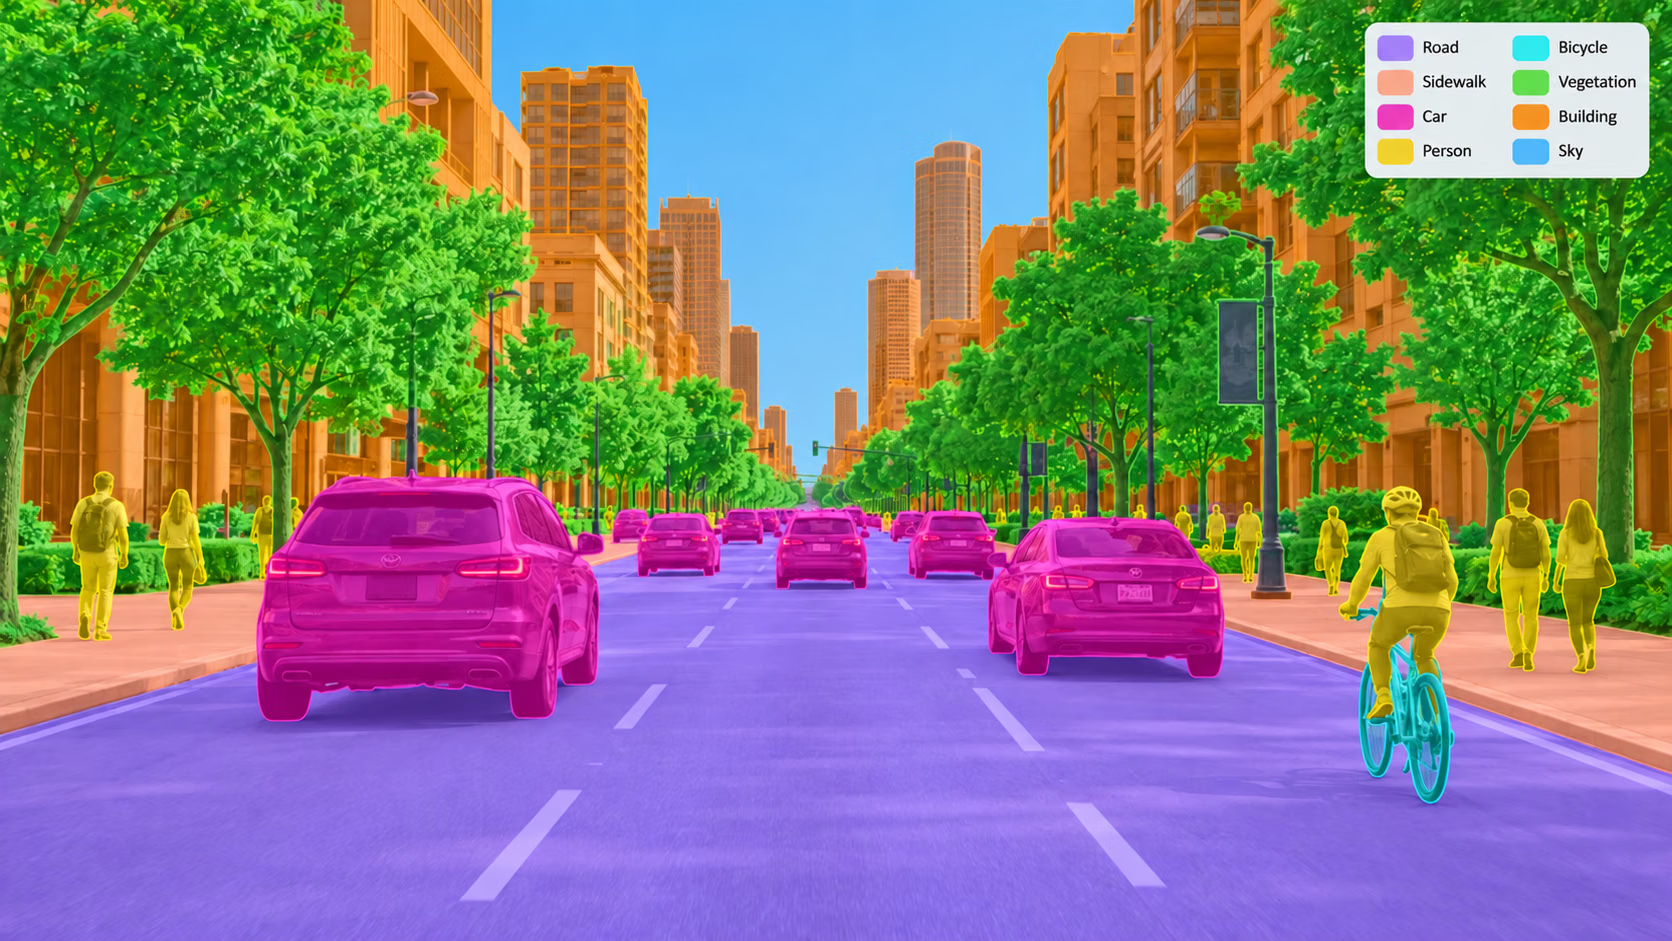
Bazı soruların sayılacak nesneleri yoktur: kaldırımın ne kadarı kapalı, bir tarlanın ne kadarı yabani otlarla kaplı, araçla gidilebilir yol nerede bitiyor? Anlamsal segmentasyon, her piksele bir sınıf kimliği atayarak bu soruları yanıtlar. Ancak öne çıkan metriği yanlış yorumlamak kolaydır: bu derste eğittiğin model, tek bir kişi bile bulamazken %91 piksel doğruluğu elde ediyor.
Uygulamalı
Örnek mi, anlamsal mı?#
Örnek segmentasyonu (segment) | Anlamsal segmentasyon (semantic) | |
|---|---|---|
| Çıktı | her nesne için bir maske ve bir kutu | her piksel için bir sınıf kimliği |
| Nesneleri sayar | evet | hayır — birbirine değen iki araba tek bir “araba” bölgesidir |
| “Şeyleri” (yol, gökyüzü, çimen) ele alır | zayıf — doğal örnekler yok | evet |
| Etiketler | çokgenler | PNG sınıf haritaları veya çokgenler |
| Eşik metriği | maske mAP50-95 | mIoU |
| Önceden eğitilmiş ağırlıklar | yolo26n-seg.pt (COCO, 80 sınıf) | yolo26n-sem.pt (Cityscapes, 19 sınıf) |
Sonraki aşamadaki soru "kaç tane" ise örnek segmentasyonu kullan. Soru "ne kadar" veya "nerede" ise semantik segmentasyonun etiketlenmesi ve okunması daha kolaydır. Model tablosu için Semantik Segmentasyon görev sayfasına bak.
Bir sınıf haritası tahmin et#
result.semantic_mask.data, özgün görüntü boyutlarında bir H × W tensörüdür; her değer bir sınıf kimliğidir ve 255 yoksay anlamına gelir. result.summary() bunu sınıf başına piksel oranlarına dönüştürür:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Son satıra bak. Cityscapes'te bir bus sınıfı var, ancak model otobüsü train olarak adlandırıyor. Model, çoğunlukla Alman sokaklarının araçlara monte edilmiş kameralardan çekilmiş görüntüleriyle öğrenmiş; kaldırımdan yakından fotoğraflanan bir otobüs bu dağılımın dışında kalıyor. Anlamsal modeller, eğitim kümelerinin bakış açısını ve sınıf tanımlarını — yani veri kümesi yanlılığını — dedektörlere kıyasla daha katı biçimde devralır. Bu nedenle haritaya güvenmeden önce kendi kamerandan gelen verilerle ince ayar yap.
Sınıf haritasını bir yanıta dönüştür#
Sınıf haritası, basit tensör karşılaştırmalarıyla bir ürün metriğine dönüşür. İşte “bir yayanın üzerine yürüyeceği alanın ne kadarı yol veya kaldırım, ne kadarı insan?” sorusunun yanıtı:
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personBu sayıların güvenilir olması için üç alışkanlık edin:
- Kimlikleri ada göre bul:
result.namesiçinden al; sabit kodlanmış sayıları asla kullanma. Kendi sınıflarınla eğitilmiş bir model, sınıfları farklı numaralandırır. - Önemli bölgeyle sınırla. Tüm kareye ait oranlar gökyüzünü ve binaları da içerir; önce sınıf haritasını dilimle (veya bir bölge maskesiyle çarp).
- Bindirmeyi aç.
semantic_overlay.jpg, sayının “yol” olarak saydığı bölgenin gerçekten yol olup olmadığını tek bakışta gösterir.
Veri kümesi biçimi#
Anlamsal veri kümelerinde her görüntü, piksel değerlerinin sınıf kimlikleri olduğu tek kanallı bir maske görüntüsüyle eşleştirilir. Anlamsal veri kümesi kılavuzu başvuru kaynağıdır; dizin yapısı images/ ile dosya dosya aynıdır:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
YAML dosyasında masks_dir bulunur; maskelerinde saklanan kimlikler eğitim kimliklerinden farklıysa ayrıca bir label_mapping bloğu eklenir:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Cityscapes maskeleri -1 ile 33 arasındaki ham etiket kimliklerini saklar; eşleme bunlardan 19'unu tutar ve geri kalanları 255 olarak saklanan ignore_label değerine yönlendirir. 255 olarak ayarlanmış pikseller hem kayıp hem de metrik hesaplamalarından çıkarılır; etiketleyicilerin karar veremediği bölgeler için de aynı değeri kullan.
Poligon etiketlerin varsa ancak masks_dir yoksa, yükleyici poligonları senin için rasterleştirir ve kaplanmamış piksellere background sınıfını ekler.
Kayıplı sıkıştırma, komşu piksel değerlerini birbirine karıştırır; 7. sınıf ile 8. sınıf arasındaki sınırı 7'ler, 8'ler ve mevcut olmayan kimliklerden oluşan bir bulanıklığa dönüştürür. Her maskeyi PNG veya TIFF olarak kaydet.
mIoU değerini eğit ve yorumla#
Cityscapes8, 4'ü eğitim ve 4'ü doğrulama için kullanılan 8 şehir sahnesi görüntüsü içerir; CPU üzerinde hızlı bir test yapmak için yeterlidir:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Sınıf başına satırlar kısaltıldı.) Piksel doğruluğu %91 gösteriyor; mIoU %42; sınıf başına satırlar ise modelin tek bir kişi bile bulamadığını gösteriyor. Üçü de doğru. Piksellerin çoğu yol, bina ve bitki örtüsüne aittir — yalnızca yol 192,315 pikselin 78,529'unu oluşturur — dolayısıyla bu bölgeleri iyi boyayan bir model, tüm küçük sınıfları kaçırırken yüksek piksel doğruluğu elde eder. mIoU, sınıf başına IoU değerlerinin eşit ağırlıklı ortalamasını alır; bu nedenle kaçırılan her sınıf mIoU değerini düşürür.

mIoU ve ürününün işlem yaptığı sınıfların IoU değeri için eşik belirle. Kişi IoU değeri 0 olan bir yaya güvenliği özelliği başarısızdır; piksel doğruluğu ne gösterirse göstersin.
Çözümü göster
Çalıştırmamızda: mIoU 0.415, piksel doğruluğu 0.906; duvar, kişi, binici, motosiklet ve bisiklet için IoU 0. Ayrıca dört doğrulama görüntüsünde hiç pikseli bulunmayan tüm sınıfların IoU değeri de 0.
Piksel doğruluğu daha yüksektir çünkü pikselleri sayar ve her Cityscapes karesinin büyük kısmını yol, bina, bitki örtüsü ve gökyüzü oluşturur. mIoU her sınıfa eşit ağırlık verir; bu nedenle kaçırılan beş küçük sınıf yalnızca birkaç yüz piksel kaplasa da ortalamayı düşürür. İnsanlar üzerinde işlem yapan bir ürün için bu model, yalnızca kişi IoU değerinden dolayı onay eşiğini geçemez.