Bir Görüntü Sınıflandırıcısı Eğit
Klasör tabanlı bir veri kümesi düzenle, MNIST160 üzerinde yolo26n-cls.pt modelini eğit, olasılıkları ve top-1 doğruluğunu oku, düşük güvenli tahminleri insan incelemesine yönlendir.
Görüntü sınıflandırma, her görüntü için tek bir soruyu yanıtlar: Bu nedir? Her görev arasında en ucuz etiketleri kullanır — klasör adı — ve en hızlı şekilde çalışır. Bu özellikleriyle dedektörlerden sonra varsayılan ikinci aşama ve her karede tek bir parça gören bir inceleme istasyonu için doğru ilk modeldir. Veri kümesinde YAML bulunmaz; klasör yapısı sözleşmedir ve sınıflandırıcı, daha önce hiç benzerini görmediği görüntüler için bile her zaman bir yanıt verir. Ona ne zaman güvenmemen gerektiğine karar vermek işin yarısıdır.
Uygulamalı
Klasör tabanlı veri kümesi düzeni#
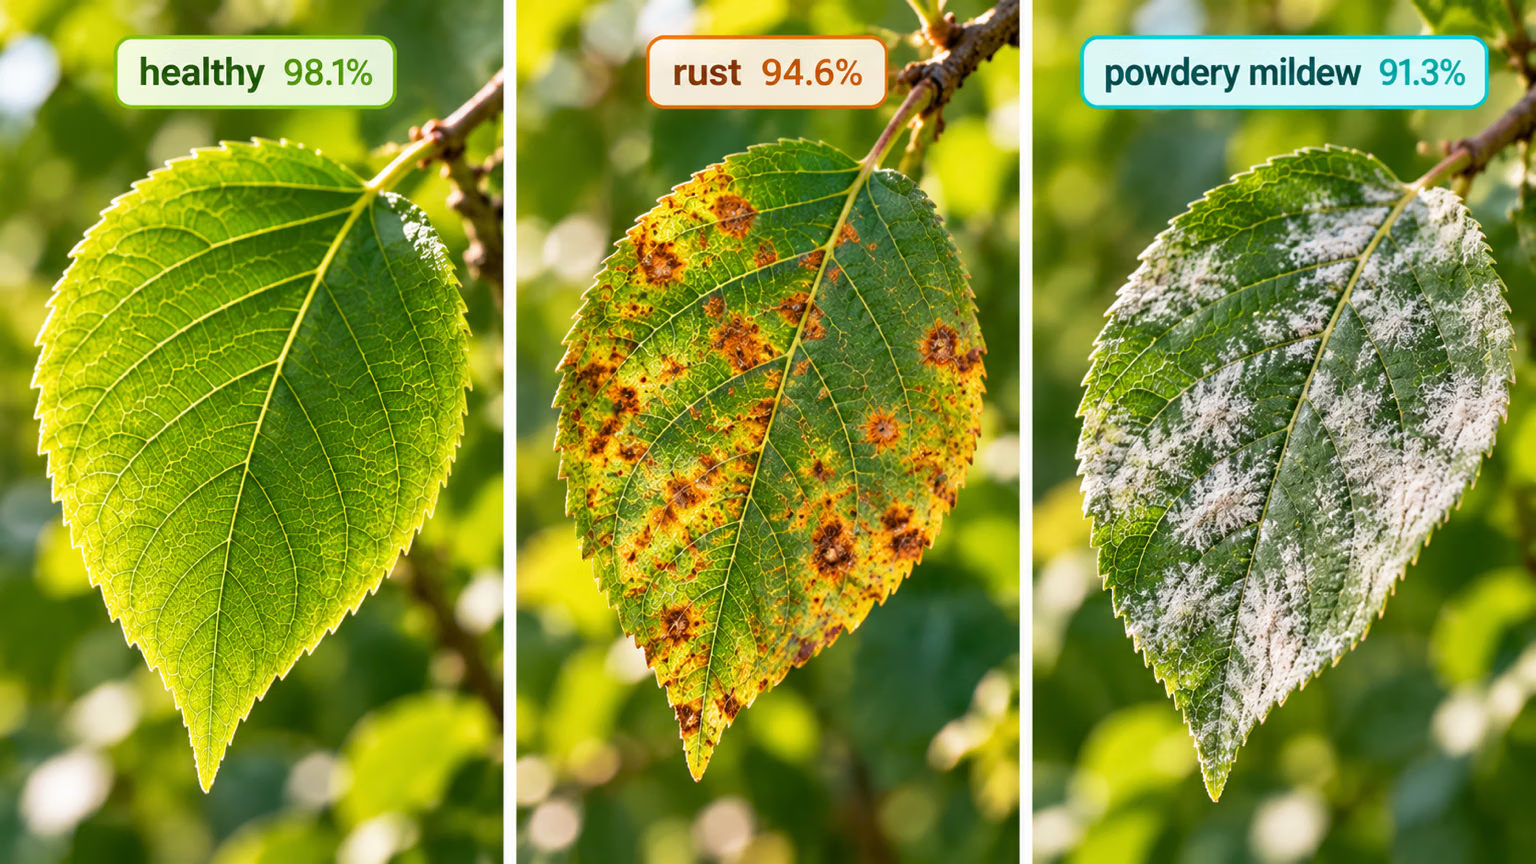
Sınıflandırma veri kümeleri YAML dosyaları değil, dizinlerdir. data= değerini kök klasöre ayarla:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Kurulu kaynak koduna ve sınıflandırma veri kümesi kılavuzuna göre yükleyicinin yaptıkları:
| Durum | Davranış |
|---|---|
| Sınıf indeksleri | train/ altındaki klasör adları, alfabetik sıralanır → dent=0, good=1, scratch=2 |
| Doğrulama klasörü | Önce val/, sonra validation/, ardından valid/; bir uyarıyla test/ değerine geri döner |
train/ klasörü yok, yalnızca sınıf klasörleri var | Otomatik olarak train/ ve val/ klasörlerine 80/20 oranında böler |
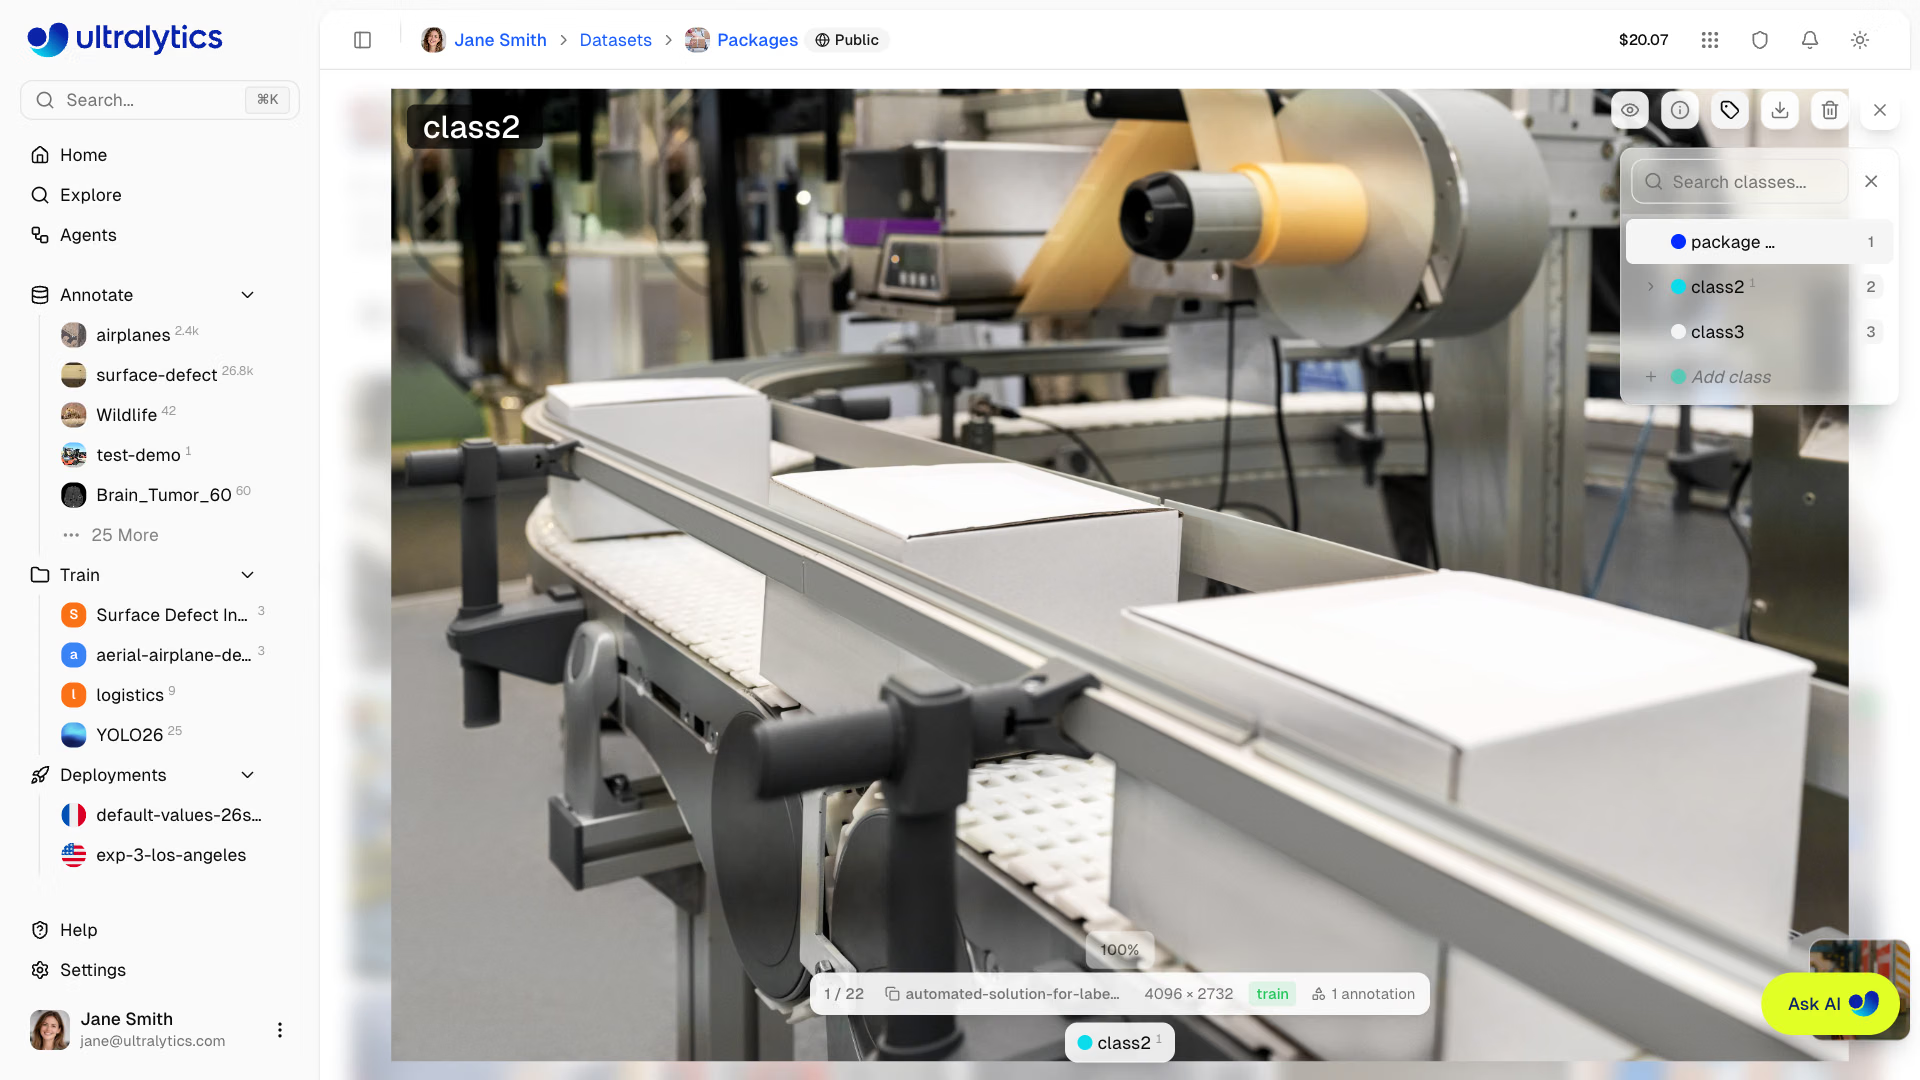
Ultralytics Platform'da sınıflandırma veri kümesi, şekiller yerine her görüntü için tek bir görüntü düzeyi etiketi içerir:
Belirti: Bir sınıf ekledikten sonra eski bir entegrasyon, good parçalarını dent olarak bildiriyor. Neden: bent adlı bir klasör eklemek, bu klasörün sıralamada ilk sıraya geçmesine ve sonraki tüm indekslerin kaymasına neden olur. Çözüm: İndeksleri adlarla eşlemek için her zaman model.names (veya result.names) kullan; indeksleri asla sabit kodlama.
MNIST160 üzerinde eğit#
MNIST160, her biri on rakam klasörüne ayrılmış train/ içinde 80 ve test/ içinde 80 olmak üzere, elle yazılmış 160 rakamdan oluşur — CPU üzerinde hızlı kontrol için yeterince küçüktür. val/ klasörü yoktur; bu nedenle yükleyicinin uyarı verip test/ değerine geri dönmesini izle:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Bir epoch, yeni on sınıflı başlığı çok az ilerletir. Çalıştırmamızda epochs=10, bir dizüstü bilgisayarın CPU'sunda yaklaşık on saniyede top-1 0.55'e ve top-5 0.95'e ulaştı — döngü çalışıyor, yalnızca daha uzun bir eğitim planı gerekiyor. Sınıflandırma görevi kılavuzu, önceden eğitilmiş boyutları listeliyor.
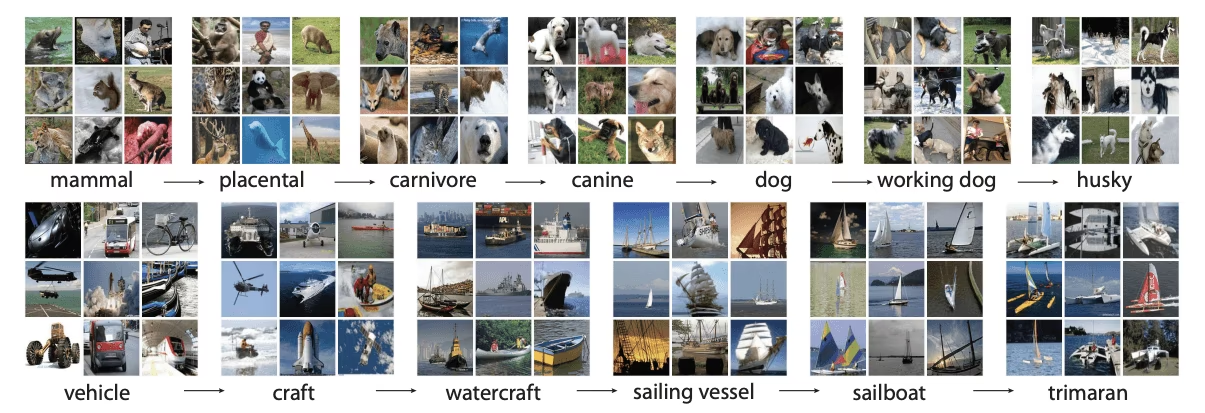
Top-1, en yüksek olasılığa sahip sınıfı doğru olan görüntülerin oranıdır. Top-5, doğru sınıf en yüksek beş sınıf arasında yer alıyorsa başarılı sayar. Top-5, sınıfları geniş kategorilerden çok ince ayrıntılı kategorilere uzanan 1.000 sınıflı ImageNet için bilgilendiricidir; beş veya daha az sınıfta her zaman 1.0'dır, on sınıfta ise cömert bir ölçüttür. Top-1 doğruluğunu ve sınıf başına karışıklık matrisini temel al.
Kodda olasılıkları oku#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 bir indekstir, probs.top5 indeksler listesidir ve probs.data tam olasılık vektörüdür. Top-1 güven değerine dikkat et: 0.52, minibus ile police_van arasında yazı tura atmaya ancak üstün geliyor. Yönlendirme yaparken kullanacağın değer budur.
Belirsiz tahminleri bir kişiye yönlendir#
Üretimdeki bir sınıflandırıcının her görüntüde doğru olması nadiren gerekir; tek başına karar verdiği görüntülerde doğru olması gerekir. Bu betik 10 epoch'luk modeli eğitir, ardından farklı güven eşiklerinin doğrulamada ayrılmış 80 rakam üzerindeki etkisini ölçer:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Her satır bir ödünleşimdir: eşiği yükseltmek kabul edilen tahminleri daha doğru hâle getirir ve daha fazla görüntüyü bir kişiye gönderir. 0.6'da bu model 80 rakamdan yalnızca 10'u için tek başına karar verir — hiçbir şeyi otomatikleştirmeye hazır değil ve çözüm daha akıllı bir eşik değil, daha fazla eğitimdir. Her eğitim turundan sonra aynı tabloyu yeniden oluştur: tablo hem elde edeceğin doğruluğu hem de her eşiğin ne kadar inceleme işi yaratacağını gösterir.
Kabul edilen görüntülerdeki doğruluğu, ayrılmış veriler üzerinde ölçerek gereksinimini karşılayan en düşük eşiği seç. Ardından oluşturduğu inceleme hacminin ekibinin yönetebileceği düzeyde olduğunu kontrol et; değilse modeli iyileştir.
Yaygın Hatalar#
Belirti: Boş bir istasyon, yanlış bir parça veya lensin önündeki bir el, yüksek güvenli bir sınıf etiketi alıyor. Neden: softmax olasılıklarının toplamı her zaman 1 olur, bu nedenle sınıflandırıcı her zaman sınıflarından birini seçer. Çözüm: Yalnızca bu görüntülerle dolu bir other/ klasörü ekle ve düşük top1conf tahminlerini incelemeye yönlendir.
Belirti: Önceden eğitilmiş bir model, herhangi bir eğitim yapılmadan önce veri kümenizde sıfıra yakın puan alıyor. Neden: yolo26n-cls.pt, 1.000 ImageNet indeksi tahmin ediyor ve klasörleriniz 0–9 indekslerini farklı anlamlarla yeniden kullanıyor: MNIST160'ta 0 klasörü 0 indeksidir; önceden eğitilmiş başlık bu indeksi tench olarak adlandırır. Bu şekilde top-1 değerini 0.000 ölçtük. Çözüm: Önce ince ayar yap, ardından doğrula.
Belirti: Doğrulamada top-1 1.0'a yakın, üretimde ise çok daha düşük. Neden: Aynı parçanın birbirine çok benzeyen fotoğrafları hem train/ hem de val/ içinde bulunuyor. Çözüm: Veri Kümesini Doğru Bölme bölümünde olduğu gibi parçaya veya oturuma göre böl.
Sınıflandırıcılar 640'ta değil, imgsz=224 boyutunda önceden eğitilir. Büyük bir karenin içindeki küçük nesneler için daha büyük bir imgsz yerine tespit edip ardından sınıflandırma yapmak (sonraki ders) daha uygundur.
Çözümü göster
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Çalıştırmalarımız: 1 epoch → top-1 0.162, top-5 0.463; 10 epoch → top-1 0.550, top-5 0.950. Beş sınıfta doğru yanıt her zaman ilk beş arasındadır; dolayısıyla top-5, tanımı gereği 1.0'dır ve sana hiçbir bilgi vermez.
Kabul edilen görüntülerde %75 doğruluk için route.py, 0.6 eşiğini öneriyor (kabul edilen 10 görüntüde %80 doğruluk); bu da 80 rakamdan 70'ini incelemeye gönderiyor. Dürüst yanıt bu: eşik doğruluk koşulunu karşılıyor ama model henüz kullanışlı değil. Gerçek kullanım için eşik seçmeden önce daha uzun eğit ve tabloyu yeniden oluştur.