Veri Kümesini Doğru Şekilde Böl
Rastgele bölmelerin nasıl veri sızıntısına yol açtığını ölç, bir betikle klipler, kameralar veya günler gibi grupları bütün hâlde böl, sınıf kapsamını kontrol et ve test kümesini kilitle.
Dikkatsizce yapılan bir bölme, doğru sandığın ama gerçekte doğru olmayan bir metrik üretir. Birbirine yakın video kareleri hem eğitim hem doğrulama kümesine düştüğünde, doğrulama mAP değeri genelleme yerine ezberi ölçer ve aradaki fark ancak üretimde ortaya çıkar. Model hakkında raporladığın her sayı bu bölmeye bağlıdır; bu yüzden bölmeyi bir kez bilinçli olarak seç ve sabit tut.
Uygulamalı
Üç bölme, üç görev#
| Bölme | Tipik oran | Görev |
|---|---|---|
| Eğitim | 70% | Model ağırlıklarını bu kümeden öğrenir |
| Doğrulama | 15% | En iyi epoch'u seç, çalıştırmaları karşılaştır, ayarları düzenle |
| Test | 15% | Kabul testine göre verilecek son kabul/ret kararı |
Ultralytics kılavuzları, eğitim için %70–80 ve doğrulama ile test için ayrı ayrı %10–20 aralığını öneriyor: bir bilgisayarlı görü projesinin adımları her biri için %10–15 önerirken, ön işleme kılavuzu %70/%20/%10 oranını kullanıyor. Bir kalabalık görsel, on seyrek görselden daha fazla etiket içerebileceğinden, oranları görsellerin yanı sıra nesneler üzerinden de hesapla. Kesin yüzdeler, her bölmenin ne amaçla kullanıldığından çok daha az önemlidir.
Rastgele bölmeler ilişkili verilerde sızıntıya yol açar#
Aynı klibin 124 ve 125 numaralı kareleri neredeyse aynıdır. Biri eğitim, diğeri doğrulama kümesine düşerse model, fiilen daha önce gördüğü görseller üzerinden değerlendirilir. Dosya adları kamera-gün grup anahtarıyla başlayan Yüksek Kaliteli ve Temsili Veri Topla uygulama kümesinde bunu ölç:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainDoğrulama kümesindeki her kamera-gün, eğitim kümesinde de yer alıyor. Gerçek görüntülerde bunun anlamı, doğrulama karelerinin eğitim kareleriyle aynı ışıklandırmayı, arka planı ve çoğu zaman aynı nesneleri paylaşmasıdır; bu nedenle doğrulama mAP değeri çok iyi görünürken üretim mAP değeri iyi görünmez.
Bölme birimini seç#
Dağıtımın gerektirdiği genelleme türüne uyan grubu seç:
Kararsızsan, karşılayabileceğin en genel birime göre böl: bu, en dürüst sonucu verir. Görsel başına rastgele bölmeler yalnızca her görselin haftalar arayla çekilmiş ürün fotoğrafları gibi bağımsız bir çekim olduğu durumlarda güvenlidir.
Kodda gruplara göre böl#
Bu betik, her bölme %70/%15/%15 oranına ulaşana kadar grupların tamamını bölmelere atar, bir veri YAML dosyasının kabul ettiği dosya listelerini yazar ve sınıf kapsamını raporlar:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingNasıl okunur:
- Hiçbir grup bölmeler arasında yer almıyor; bu, tasarım gereği böyle. Sızıntı giderildi.
- Doğrulama kümesinde 2 grup var ve 36 sınıf eksik, bu nedenle bu sınıflar için AP ölçülemiyor. 128 görselde 71 sınıf varken hiçbir rastgele tohum bu sorunu çözemez; asıl çözüm daha fazla grup (daha fazla kamera veya gün) toplamaktır. Üretime yönelik, sınıf başına 1.500'den fazla görsel içeren bir veri kümesinde de gereken budur.
- Eğitim kümesinde, yalnızca doğrulama veya test kümesinde bulunan 5 sınıf eksik. Model bu bölmeyle bu sınıfları hiçbir zaman öğrenemez.
Karar kuralı: Bir sınıf bir bölmede eksikse, bu sınıfı içeren grupların tamamını ekle veya taşı; sızıntıyı yeniden oluşturacak tekil kareleri asla taşıma. Veri YAML dosyasının train, val ve test anahtarlarını üç .txt dosyasına yönlendir; dosyanın geri kalanını Veri Kümesi YAML Dosyası Yazma açıklar.
Sınıfları bölmeler arasında dengele#
Sınıflandırma için scikit-learn'in train_test_split(..., stratify=labels) işlevi, tek bir argümanla sınıf oranlarını bölmeler arasında eşit tutar. Tespit görselleri aynı anda birden fazla sınıf içerir; bu yüzden dengelemeyi grup düzeyinde yap: group_split.py işleminden sonra bölmelerdeki sınıf başına sayıları karşılaştır ve her sınıf beklenen oranının yaklaşık ±%20 aralığına gelene kadar grupların tamamını değiştir.

Ultralytics Platform'da Bölmeleri Yeniden Dağıt, görselleri rastgele yeniden atar ve Otomatik, önerilen %80/%20 eğitim/doğrulama bölmesini ayarlar (bölme belgeleri). İşlem sırasında tamamen aynı görselleri kaldırır ama gruplarını bilmez; bu nedenle özelliği bağımsız çekimler için kullan, video veya çok kameralı verilerde ise gruplara göre bölünmüş verileri yükle.
İki doğrulama kümesini ayrı ayrı izle#
Çoğu zaman iki doğrulama kümesi istersin: kararlı ve özenle seçilmiş bir regresyon paketi ile yeni toplanan karelerle yenilenen, üretimi gerçekçi biçimde yansıtan bir küme. Veri YAML dosyası birden fazla doğrulama klasörü kabul eder ancak bunları tek bir puana sahip tek bir doğrulama kümesinde birleştirir:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Her puanı ayrı görmek için her doğrulama kümesine bir veri YAML dosyası ayır (aynı train ve names, farklı val) ve eğitilmiş ağırlıkları her birine göre doğrula:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Özenle seçilmiş kümedeki düşüş regresyona; üretim kümesindeki düşüş ise alan kaymasına işaret eder.
Test kümesini kilitle#
Bölme sırasında yapılabilecek en maliyetli hata, test kümesinde on model varyantını karşılaştırmaktır. Test herhangi bir kararı etkilediği anda nihai sonuç iyimser olur. Tüm ayarlamaları ve koşu karşılaştırmalarını doğrulama kümesinde yap; kabul testini test kümesinde yalnızca en sonda bir kez çalıştır.
Yayımladığın her metrik bu bölmeye bağlıdır. Daha sonra yeniden karıştırmak tüm sayıları değiştirir ve eski koşularla yenilerini karşılaştırılamaz hâle getirir. Bölme birimini, tohumu ve üç dosya listesini veri kümesiyle birlikte sakla.
Küçük veri kümeleri için k katlı çapraz doğrulama#
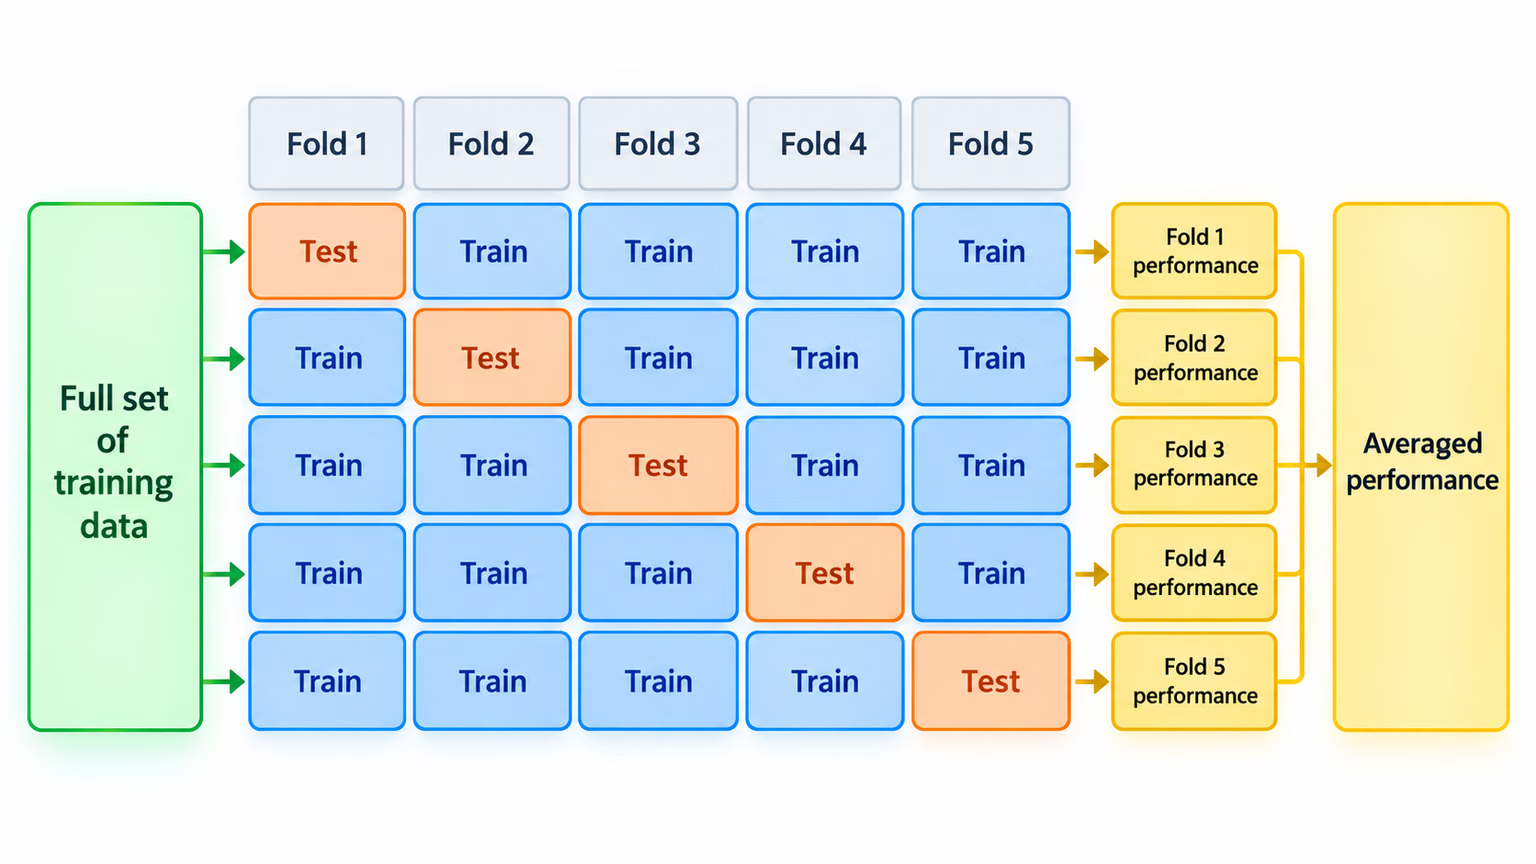
Veri kümesi küçükse (sınıf başına yaklaşık 500 görselden az) ve tek bir bölme istatistiksel açıdan zayıf görünüyorsa, k katlı çapraz doğrulama dönüşümlü bölmelerle k model eğitir ve sonuçların ortalamasını alır: çok daha istikrarlı bir tahmin için k kat hesaplama gerekir. Katları da aynı şekilde gruplara göre oluştur; yoksa her kat sızıntı içerir.
Çözümü göster
Yeni günlerde de çalışması gereken sabit depo kameraları için kamera-güne göre böl: cam2_2026-05-01. group_split.py işleminden sonra hiçbir grubun bölme sınırını aşmadığını doğrula:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneUygulama bölmesi sızıntı kontrolünü geçiyor ama kapsam kontrolünde başarısız oluyor: doğrulama kümesinde 71 sınıfın 36'sı eksik. Çözüm, bölmeleri yeniden karıştırmak değil, veri toplama planı hazırlamak. Doğrulama ve test için en az iki kamera-gün daha kaydet; her biri teknik gereksinimin en çok önem verdiği sınıfları içersin ve iki betiği de yeniden çalıştır.