Akıllı Anotasyon ve Toplu Etiketleme
İnceleme işini ölçerek bir etiketleme modeli ve güven eşiği seç, ardından Toplu Anotasyon'u çalıştır ve düzenleme oranıyla doğrula.
Kutuları elle çizmek saatte belki 100 görüntü hızında ilerler; iyi ön etiketleri gözden geçirmek birkaç kat daha hızlı olabilir. Ancak yanlış güven eşiğinde çalışan bir etiketleme modeli, kazandırdığından daha fazla iş çıkarabilir; incelemeden bırakılan bir model ise sonraki modele kendi hatalarını öğretir. Bu derste gerçek etiketli veriler üzerinde her eşikteki inceleme işini ölçerek, tahmin yürütmek yerine sayılara göre eşik seçmeni sağlayacağız.
Uygulamalı
Ön Etiketleme için Üç Yöntem#
Anotasyon düzenleyicisinde Draw modu (V) elle çalışır; Smart modu (S) ise modelin etiket önermesini sağlar:
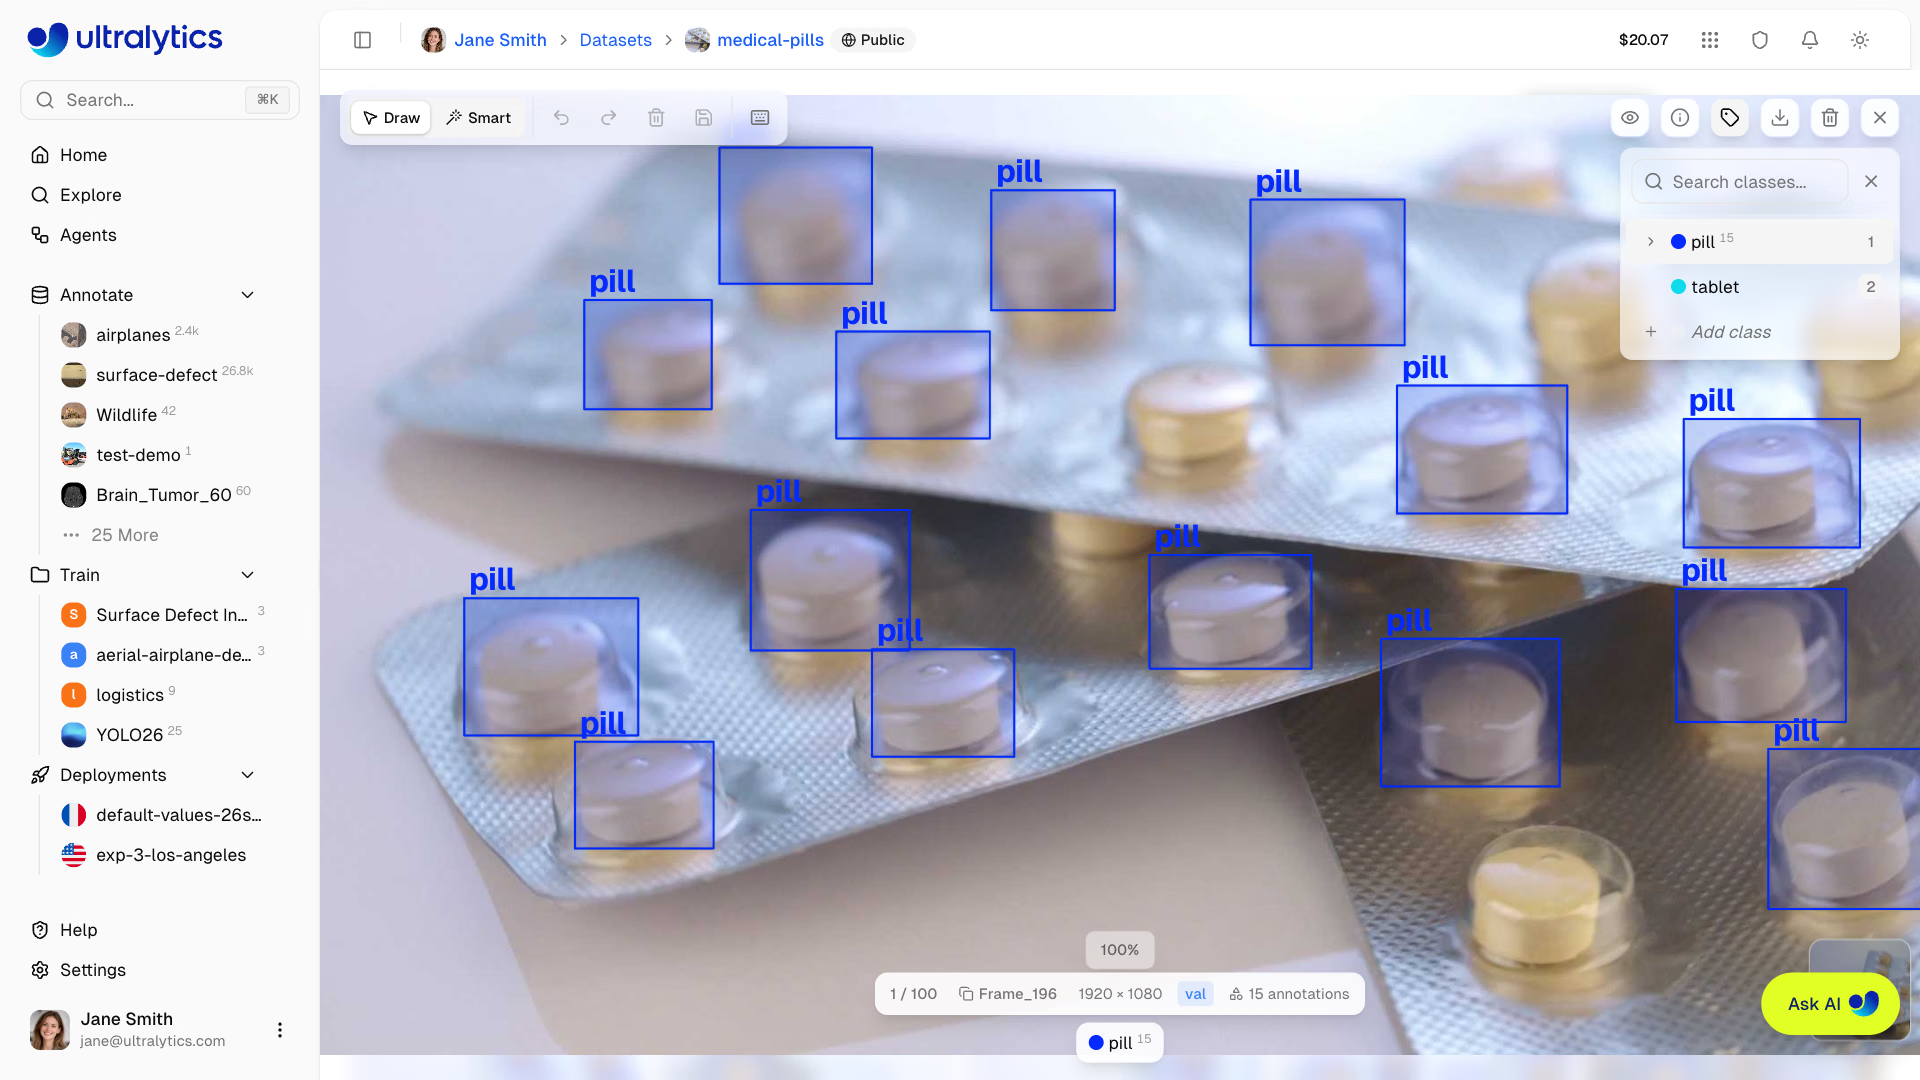
| Aile | Çalışma şekli | Görevler | Maliyet |
|---|---|---|---|
| SAM (SAM 2.1 Tiny'den Large'a, SAM 3, varsayılan SAM 3.1) | Maske oluşturmak için bir nesneye tıkla; eklemek için dışına, çıkarmak için içine tıkla; otomatik uygulamayı açıp kapatmak için A kullan | Algılama, segmentasyon, anlamsal segmentasyon, OBB | Ücretsiz |
| YOLO (resmî veya kendi modellerin) | Predict modelin algılamalarını ekler; Sınıfları eşleştir, model ve veri kümesi sınıflarını hizalar; IoU değeri 0.7+ olan yinelenenler atlanır | Algılama, segmentasyon, anlamsal segmentasyon, OBB, poz | Düzenleyicide ücretsiz |
| Sınıf istemiyle çalışan (varsayılan Moondream 3.1, YOLOE-26x, SAM 3 Text ve diğerleri) | Görüntüde veri kümesinin sınıf adlarını bulur; ücretli sağlayıcı modelleri kendi API anahtarınla çalışır | 1–200 sınıflı algılama veri kümeleri | Barındırılan modeller ücretsiz |
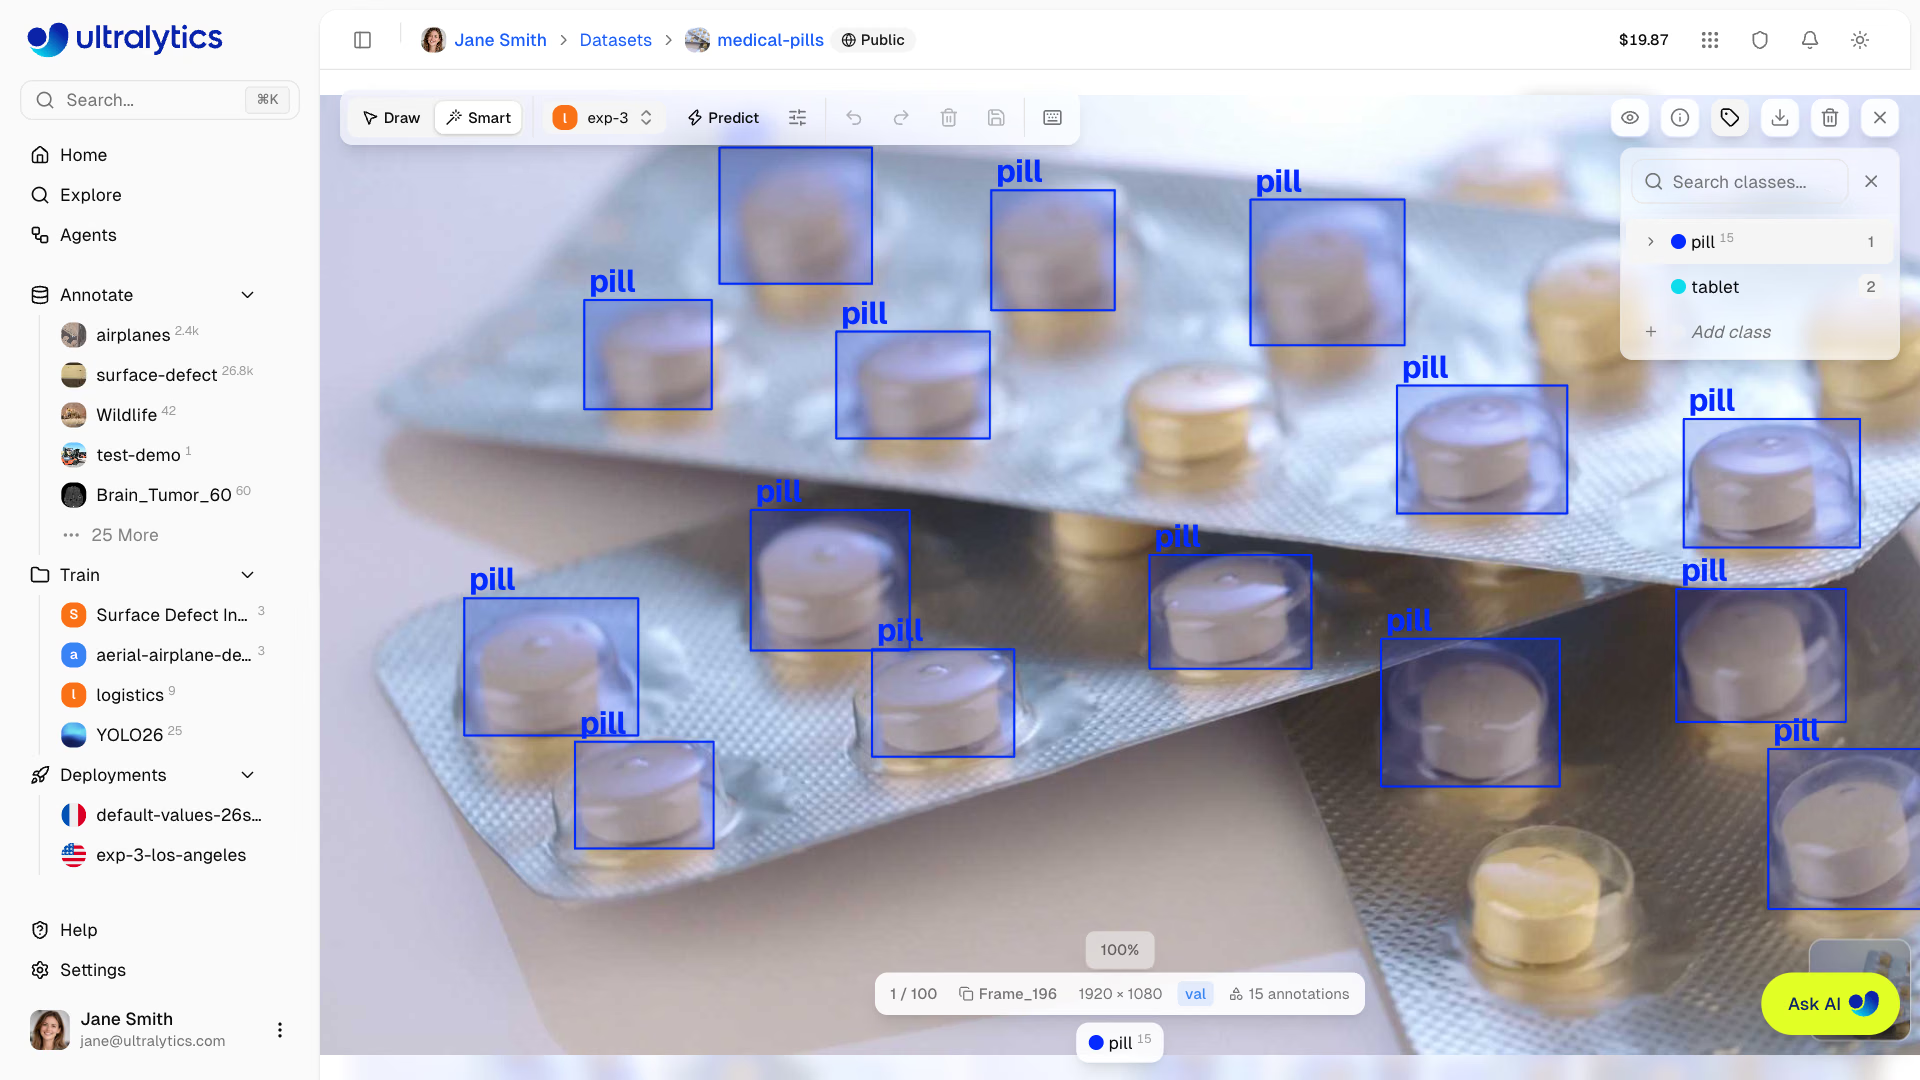
SAM her nesne için bir tıklama gerektirir ve en sıkı şekilleri verir. Model tahminleri görüntü başına bir tıklamaya mal olur ve yalnızca model kadar iyidir; bu nedenle dersin geri kalanı bu modeli seçip ayarlamaya odaklanıyor.
Etiketleme Modelini Seç#
100–200 elle etiketle eğitilmiş zayıf bir v0 bile sıfırdan çizmekten iyidir; v1'e gelindiğinde genellikle yararlı bir aktif öğrenme yardımcısına dönüşür. Sınıf istemiyle çalışan modellerin başarısı alana göre büyük farklılık gösterir: günlük fotoğraflarda neredeyse her şeyi bulan bazı modeller PCB, röntgen veya perakende görüntülerindeki nesnelerin çoğunu kaçırır; bu nedenle bir modele güvenmeden önce on tahminini kontrol et.
Çözümlü Örnek: Her Eşikteki İnceleme İşini Ölç#
Güven eşiği, inceleyenlerin zamanını neye harcayacağını belirler: çok düşük olursa yanlış kutuları silerler, çok yüksek olursa modelin atladığı kutuları çizerler. Bunu, etiketleri zaten doğru olan görüntüler üzerinde ölç; burada etiketleme modeli olarak önceden eğitilmiş bir YOLO26n ile COCO128 veri kümesinin etiketli 128 görüntüsünü kullanıyoruz:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Nasıl çalıştığı ve sonuçların ne anlattığı:
- Model, düşük bir
conf=0.05değerinde bir kez tahmin üretir; ardından her eşik aynı tahminleri filtrelediğinden eşik taraması hızlıdır. review_work, her tahmini aynı sınıftan ve IoU değeri en az 0.5 olan bir gerçek referans kutusuyla eşleştirir. Eşleşmeyen tahminler, inceleyenin sileceği kutulardır; eşleşmeyen gerçek referanslar ise inceleyenin çizeceği nesnelerdir.- Görüntü başına düzenleme sayısı 0.25–0.4 aralığında en düşük seviyeye (4.7) iner. Bunun altında silme sayısı fırlar; üstünde ise kaçırılan nesne sayısı artar.
- En iyi eşikte bile inceleyenler görüntü başına yaklaşık 3.6 kutu çizer; çünkü COCO'daki uzun kuyruklu küçük nesneler bir nano model için zordur.
Karar kuralları: Görüntü başına en az düzenleme gerektiren eşiği seç. Her eşikte çizme baskınsa etiketleme modeli veriler için çok zayıftır; daha büyük bir model veya kendi ince ayarlı modelini kullan. Silme 0.5'te bile baskınsa model benzer görünen sınıfları karıştırıyordur; daha fazla etiketlemeden önce karışıklık matrisini kontrol et. Kendi projen için, daha önce etiketlediğin 50–100 görüntü üzerinde ince ayarlı modelinle eşik taraması yap.
Toplu Anotasyon'u Çalıştır#
Toplu Anotasyon, tüm veri kümesinde bir YOLO veya sınıf istemiyle çalışan model kullanır. Diğer işlemler > Toplu Anotasyon yoluyla açabilir veya düzenleyicide bir tahmin yaptıktan sonra çıkan bildirideki Tümünü anotasyonla seçeneğine tıklayabilirsin:
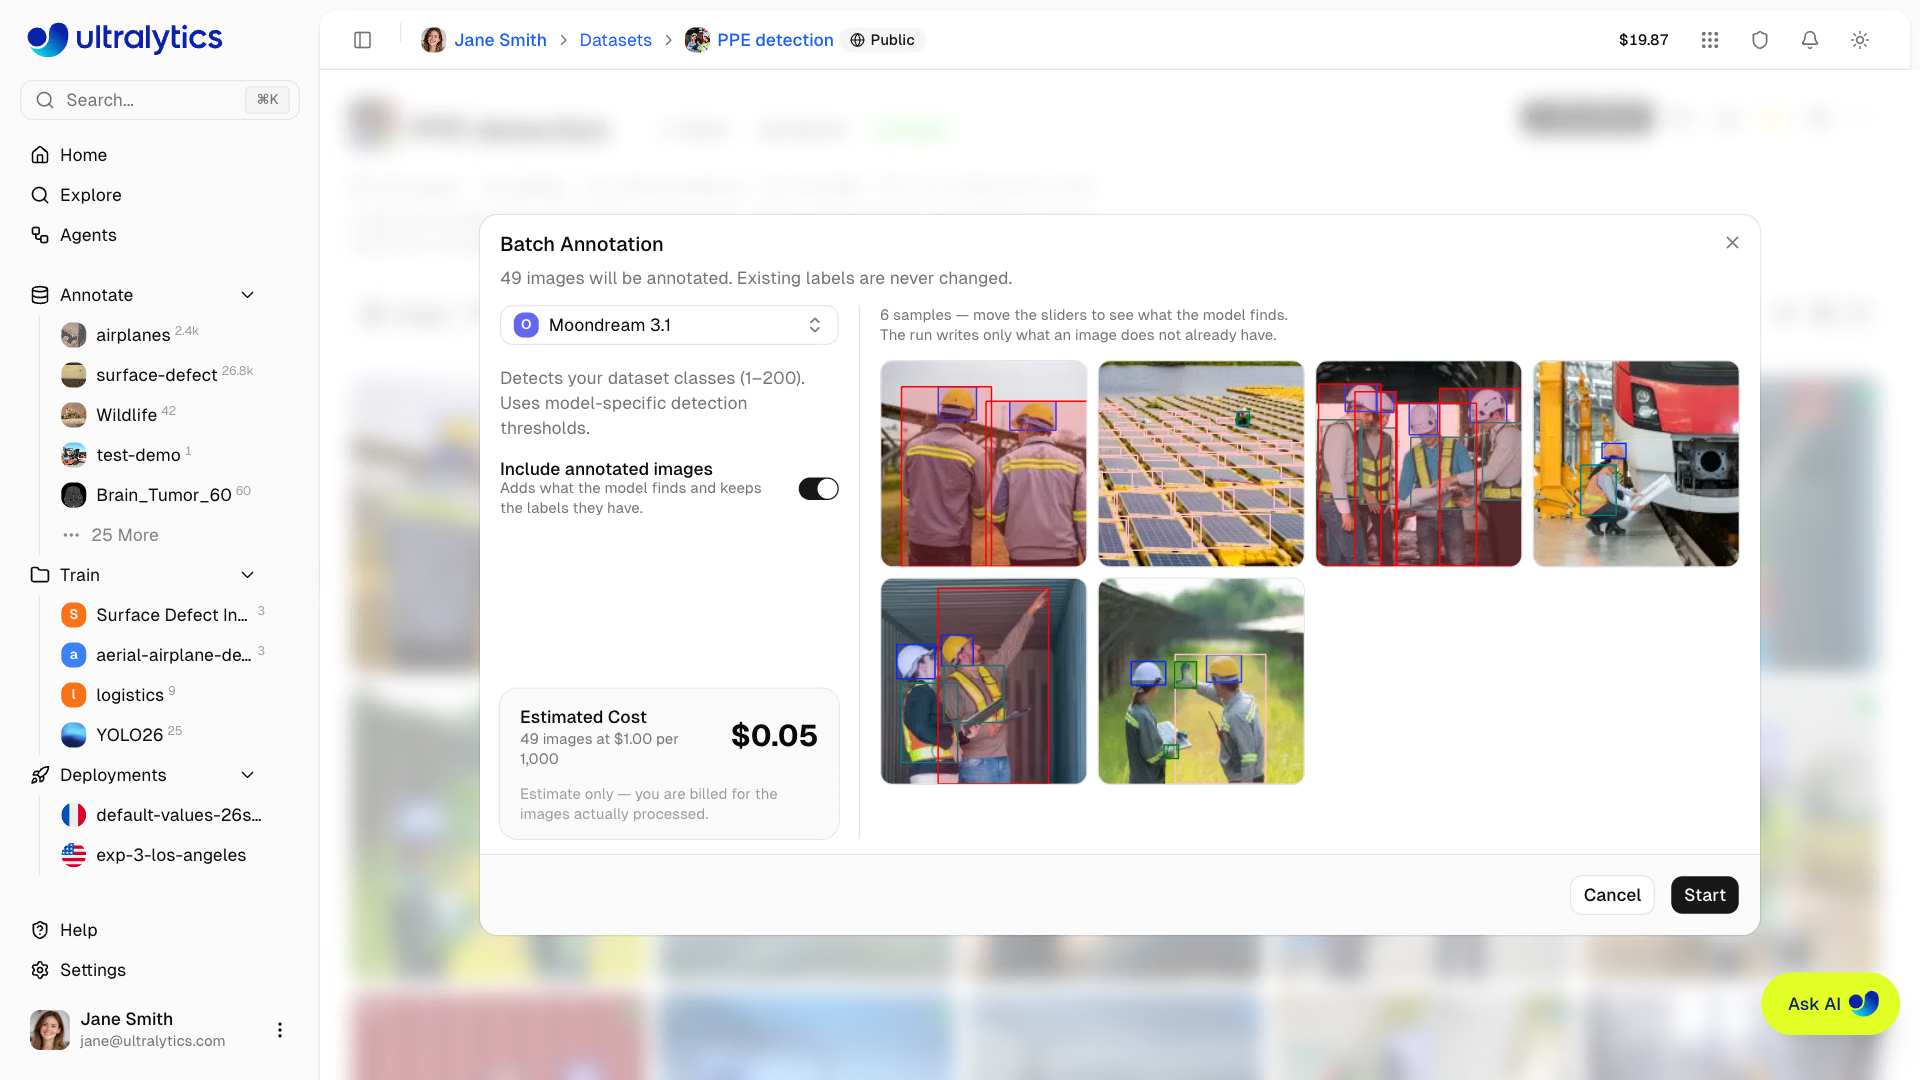
- Modeli seç. Algılama veri kümelerinde Moondream 3.1 seçili olarak açılır; ince ayarlı modeline veya YOLO modeline geç.
- Bir YOLO modeli için güven değerini taramada seçtiğin eşiğe (varsayılan
0.25) ve IoU değerini (0.7) ayarla; ardından örnek önizlemelerini kontrol et. - Yalnızca etiketsiz görüntüleri etiketlemek için Etiketli görüntüleri dahil et seçeneğini kapalı bırak.
- Tahmini Maliyet'i (1.000 görüntü başına 1,00 ABD doları, en az 0,01 ABD doları) kontrol et ve Başlat'a tıkla.
Bir çalıştırma başlatıldığında önce veri kümesi sürümü kaydedilir; böylece çalışma öncesindeki durumu geri yükleyebilirsin. Durdur seçeneği, o ana kadar işlenen görüntüleri tutar ve ücretlendirir.
İncele, Ardından Düzenleme Oranını Ölç#
Tahminler sıradan anotasyonlar olarak kaydedilir; dolayısıyla incelenmediklerini belirten bir işaret olmaz. Önce nadir sınıfları kontrol etmek için sınıfa göre filtrele; ardından Anotasyonlar sütununa göre artan (muhtemelen kaçırılan nesneler) ve azalan (kutuların birleşebileceği kalabalık sahneler) sıralama yap. Sonra bir sürüm oluştur, Sürümler sekmesinde Sürümleri karşılaştır'ı aç ve Kaynak sürümü olarak v_auto öğesini seç:
| Sayı | Anlamı |
|---|---|
| Eklenen | Modelin kaçırdığı nesneler ve düzeltilen her kutunun yeni, düzeltilmiş kopyası |
| Kaldırılan | Yanlış pozitifler ve düzeltilen her kutunun ilk hâli |
| Düzenleme oranı | (eklenen + kaldırılan) ÷ v_auto sürümündeki anotasyonlar; düzeltilen bir kutu iki kez sayıldığından bu üst sınırdır |
Her toplu işlem için düzenleme oranını takip et. Oranın yükselmesi, yeni görüntülerin etiketleme modelinin bildiklerinden uzaklaştığına dair erken bir uyarıdır. Anotasyon en iyi uygulamaları dersi, etiketleme kılavuzlarını ve inceleyenler arasındaki uyumu ele alır.
Yaygın Hatalar#
Belirti: Her yeniden eğitimde yaklaşık aynı puan alınıyor ve aynı nesneler sürekli kaçırılıyor. Çözüm: İncelenmemiş ön etiketler, etiketleme modelinin sistematik hatalarını gerçekmiş gibi veri kümesine taşır: birbirine benzeyen bir sınıf, sürekli gevşek çizilen bir kutu kenarı ve modelin hiç algılamadığı nesneler. Eğitim sürümüne eklenmeden önce her görüntüyü incele.
Belirti: Toplu Etiketleme tamamlanıyor ama nesnelerin çoğu hâlâ etiketsiz. Çözüm: Önce düzenleyicideki modeli temsili on görüntüde çalıştır. Birkaçdan fazla nesneyi kaçırıyorsa başlangıç kümesini elle etiketle ve bunun yerine v0 eğit.
Belirti: Tahmin edilen kutular yanlış sınıf adlarını taşıyor. Çözüm: Modelin sınıfları veri kümesindekilerden farklı olduğunda Sınıfları eşle adımı, her model sınıfını bir veri kümesi sınıfıyla eşleştirir veya sınıfı atlar. Eşleştirmeyi dikkatle yap; yanlış bir eşleştirme, o sınıfa ait her kutuyu yanlış etiketler.
Çözümü göster
Uygulamalı örnek: Tarama, bir hap denetimi ince ayarı için 0.35'i seçiyor. Batch Annotation, 1.240 açıklama içeren v4 sürümünü kaydediyor. İncelemeden sonra Compare versions, v4 → v5 için 96 eklenen ve 152 kaldırılan açıklama gösteriyor; dolayısıyla düzenleme oranı (96 + 152) ÷ 1.240 = %20 oluyor. Kaldırılanların eklenenlerden fazla olması aşırı tahmine işaret ediyor: kaldırılan kutuları inceleyince modelin blister ambalaj yansımalarını hap olarak işaretlediği görülüyor. İki adım izlenebilir: sonraki toplu işlemde güven eşiğini bir kademe yükselt (0.35 → 0.45) ve oranın düştüğünü doğrula; ayrıca ince ayarın farkı öğrenmesi için sonraki eğitim sürümüne parlak ambalajların gözden geçirilmiş 30 görüntüsünü ekle.