Çalıştırmaları Karşılaştır ve Kazananı Seç
Platform projesinde çalıştırmaları karşılaştır, her çalıştırmanın nedenini kaydet ve betikleştirilmiş bir terfi eşiğiyle adayın kullanıma sunulup sunulmayacağına karar ver.
Daha büyük modeller genellikle öne çıkan metrikte kazanır, ardından kimsenin kontrol etmediği bir sınıfta kaybeder. Önceden kararlaştırılmış bir kural yoksa kullanıma sunulan çalıştırma, birinin en çok beğendiği çalıştırma olur. Bu derste, gerekçesinin daha sonra bulunabilmesi için her çalıştırma kaydedilir ve “daha iyi mi?” sorusu PASS veya FAIL döndüren bir eşik betiğine dönüştürülür.
Uygulamalı
Bir Projede Çalıştırmaları Karşılaştır#
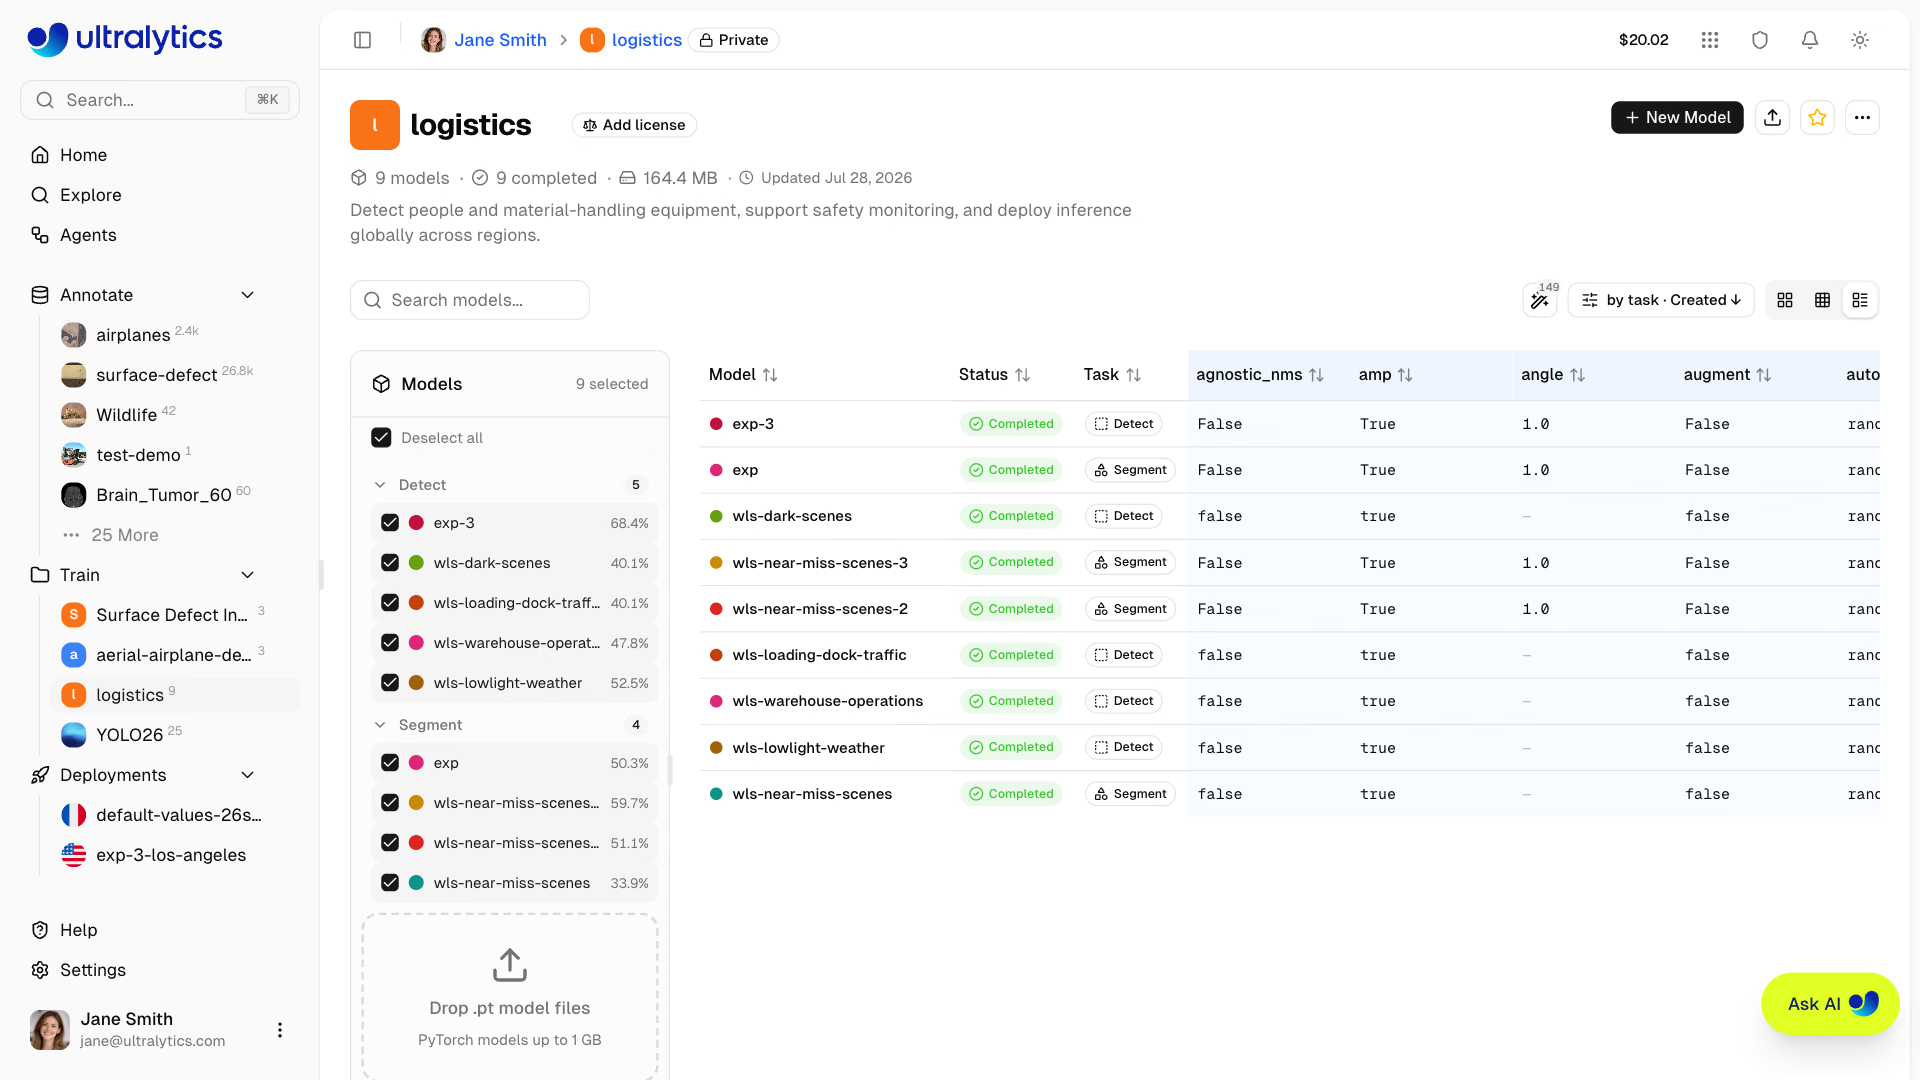
Bir proje, modellerini onay kutularıyla listeler. Seçilen modeller Charts panosunda üst üste gösterilir; Table görünümünde eğitim argümanları ve son metrikler yan yana getirilir; Diff ise aynı olan sütunları gizleyerek iki çalıştırmanın yalnızca imgsz bakımından farklı olduğunu bir bakışta görmeni sağlar. Karşılaştırma tek bir proje içinde yapılır; bu nedenle birbiriyle ilişkili deneyleri aynı yerde tut (modeller projeler arasında kesilip yapıştırılabilir). Eğrileri incelerken son değeri, her çalıştırmanın bu değere ne kadar hızlı ulaştığını ve bunun ne kadar düzgün gerçekleştiğini karşılaştır.

Tamamlanmış iki veya daha fazla model varsa Compare with AI, farkları özetlemesi ve sonraki deneyi önermesi için Ask AI'a başvurur. Önerisini bir karar değil, sonraki çalıştırman için bir hipotez olarak değerlendir.
Her Çalıştırmanın Gerekçesini Açıkla#
Anlamı adlar taşır: run_5 hiçbir şey anlatmaz; v3_pallets_added ve v4_imgsz1024 ise hangi veri kümesi sürümünün kullanıldığını ve nelerin değiştiğini belirtir. Gerekçeyi kaydetmek için model sayfasında More actions > Information'ı aç ve bir JSON notunu Custom Metadata olarak kaydet:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Gerisini Platform kaydeder: Run Information kartında GPU, saatlik ücret, toplam maliyet, ultralytics sürümü, ana bilgisayar, üst model, sabitlenmiş veri kümesi sürümü, varsa Git commit'i ve kopyalanabilir bir yolo train komutu gösterilir. Karşılaştırmalar yalnızca aynı veri kümesi sürümündeki çalıştırmalar arasında adildir; bu nedenle her çalıştırmada bir sürüm sabitlenmelidir.
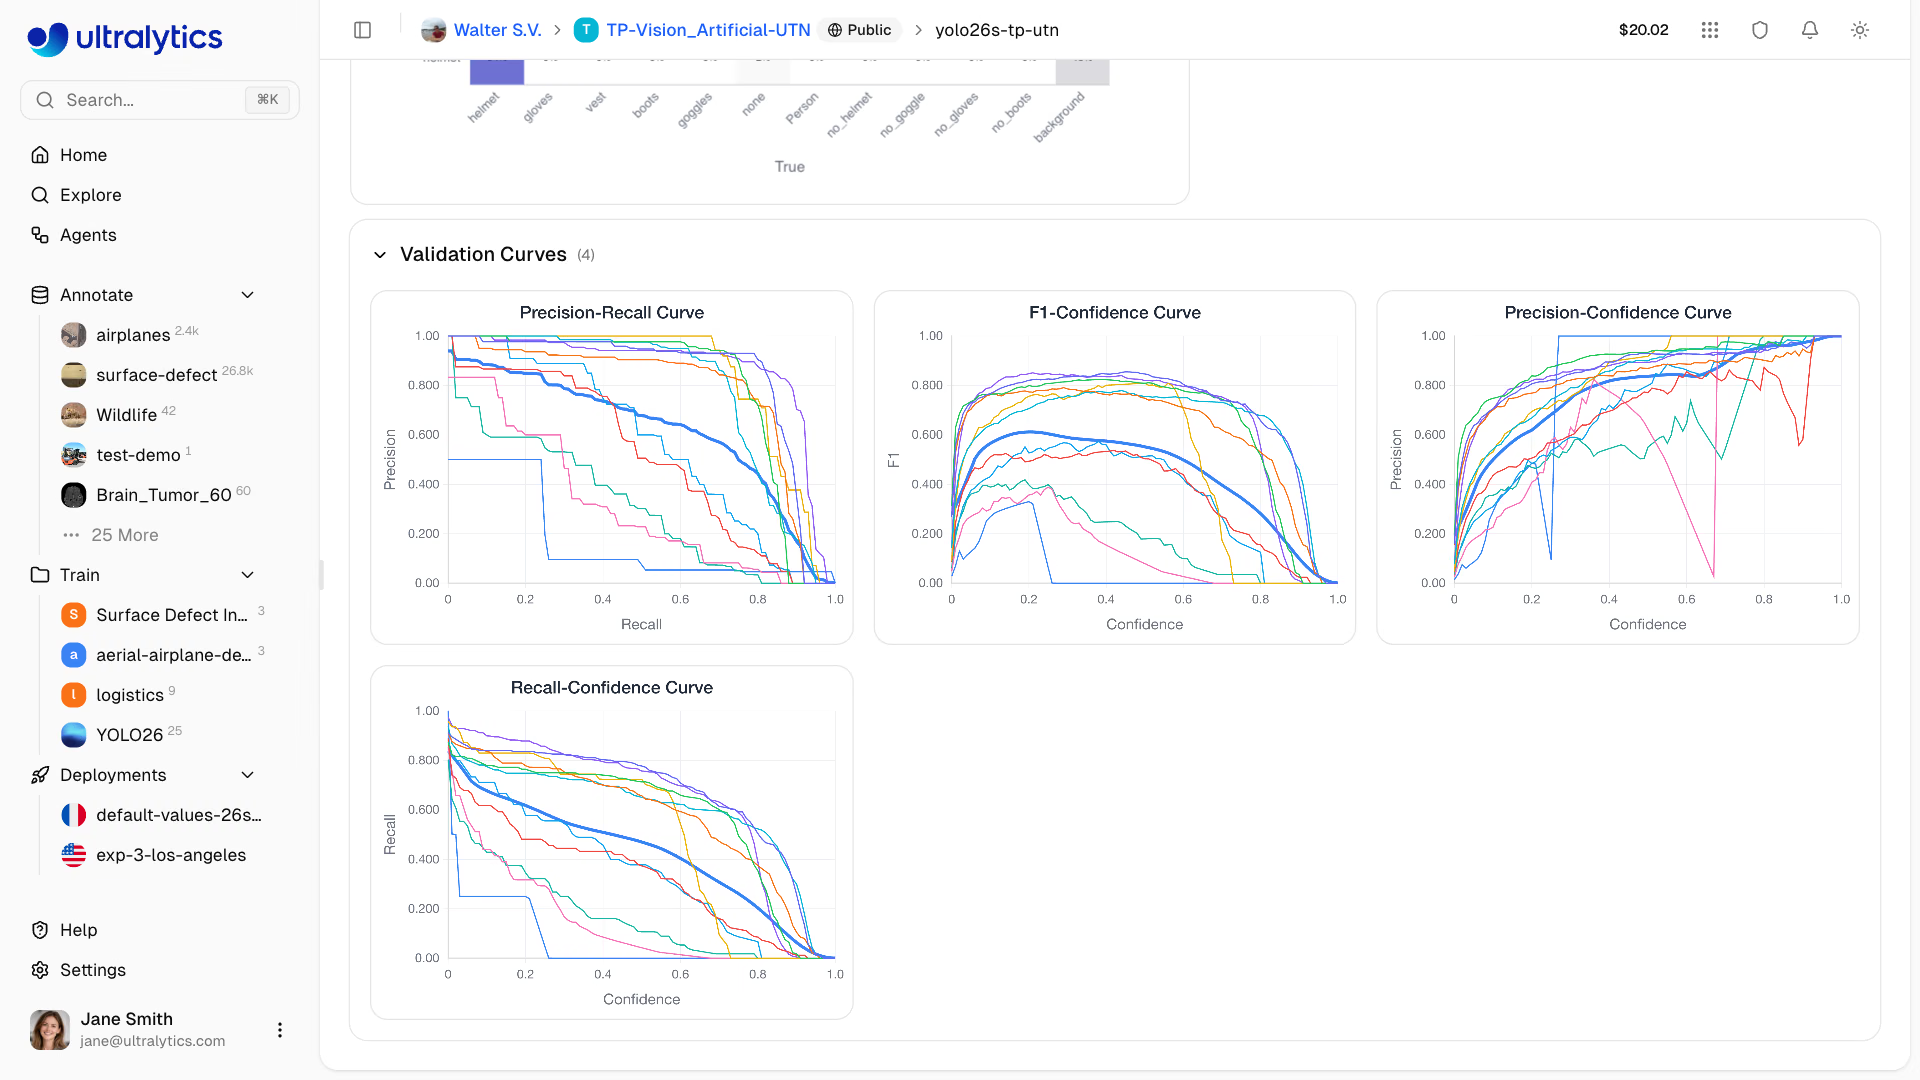
Metrik ve Eşikleri Sonuçlara Bakmadan Önce Seç#
| Ölçüt | Uygun olduğu durum |
|---|---|
| mAP50-95 | Detect, segment, pose ve OBB için varsayılan seçenek: sıkı kutuları ödüllendirir ve karşılaştırma için yeterince kararlıdır |
| mAP50 | Kutu sıkılığının pek önem taşımadığı, büyük ve birbirinden iyi ayrılmış nesneler |
| Tek bir sınıf için sınıf başına AP | İş değerini tek bir sınıf belirler |
| Sabit precision değerinde recall | Güvenlik ve alarm sistemleri |
| Hedefte çıkarım gecikmesi | Her zaman, katı bir sınır olarak |
YOLO performans metrikleri kılavuzu her metriği açıklar. Bir aday yalnızca tüm eşikleri geçerse kullanıma sunulur:
Uygulamalı Örnek: Terfi Eşiği Betiği#
Finalistlerin best.pt dosyalarını indir ve aynı kodla, aynı veride puanla. Bu örnekte, her yerde çalışabilmesi için iki resmî kontrol noktası kullanılıyor:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsSonuç: Büyük model genel olarak 2,4 puan farkla kazanıyor; ancak iki sınıfta AP %10'dan fazla düşüyor ve model bu nedenle başarısız oluyor. Öne çıkan metriklere dayalı bir karşılaştırmanın gizlediği gerileme budur. Sınıf başına sözlük ap_class_index ve ap değerlerinden gelir; bu değerler yalnızca veride bulunan sınıfları kapsar. Gecikme, betiğin çalıştığı makinede ölçülür; bu yüzden eşiği dağıtım hedefindeki donanıma benzer bir donanımda çalıştır. COCO8'de yalnızca 8 doğrulama görüntüsü vardır; gerçek bir karar vermek için bu çok azdır. En az birkaç yüz görüntü içeren ayrılmış bir küme kullan ve son kararı vermek için split="test" değerini tam olarak bir kez geçir.
Zayıf Görüntüleri İncele#
Kaydedilmiş bir veri kümesi sürümüyle eğitilmiş algılama çalıştırmalarında Validation görünümüne Validation insights eklenir: gerçek etiketlerle gösterilen, görüntü başına F1 değerine göre en kötü ve en iyi performans gösteren görüntüler; F1 değerini görüntü boyutu, en-boy oranı ve örnek sayısıyla ilişkilendiren bir özellik gezgini; ayrıca başarısızlıklarla en çok ilişkili sınıflar. En kötü görüntülerdeki Find similar özelliği, benzer görüntüleri etiketsiz olarak eğitim kümesine ekleyerek başarısız bir eşik kontrolünü somut bir veri görevine dönüştürür.
Yaygın Hatalar#
Belirti: Raporlanan test mAP'i harika, ancak üretim sonuçları daha kötü. Çözüm: Ayarları doğrulama kümesinde yap. Test kümesinde on çalıştırmayı karşılaştırdıysan, bu küme ayarlama için kullanılmıştır ve elde edilen değer iyimserdir. Son adayları test kümesinde yalnızca bir kez, en sonunda değerlendir.
Belirti: Bir çalıştırma 4 puan farkla “kazanıyor” ve kimse bunun nedenini yeniden üretemiyor. Çözüm: Her çalıştırmanın Çalıştırma Bilgileri kartındaki sabitlenmiş veri kümesi sürümünü kontrol et. Sürümler farklıysa karşılaştırmadan önce başlangıç ölçümünü yeni sürümde yeniden çalıştır.
Belirti: Yeni bir tohumla yeniden eğitim yaptığında kazanan her seferinde değişiyor. Çözüm: Çoğu veri kümesinde yaklaşık 0,5 mAP puanının altındaki farklar, çalıştırmalar arasındaki gürültüdür. Kapıda gürültü eşiğini koru ve sonuçlar bu kadar yakınsa daha büyük bir ayrılmış doğrulama kümesi kullan.
Çözümü göster
Hap modeli için uygulamalı yanıt: temel model v1-baseline (10 epoch), adaya karşı v2-finetune (5 epoch daha, SGD, lr0 0.001). DATA = "medical-pills.yaml" değerini ve iki ağırlığı gate.py içinde ayarla. Çıktı: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms; karar “adayı kullanıma sun”. v2'deki Custom Metadata: hipotez “v1, 10. epoch'ta hâlâ gelişiyordu”, değişiklik “5 epoch ince ayar, SGD lr0 0.001”, sonuç “mAP50-95 0.659 -> 0.687”. Metadata'da belirtilmesi gereken uyarı: medical-pills doğrulama verileri de eğitime yön verdi; bu nedenle üretime almadan önce ayrı bir ayrılmış veri kümesinde doğrula.