Xác định khi nào dataset đã sẵn sàng
Chỉ bắt đầu lượt huấn luyện đầu tiên khi dataset vượt qua tám tiêu chí đạt/không đạt; tự động hóa ba tiêu chí mà script có thể kiểm tra và xác định cách khắc phục cho từng lỗi.
Dự án nào rồi cũng đến lúc cả nhóm muốn bắt đầu huấn luyện. Đôi khi dataset đã sẵn sàng; đôi khi dataset vẫn bị rò rỉ giữa các tập chia hoặc có class thiếu nhãn, gây lãng phí cả tuần chạy GPU và tạo ra một con số không đáng tin. Tám tiêu chí, mỗi tiêu chí được chấm đạt, không đạt hoặc có ngoại lệ được ghi nhận, giúp quyết định này khách quan thay vì tùy thuộc vào cảm tính.
Thực hành
Tám tiêu chí#
| # | Bước kiểm tra | Tiêu chí đạt | Nếu không đạt, quay lại |
|---|---|---|---|
| 1 | Mục tiêu rõ ràng | Mục tiêu, tác vụ, các class và bài kiểm tra chấp nhận đã được ghi lại và thống nhất | Bắt đầu từ mục tiêu kinh doanh |
| 2 | Các class được định nghĩa | Mỗi class có định nghĩa và một đối tượng dễ nhầm lẫn được nêu rõ là loại trừ | Mục tiêu và hướng dẫn gán nhãn |
| 3 | Ảnh có tính đại diện | Mỗi tình huống trong đặc tả đáp ứng chỉ tiêu, chủ yếu từ các nguồn dữ liệu sản xuất | Thu thập dữ liệu chất lượng cao, có tính đại diện |
| 4 | Số lượng đủ lớn | ≥ 1.500 ảnh và ≥ 10.000 instance cho mỗi class, hoặc có ngoại lệ được ghi nhận | Đặc tả và thu thập dữ liệu |
| 5 | Nhãn nhất quán | Đã soạn hướng dẫn, hoàn tất vòng hiệu chuẩn, mức độ nhất quán ≥ 90% | Các phương pháp gán nhãn tốt nhất |
| 6 | Đã hoàn tất QC | Script kiểm tra không phát hiện lỗi, các trường hợp đáng ngờ đã được xem xét, ghi chú QC đã được soạn | Kiểm soát chất lượng dataset |
| 7 | Các tập chia không bị nhiễm chéo | Chia theo nhóm, không nhóm nào xuất hiện trong hai tập chia, mọi class đều có mặt trong mỗi tập chia | Chia dataset đúng cách |
| 8 | Ảnh nền | 0–10% số ảnh là khung hình không có nhãn nào | Đặc tả và thu thập dữ liệu |
Danh sách kiểm tra này đánh giá lần lượt những quyết định tương tự như hướng dẫn thu thập dữ liệu và gán nhãn; tại đây, các quyết định được gộp thành một lựa chọn duy nhất: tiếp tục hay dừng.
Tự động hóa các tiêu chí có thể đếm được#
Các tiêu chí 4, 7 và 8 là phép tính số học, vì vậy script sẽ chấm chúng theo cùng một cách mỗi lần. Script này đọc bộ dữ liệu thực hành và danh sách các tập chia do group_split.py tạo trong bài học trước:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesViệc chia theo nhóm đã khắc phục rò rỉ, nhưng bộ dữ liệu thực hành còn lâu mới sẵn sàng: class yếu nhất (30, skis) chỉ có một instance được gán nhãn, và val không thể chấm điểm một nửa số class. Đây là kết quả dự kiến với 128 ảnh demo, và cũng chính là kết luận mà tiêu chí này cần đưa ra trước khi bạn mất cả tuần huấn luyện.
Script bao quát những gì có thể đếm được. Các mục kiểm tra 1, 2, 3, 5 và 6 cần có người thực hiện: mục tiêu đã thống nhất, định nghĩa bằng văn bản, độ bao phủ của đặc tả, điểm đồng thuận được đo lường và ghi chú QC. Hãy chấm thủ công, mỗi mục kèm một dòng bằng chứng.
Quyết định: huấn luyện, triển khai khi còn thiếu sót, hoặc khắc phục#
Khi một tiêu chí không đạt, bước tiếp theo hấp dẫn thường là làm việc gì đó khác thay vì khắc phục dữ liệu:
| Lối tắt hấp dẫn | Vì sao không hiệu quả |
|---|---|
| "Thử model lớn hơn." | Model lớn hơn cũng học nhiễu nhãn chính xác không kém. |
| "Điều chỉnh learning rate." | Không thiết lập optimizer nào có thể bổ sung class hoặc tình huống còn thiếu. |
| "Huấn luyện thêm epoch." | Huấn luyện thêm epoch trên dữ liệu hạn hẹp khiến model overfit nhanh hơn. |
| "Thêm phép tăng cường." | Phép tăng cường không thể tạo ra những tình huống chưa từng có trong dữ liệu. |
Ba tình huống gần đạt#
| Tình huống | Tiêu chí không đạt | Biểu hiện | Cách khắc phục |
|---|---|---|---|
| Nhiều dữ liệu nhưng ít biến thiên | 3 | 5.000 ảnh, một camera, không có trường hợp biên | Thu thập từ nhiều camera, địa điểm và thời điểm hơn trước khi huấn luyện |
| Nhiều biến thiên nhưng thiếu nhất quán | 5 | Người gán nhãn không thống nhất về phạm vi bbox và tình trạng che khuất | Hoàn thiện hướng dẫn, hiệu chuẩn và gán nhãn lại các mẫu bị ảnh hưởng |
| Rò rỉ âm thầm | 7 | Chia ngẫu nhiên từng ảnh trên các khung hình video | Chia lại theo clip, camera hoặc ngày; dự kiến mAP trên val sẽ giảm, vì mức giảm đó phản ánh thực tế |
Triển khai dù đã biết còn thiếu sót#
Thường thì lựa chọn phù hợp là tạo một model đầu tiên tập trung trước khi mọi kiểm tra đều đạt: một dự án thí điểm, một prototype hoặc phiên bản v1 trên một nhóm camera con. Model trong môi trường production cho thấy vấn đề thực sự nhanh hơn việc âm thầm trau chuốt dataset. Khi triển khai dù còn thiếu sót, hãy ghi lại ba điều:
- Kiểm tra nào không đạt.
- Tác động dự kiến, ví dụ: "không có dữ liệu ban đêm; dự kiến recall thấp hơn sau khi trời tối".
- Kế hoạch thu thập dữ liệu để khắc phục thiếu sót trong khi v1 đang chạy.
"Khối lượng: ngoại lệ" không cung cấp thông tin gì cho người tiếp theo. "Khối lượng: pallet ở mức 700 đối tượng, dự kiến khả năng thu hồi pallet thấp hơn trong các khu vực đông đúc; gán nhãn thêm 2.000 đối tượng trước tháng Sáu" là một rủi ro được quản lý. Mọi ngoại lệ đều cần nêu tác động dự kiến lên kiểm thử nghiệm thu.
Chạy lại trước mỗi lần huấn luyện lại#
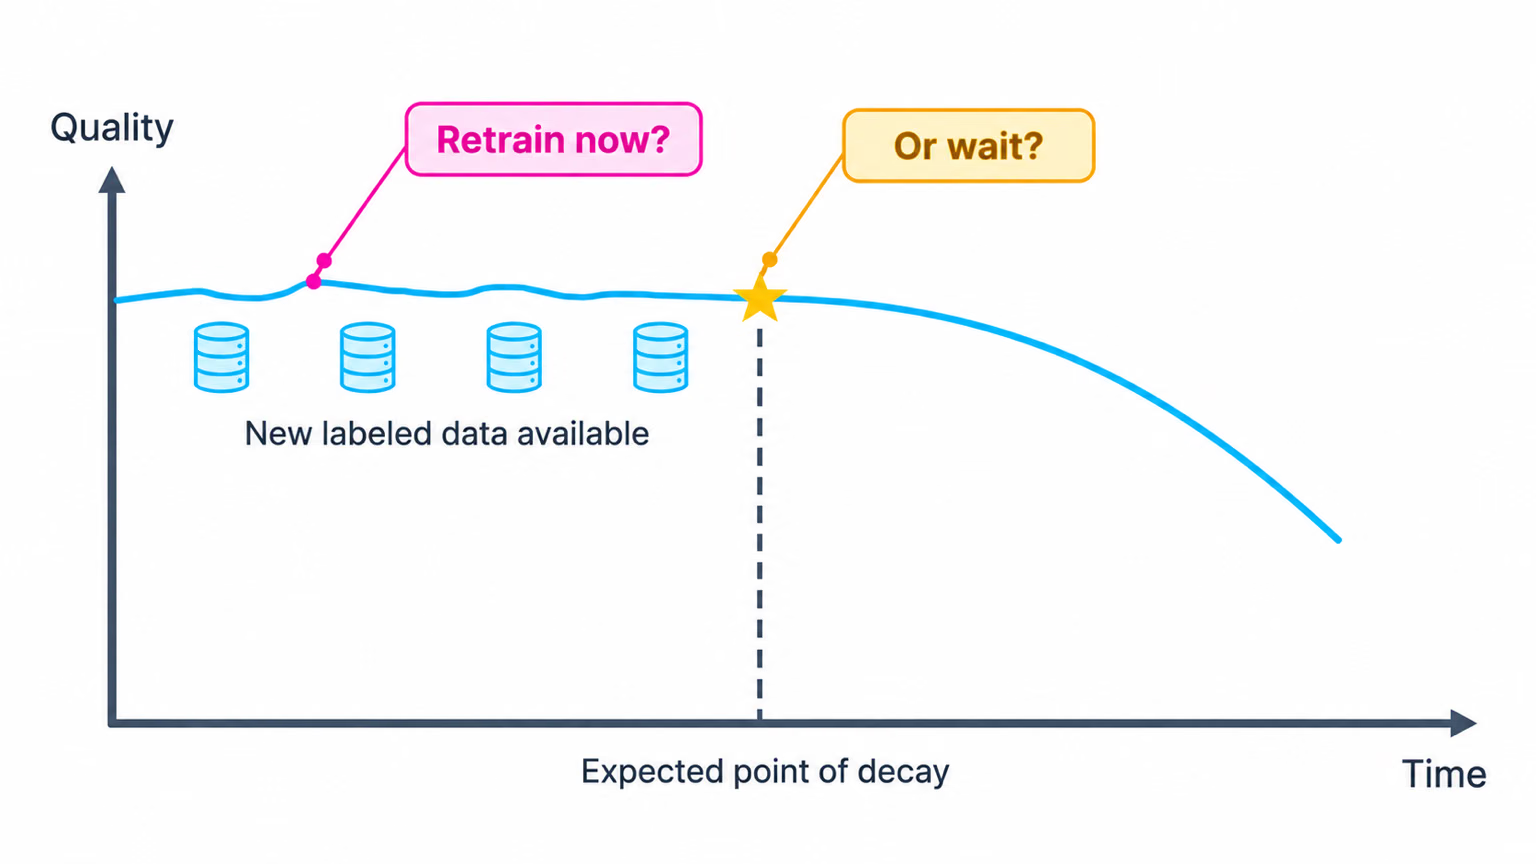
Dataset đã sẵn sàng cho v1 không tự động sẵn sàng cho v3. Lớp mới, nguồn dữ liệu mới và người gán nhãn mới đều có thể khiến một kiểm tra từng đạt nay không còn đạt, còn dữ liệu production thì trôi dạt trong khi nhãn mới liên tục được bổ sung. Chạy lại readiness.py và chấm điểm lại các kiểm tra thủ công trước mỗi lần huấn luyện lại; việc này chỉ mất vài phút, còn bỏ qua có thể khiến bạn mất cả tuần huấn luyện trên một dataset lỗi.
Hiển thị lời giải
Checklist đã chấm điểm cho tập thực hành:
| # | Bước kiểm tra | Điểm | Bằng chứng |
|---|---|---|---|
| 1 | Mục tiêu rõ ràng | có | objective.md và acceptance_test.py trong bài học 1 |
| 2 | Các lớp được định nghĩa | không | 80 tên lớp của COCO chưa có định nghĩa bằng văn bản hoặc các trường hợp tương tự cần loại trừ |
| 3 | Ảnh đại diện | không | coverage.py: cam2–cam4 chưa đạt chỉ tiêu |
| 4 | Số lượng đủ lớn | không | readiness.py: lớp yếu nhất chỉ có 1 ảnh |
| 5 | Nhãn nhất quán | không | Mức độ đồng thuận 47% trong vòng hiệu chuẩn |
| 6 | Đã hoàn tất QC | một phần | Đã chạy kiểm tra; các trường hợp nghi vấn trong 000000000438.jpg vẫn chưa được xử lý |
| 7 | Các tập dữ liệu được chia tách sạch | không | Không có nhóm trùng lặp, nhưng val thiếu 36 trong số 71 lớp |
| 8 | Ảnh nền | có | 1.6% |
Quyết định: khắc phục trước. Xếp hạng theo rủi ro đối với bài kiểm tra nghiệm thu: (1) rút gọn danh sách lớp còn những lớp cần thiết cho mục tiêu, nhờ đó thu hẹp đồng thời các kiểm tra 2, 4 và 7; (2) thu thập thêm nhóm dữ liệu cho các lớp đó; (3) hoàn thiện quy tắc trong hướng dẫn về người ở xa và gán nhãn lại. Tập dữ liệu demo không đạt kiểm tra này, và đó là điều nên xảy ra.