Chia tập dữ liệu đúng cách
Đo mức độ rò rỉ khi chia ngẫu nhiên, dùng script để chia theo các nhóm hoàn chỉnh như video, camera hoặc ngày, kiểm tra mức độ bao phủ lớp và khóa tập test.
Chia dữ liệu bất cẩn sẽ tạo ra một metric mà bạn tin là đúng nhưng thực tế lại sai. Khi các frame video liền kề xuất hiện trong cả train và val, mAP trên val đo khả năng ghi nhớ thay vì khả năng tổng quát hóa, và khoảng cách này chỉ lộ rõ khi đưa vào production. Mọi con số bạn báo cáo về model đều phụ thuộc vào cách chia này, vì vậy hãy cân nhắc kỹ một lần rồi giữ nguyên.
Thực hành
Ba tập dữ liệu, ba vai trò#
| Tập | Tỷ lệ thường dùng | Vai trò |
|---|---|---|
| Train | 70% | Model học trọng số từ tập này |
| Val | 15% | Chọn epoch tốt nhất, so sánh các lần chạy, tinh chỉnh cài đặt |
| Test | 15% | Một lần quyết định đạt/không đạt cuối cùng theo bài kiểm tra nghiệm thu |
Các hướng dẫn của Ultralytics khuyến nghị dành 70–80% cho train và 10–20% cho mỗi tập val và test: các bước của một dự án CV đề xuất 10–15% cho mỗi tập, còn hướng dẫn tiền xử lý dùng tỷ lệ 70/20/10. Hãy tính tỷ lệ theo object bên cạnh số lượng ảnh, vì một ảnh đông đối tượng có thể chứa nhiều nhãn hơn mười ảnh thưa. Tỷ lệ chính xác ít quan trọng hơn mục đích sử dụng của từng tập.
Chia ngẫu nhiên gây rò rỉ trên dữ liệu có tương quan#
Frame 124 và 125 trong cùng một video gần như giống hệt nhau. Nếu một frame vào train còn frame kia vào val, val sẽ chấm điểm trên những ảnh mà model về cơ bản đã thấy. Hãy đo trên tập thực hành từ Thu thập dữ liệu chất lượng cao, có tính đại diện, trong đó tên file bắt đầu bằng khóa nhóm camera-ngày:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainMọi nhóm camera-ngày trong val cũng xuất hiện trong train. Với video thực tế, điều đó có nghĩa là các frame val có chung điều kiện ánh sáng, phông nền và thường là cả chính các object với frame train, khiến mAP trên val rất cao nhưng mAP trên production lại không.
Chọn đơn vị chia#
Chọn nhóm phù hợp với khả năng tổng quát hóa mà môi trường triển khai yêu cầu:
Khi chưa chắc chắn, hãy chia theo đơn vị tổng quát nhất mà bạn có thể đáp ứng: cách này cho ra con số đáng tin cậy nhất. Chỉ nên chia ngẫu nhiên theo từng ảnh khi mọi ảnh là một lần chụp độc lập, chẳng hạn ảnh sản phẩm được chụp cách nhau vài tuần.
Chia theo nhóm bằng code#
Script này gán các nhóm hoàn chỉnh vào từng tập cho đến khi mỗi tập đạt tỷ lệ 70/15/15, ghi các danh sách file theo định dạng mà YAML dữ liệu chấp nhận và báo cáo mức độ bao phủ lớp:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingCách đọc kết quả:
- Theo thiết kế, không nhóm nào vượt qua ranh giới giữa các tập. Như vậy, lỗi rò rỉ đã được khắc phục.
- Val chỉ có 2 nhóm và thiếu 36 lớp, nên không thể đo AP cho các lớp đó. Với 71 lớp trong 128 ảnh, không seed nào khắc phục được vấn đề này; giải pháp thực sự là bổ sung nhóm (thêm camera hoặc ngày), như dataset production có hơn 1.500 ảnh cho mỗi lớp.
- Train thiếu 5 lớp chỉ xuất hiện trong val hoặc test. Model không thể học các lớp này từ cách chia hiện tại.
Quy tắc quyết định: khi một lớp không có trong một tập, hãy thêm hoặc chuyển toàn bộ nhóm chứa lớp đó, tuyệt đối không chuyển các frame riêng lẻ, vì làm vậy sẽ khiến lỗi rò rỉ xuất hiện trở lại. Trỏ các khóa train, val và test trong YAML dữ liệu tới ba file .txt; Tạo YAML cho dataset hướng dẫn các phần còn lại của file.
Cân bằng lớp giữa các tập#
Với bài toán phân loại, train_test_split(..., stratify=labels) của scikit-learn giữ tỷ lệ lớp bằng nhau giữa các tập chỉ với một đối số. Ảnh detection có thể chứa nhiều lớp cùng lúc, vì vậy hãy cân bằng ở cấp nhóm: sau group_split.py, so sánh số lượng từng lớp giữa các tập và hoán đổi các nhóm hoàn chỉnh cho đến khi mọi lớp nằm trong khoảng ±20% so với tỷ lệ dự kiến.

Trên Ultralytics Platform, Redistribute Splits gán lại ảnh một cách ngẫu nhiên, còn Auto đặt tỷ lệ train/val được khuyến nghị là 80/20 (tài liệu về chia tập). Tính năng này loại bỏ các ảnh trùng lặp chính xác trong quá trình xử lý nhưng không nhận biết được nhóm của bạn, vì vậy hãy dùng cho các lần chụp độc lập và tải lên các tập đã chia theo nhóm đối với dữ liệu video hoặc nhiều camera.
Theo dõi riêng hai tập val#
Thông thường, bạn cần hai tập val: một bộ kiểm thử hồi quy ổn định, được tuyển chọn kỹ và một tập phản ánh thực tế production, được cập nhật luân phiên bằng các frame mới thu thập. YAML dữ liệu chấp nhận danh sách thư mục val, nhưng sẽ gộp chúng thành một tập val duy nhất với một điểm số:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Để xem điểm số riêng của từng tập, hãy duy trì một YAML dữ liệu cho mỗi tập val (cùng train và names, khác val) và đánh giá trọng số đã train trên từng tập:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Điểm giảm trên tập được tuyển chọn là dấu hiệu hồi quy; điểm giảm trên tập production là dấu hiệu dịch chuyển miền.
Khóa tập test#
Sai lầm chia tách tốn kém nhất là so sánh mười biến thể model trên tập test. Một khi test đã ảnh hưởng đến bất kỳ quyết định nào, con số cuối cùng sẽ lạc quan hơn thực tế. Hãy tinh chỉnh và so sánh các lần chạy trên val, rồi chỉ chạy kiểm thử nghiệm thu trên test một lần vào cuối cùng.
Mọi metric bạn công bố đều gắn với lần chia tách này. Xáo trộn lại sau đó sẽ thay đổi mọi con số và khiến các lần chạy cũ, mới không thể so sánh. Hãy lưu đơn vị chia tách, seed và ba danh sách file cùng với dataset.
Cross-validation K-fold cho dataset nhỏ#
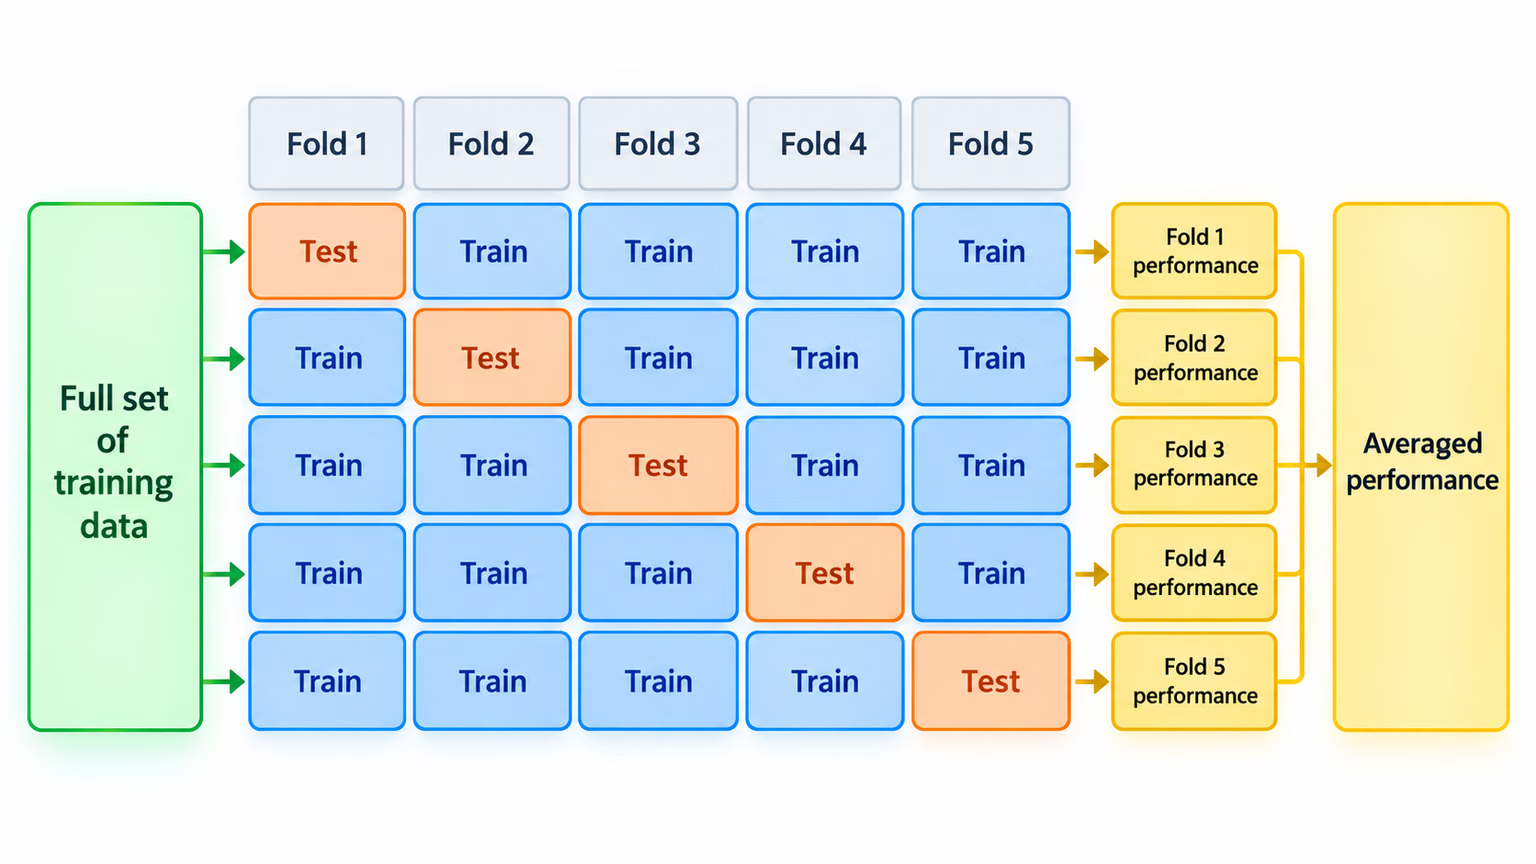
Khi dataset nhỏ (dưới khoảng 500 ảnh mỗi lớp) và một lần chia duy nhất có vẻ thiếu cơ sở thống kê, cross-validation K-fold sẽ train k model trên các tập được xoay vòng rồi tính trung bình kết quả: tốn gấp k lần tài nguyên tính toán nhưng cho ước lượng ổn định hơn nhiều. Hãy tạo các fold từ nhóm theo cách tương tự, nếu không mọi fold đều bị rò rỉ.
Hiển thị lời giải
Với camera nhà kho cố định cần tiếp tục hoạt động tốt trong những ngày mới, hãy chia theo camera-ngày: cam2_2026-05-01. Sau group_split.py, xác minh rằng không nhóm nào vượt qua ranh giới giữa các tập:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneCách chia tập thực hành vượt qua kiểm tra rò rỉ nhưng không đạt kiểm tra bao phủ: val thiếu 36 trong số 71 lớp. Giải pháp là lập kế hoạch thu thập dữ liệu, không phải xáo trộn lại. Thu thập ít nhất hai camera-ngày bổ sung cho val và test, mỗi lượt bao phủ các lớp quan trọng nhất theo đặc tả, rồi chạy lại cả hai script.