Qualität der Annotationen
Finde heraus, was ein YOLO-Label enthält, prüfe Labeldateien auf fehlerhafte Zeilen und sorge mit einer Richtlinie und einer messbaren Kalibrierungsrunde für einheitliche Annotationen.
Ein Modell, das mit uneinheitlichen Labels trainiert wird, lernt die Uneinheitlichkeit. Fünfzigtausend Boxen, die nach einer klaren Regel gezeichnet wurden, sind besser als eine halbe Million Boxen, die auf zwanzig individuellen Auslegungen beruhen. Außerdem ist eine erneute Annotation fast immer günstiger als ein größeres Modell. In dieser Lektion erhältst du ein Prüfskript für Labels, eine einseitige Richtlinie und einen Messwert für die Übereinstimmung der Annotierenden.
Praxisnah
Was ein Label tatsächlich ist#
Im YOLO-Format hat jedes Bild eine passende Datei .txt mit einer Zeile pro Objekt. Die Koordinaten werden anhand von Bildbreite und -höhe auf den Bereich 0–1 normiert, sodass die Labels beim Skalieren erhalten bleiben. Das Zeilenformat hängt von der Aufgabe ab:
| Aufgabe | Ein Label | Hinweise |
|---|---|---|
| Detektion | class x_center y_center width height | Mittelpunkt und Größe der Box |
| Instanzsegmentierung | class x1 y1 x2 y2 ... xn yn | Polygonumriss |
| Pose | class x y w h px1 py1 v1 ... pxn pyn vn | Box, dann Keypoints mit optionaler Sichtbarkeit |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Vier Ecken der gedrehten Box |
| Klassifizierung | Keine Labeldatei | Bilder, sortiert in je einen Ordner pro Klasse |
| Semantische Segmentierung | Eine PNG-Maske pro Bild | Jeder Pixelwert entspricht einem Klassenindex |
| Tiefenschätzung | Eine Tiefen-PNG- oder NPY-Datei pro Bild | Jeder Pixelwert entspricht einer Entfernung |
Klassenindizes beginnen bei 0 und verweisen auf die Namen in der YAML-Datei des Datensatzes. Ein Bild ohne Objekte benötigt keine Labeldatei – so funktionieren Hintergrundbilder. Auf den Seiten zu Erkennungsformaten, semantischer Segmentierung und Tiefendaten findest du Beispiele.
Prüfe deine Labeldateien#
Fehlerhafte Zeilen schlagen unbemerkt durch: Eine Koordinate über 1, eine Klassen-ID, die in der YAML-Datei nicht definiert ist, oder dasselbe Objekt, das zweimal umrahmt wurde, wird zu Rauschen, das das Modell zu lernen versucht. Ein kurzes Prüfskript findet solche Fehler vor dem Training:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesDas manuell erstellte Beispiel zeigt jeden Fehler, den das Prüfskript findet; der echte Datensatz besteht die Prüfung ohne Beanstandungen. Führe das Skript nach jedem Beschriftungsdurchgang und vor jedem Trainingslauf aus – das dauert nur Sekunden.
Warum Labels uneinheitlich werden#
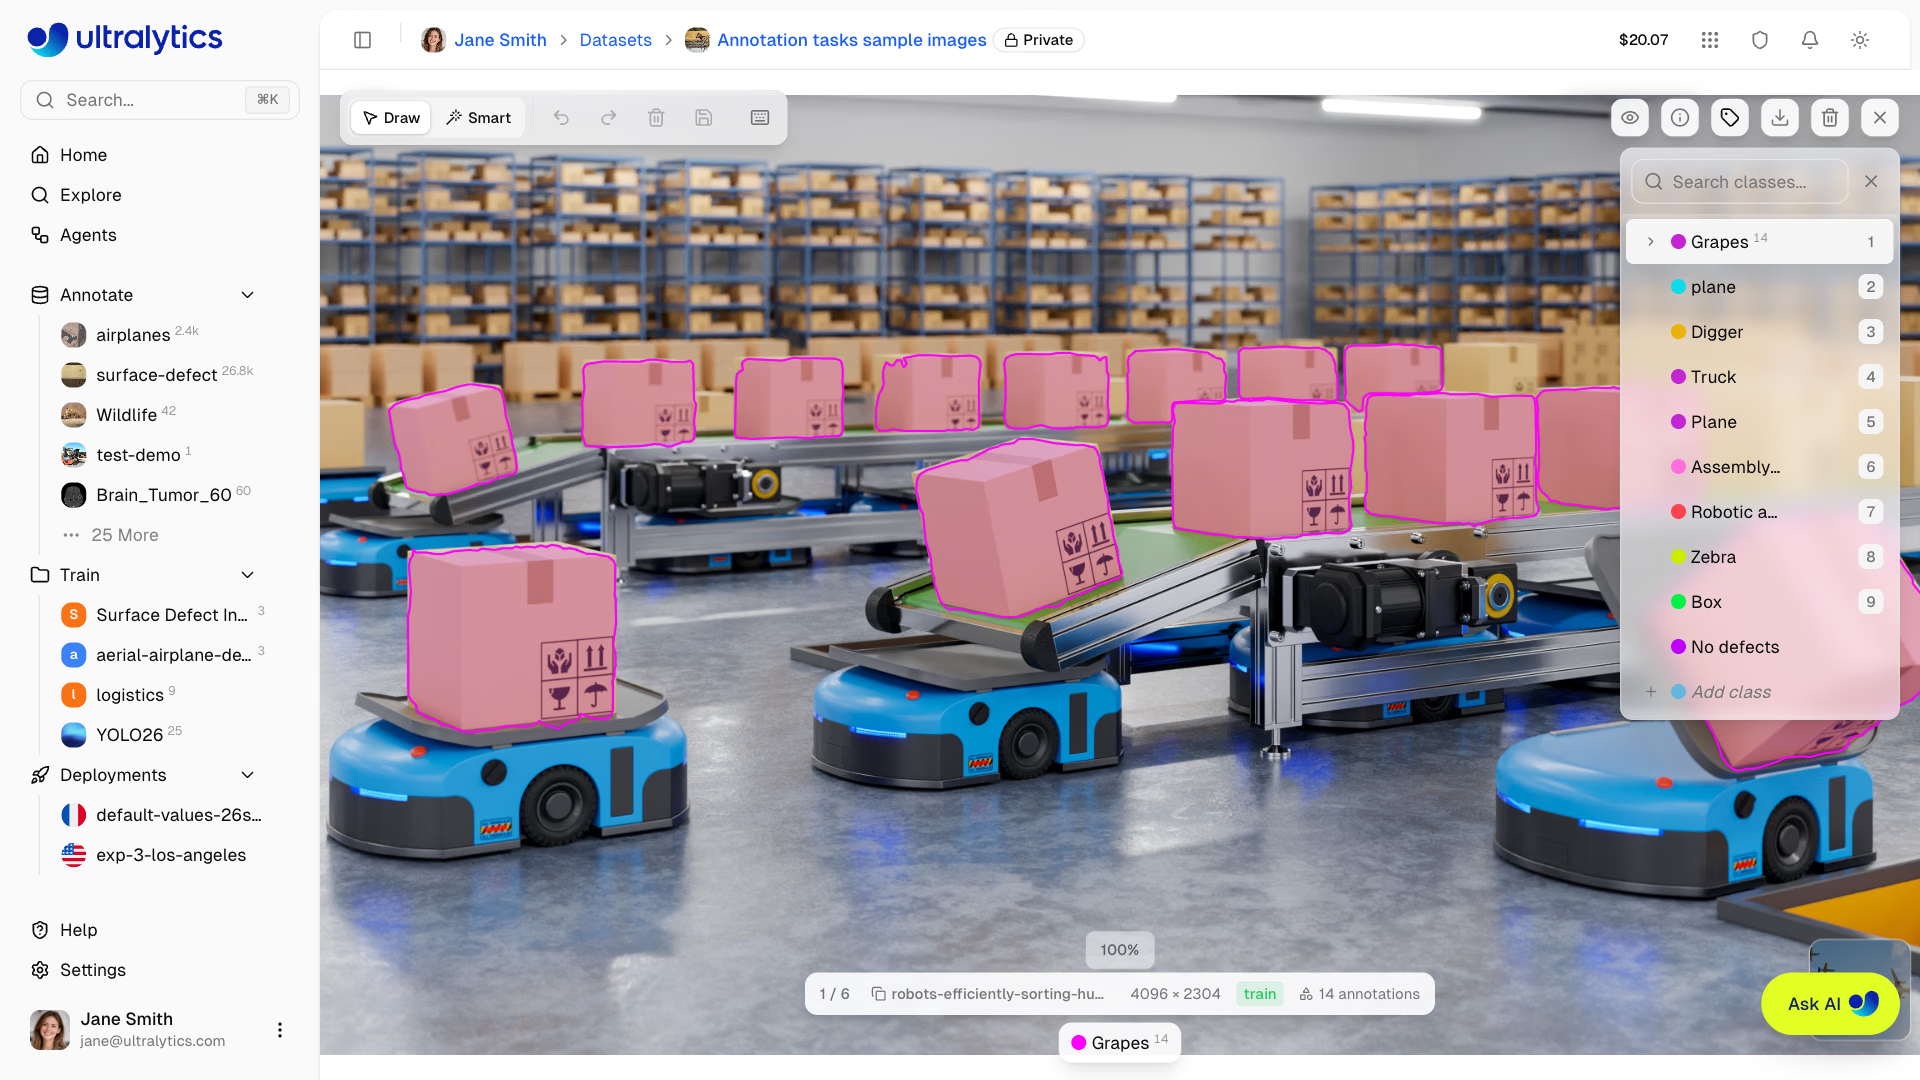
Sieh dir das Klassenfeld in diesem Editor an: Die 14 Kartonpolygone sind unter Grapes gespeichert, während eine Klasse Box weiter unten in der Liste steht – und plane und Plane als zwei separate Klassen existieren. Ein Prüfskript kann keines der beiden Probleme erkennen, weil jede Zeile gültig ist. Eine prüfende Person, die die Labels mit der Richtlinie abgleicht, würde jedoch beide in wenigen Sekunden entdecken. Die meisten Label-Fehler sind solcher Art: gültige Dateien, falsche Entscheidungen.
Annotierende beschriften selten aus Nachlässigkeit schlecht. Ihre Annotationen sind uneinheitlich, weil die Regeln mehrdeutig sind und jede Person eine plausible, aber andere Entscheidung trifft:
- Wo endet die Box? Am Schatten, an einer getragenen Tasche oder an der Ladung auf den Gabeln eines Gabelstaplers?
- Abgeschnittene Objekte. Ist eine Person, die zur Hälfte außerhalb des Bildrands liegt, noch ein
person? Ab welchem sichtbaren Anteil? - Verdeckung. Wird ein Auto, von dem nur ein Rad zu sehen ist, annotiert oder ausgelassen?
- Klassengrenzen. Ist ein Pick-up ein
caroder eintruck? Ist ein Motorroller einbicycleoder einother? - Nicht zu annotierende Fälle. Spiegelungen, Poster und Bildschirme, auf denen das Objekt zu sehen ist.
Jede Entscheidung ist in Ordnung, solange alle dieselbe treffen.
Eine einseitige Richtlinie#
Sie passt auf eine Seite, enthält ein Beispielbild für jede Regel und stellt die Grenzfälle an den Anfang:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Übereinstimmung in einer Kalibrierungsrunde messen#
Bevor du von einer auf zwanzig annotierende Personen aufstockst, lässt du alle dieselben 50 Bilder annotieren und vergleichst die Ergebnisse:
Die Übereinstimmung entspricht dem Anteil der Objekte, die beide Annotierenden derselben Klasse zugeordnet und mit einem IoU von mindestens 0.5 eingezeichnet haben – eine praktische Variante der Übereinstimmung zwischen Beurteilenden:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%In den 67 % verbergen sich zwei Arten von Uneinigkeit. Bobs Box um den Gabelstapler beginnt 80 Pixel höher – er hat die Mastspitze einbezogen –, stimmt aber bei einem IoU von 0.83 dennoch überein und zählt daher als Übereinstimmung; verschärfe die Box-Regel, wenn dein Produkt die Höhe misst. Beim dritten Objekt liegt ein echter Konflikt vor: Alice sagt person, Bob sagt pallet_jack. Dafür braucht es eine klarere Regel und ein Beispielbild, danach folgt eine weitere Runde. Behalte die 50 Kalibrierungsbilder: Sie werden zum Einarbeitungstest für alle neuen Annotierenden.
Wenn Prüfende Kennzeichnungen stillschweigend korrigieren, geht die Rückkopplung verloren und die Annotierenden erfahren nie, was sie falsch gemacht haben. Lehne die Kennzeichnung mit einer Begründung ab und lass die annotierende Person sie korrigieren. Bei den ersten hundert Bildern dauert es länger, danach geht es deutlich schneller.
Was du erfassen solltest#
| Messwert | Was er aussagt |
|---|---|
| Durchsatz (Objekte pro Stunde) | Kapazität und Kosten |
| Ablehnungsquote | Ob die Qualität nachlässt |
| Übereinstimmung bei einer gemeinsamen Überlappungsmenge | Ob die Annotierenden weiterhin dieselben Regeln anwenden |
Wenn die Übereinstimmung sinkt, hat sich etwas geändert: eine neue annotierende Person, eine neue Kamera, ein mehrdeutiger Stapel oder Ermüdung. Wenn das Modell später unter einer bestimmten Bedingung versagt, schick genau diese Bilder erneut durch die Annotation – die Schleife, die aktives Lernen automatisiert und aus der die meisten Genauigkeitsgewinne in der Praxis stammen. Durchsuche und filtere Fehler in deinen Datensätzen auf der Ultralytics Platform. In Qualitätskontrolle von Datensätzen und Bewährte Verfahren für Annotationen erfährst du, wie du das in großem Maßstab umsetzt.
Lösung anzeigen
Eine Richtlinie für die Klasse pill von medical-pills, erstellt nach einer Kalibrierungsrunde mit 10 Bildern:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
So liest du den Übereinstimmungswert: Angenommen, die erste Runde ergibt 82 %. Sortiere die nicht übereinstimmenden Objekte nach Ursache. Bei Blisterpackungen sind die beiden häufigsten Ursachen: Boxen, die um die Kunststoffblase statt um die Tablette gezeichnet wurden (behoben durch die erste Box-Regel und ein Beispielbild), und durch Blendung verdeckte Tabletten, die eine annotierende Person ausgelassen hat (behoben durch die zweite Einschlussregel). Wiederhole den Test mit 10 neuen Bildern; weite den Umfang erst aus, wenn der Wert die Schwelle von 90 % überschreitet.