Boxen oder Masken: Wann du wirklich Segmentierung brauchst
Miss anhand eines echten Bildes, welchen Mehrwert eine Maske gegenüber einer Box bietet, und entscheide anhand der nachgelagerten Anwendung, ob dein Projekt überhaupt die Form benötigt.
Wenn die meisten Menschen an KI-Bildverarbeitung denken, stellen sie sich Masken vor. Zugleich verschlingen Masken den größten Teil des Budgets für die Beschriftung. Eine Maske zeigt die genaue Form eines Objekts; eine Box zeigt nur seine Position. Dieser Unterschied entscheidet bei manchen Produkten über alles – bei den meisten anderen ändert er nichts.
Praxisnah
Was eine Maske zusätzlich bietet#
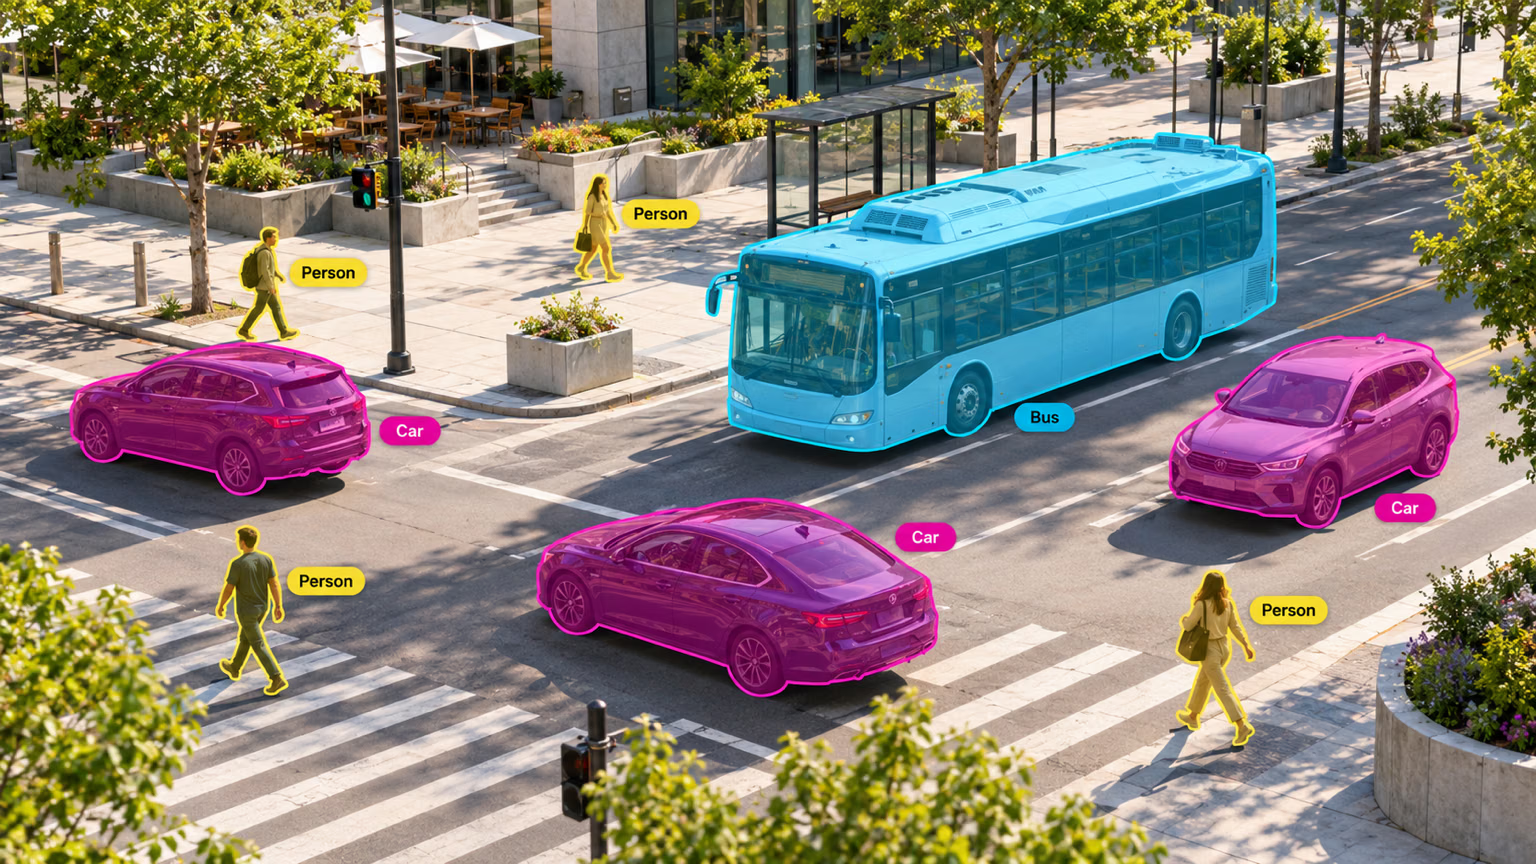
Für jedes Objekt liefert die Segmentierungsaufgabe alles, was auch ein Detektor liefert – Klasse, Box und Konfidenz – sowie die zum Objekt gehörenden Pixel. Deshalb erhält jedes Auto oben eine eigene Kontur, getrennt vom Bus und den Menschen. Lies die Maske als Polygon (masks.xy) oder als Binärbild (masks.data) aus.
Wie stark verändert die Form die Messwerte? Vergleiche für jedes Objekt die Fläche seiner Box mit der Fläche seiner Maske:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)Der Bus füllt nur 62 % seiner Box aus, eine Person sogar nur 31 %. Jede Zahl, die allein anhand von Boxen berechnet wird – gestrichene Fläche, Größe einer Verschüttung, freie Fläche eines Regals – läge um diesen Anteil daneben. Wenn dein Produkt solche Zahlen ausgibt, brauchst du Masken. Wenn es nur zählt oder Positionen bestimmt, ändern die zusätzlichen Pixel nichts.
Symptom: Maskenflächen wirken 3–4× kleiner als Boxflächen. Ursache: Standardmäßig wird masks.data in der Größe der Inferenz zurückgegeben (hier 640×480), während die Boxen in Pixeln des Originalbilds angegeben sind (1080×810). Lösung: Übergib wie oben retina_masks=True oder skaliere die Werte selbst.
Entscheide anhand der nachgelagerten Anwendung, nicht anhand der Demo#
| Anforderung der nachgelagerten Anwendung | Reichen Boxen aus? | Warum |
|---|---|---|
| Objekte zählen oder ihre Anwesenheit prüfen | Ja | Die Position ist die vollständige Antwort |
| Warnen, wenn ein Objekt in eine Zone eintritt | Ja | Es reicht, wenn eine Box eine Linie überquert |
| Objekte über mehrere Frames hinweg verfolgen | Ja | Tracker ordnen Boxen einander zu |
| Zuschnitt für einen zweiten Klassifikator | Ja | Für einen Zuschnitt genügt die Box |
| Fläche oder Abdeckung messen (Unkraut, Rost, Verschüttungen) | Nein | Bei unregelmäßigen Formen ist die Boxfläche bedeutungslos |
| Objekt freistellen (Hintergrund entfernen, AR) | Nein | Du brauchst die exakte Kante |
| Abstand oder Kontakt prüfen (Robotergreifen, Kollision) | Nein | Die Box überschätzt die Größe des Objekts |
| Sich berührende, unregelmäßige Objekte voneinander trennen | Oft nicht | Überlappende Boxen verwischen die Zuordnung der Pixel zu den einzelnen Objekten |
Wenn in jeder Zeile, die für dein Produkt relevant ist, „ja“ steht, setze einen Detektor ein. Greife nur dann zu YOLO26-Segmentierung, wenn die Form den zusätzlichen Aufwand rechtfertigt.
Instanz- und semantische Segmentierung#
Bei der Instanzsegmentierung erhält jedes Objekt seine eigene Maske, sodass drei überlappende Autos weiterhin drei Autos bleiben. Die semantische Segmentierung kennzeichnet jedes Pixel nur mit einer Klasse: Alle Pixel von Autos bilden eine einzige „Auto“-Region, und die Anzahl geht verloren. Zähle oder vermesse einzelne Objekte – etwa Zellen, Früchte oder Defekte – mit Instanzsegmentierung. Miss die Abdeckung einer Region – etwa Straße im Vergleich zum Gehweg oder Feldfrucht im Vergleich zum Boden – mit semantischer Segmentierung.
Was die Beschriftung von Formen kostet#
Für eine Box genügen zwei Klicks. Ein gutes Polygon kann Dutzende Klicks erfordern, und bei jeder Kante kann es zu unterschiedlichen Einschätzungen kommen: Gehört die Tasche zur Person? Ist der Schatten Teil des Autos? Ermittle deine eigenen Kosten, statt einer Faustregel zu vertrauen: Miss die Zeit, die eine annotierende Person für 20 Objekte als Boxen und dieselben 20 Objekte als Polygone benötigt, und multipliziere die Differenz mit dem Umfang deines Datensatzes.
Werkzeuge mit KI-Unterstützung verringern den Unterschied erheblich. Intelligente Annotation und Stapelbeschriftung schlagen anhand eines Klicks oder einer Box eine Maske vor. So korrigieren annotierende Personen die Kanten, statt sie nachzuzeichnen – dennoch muss jemand jede Begrenzung überprüfen.
Lege vor Beginn der Kennzeichnung fest, wie mit Verdeckungen, transparenten Objekten, Schatten, am Bildrand abgeschnittenen Objekten und angehängten Gegenständen (Taschen, Griffen, Lasten) umzugehen ist. Gib den Annotierenden und Prüfenden dieselbe Dokumentation. Bewährte Verfahren zur Annotation beschreibt, wie du diese Regeln durchsetzt; der COCO-Seg-Datensatz zeigt konsistente Masken in großem Umfang.
Achte bei Stichprobenkontrollen von Masken auf Überstände (die Maske reicht über die Kante hinaus), Löcher (fehlende Bereiche innerhalb des Objekts), Schein-Kanten (die Maske folgt einem JPEG-Artefakt) und unklare Teile (gehört der Koffergriff zur Koffermaske?).
Lösung anzeigen
Angenommen, zwei Produkte nutzen dieselbe Buskamera: ein Fußgängerzähler und ein Bericht zur Flächennutzung auf der Straße, der angibt, wie viel der Szene von Fahrzeugen bedeckt ist. Miss beide Werte anhand desselben Durchlaufs:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- Fußgängerzähler → Boxen. Die Anzahl beträgt in beiden Fällen 4; Masken erhöhen den Beschriftungsaufwand, ändern aber nichts.
- Bericht zur Flächennutzung → Masken. Laut den Boxen bedeckt der Bus 47 % der Szene; tatsächlich sind es 29 %. Ein Bericht auf Grundlage von Boxen läge um mehr als die Hälfte daneben.