Datensätze, die die Realität abbilden
Prüfe einen echten Datensatz auf Abdeckungslücken, bevor du weitere Bilder labelst, und leite daraus mit schwierigen Negativbeispielen einen Erfassungsplan ab.
Die meisten enttäuschenden Bildverarbeitungsmodelle sind keine schlechten Modelle – es sind gute Modelle, die mit einem Datensatz trainiert wurden, der nicht dem Einsatzort entspricht. Der COCO-Detektor aus der vorherigen Lektion fand auf einer Drohnenaufnahme keine Boote, weil Boote in COCO von der Seite fotografiert sind. Ein fünfminütiges Audit deckt solche Lücken auf, bevor du Geld für Labels ausgibst.
Praxisnah
Modelle lernen den Datensatz, nicht die Welt#
Ein Modell interpoliert zwischen den Beispielen, die es gesehen hat. Trainierst du es mit sonnigen Straßen am Tag und setzt es nachts in einer nebligen Garage ein, versagt es – nicht, weil Autos anders aussehen, sondern weil das Modell noch nie ein Auto unter diesen Bedingungen gesehen hat. Diese Abweichung heißt Domänenverschiebung. Mit der Validierung lässt sie sich nicht aufdecken, wenn die Validierungsbilder aus derselben verzerrten Sammlung stammen:
Die Lösung ist strukturell, nicht algorithmisch: Erfasse gezielt Bilder aus der späteren Einsatzumgebung, bevor du sie labelst. Der Leitfaden zur Datenerfassung und Annotation beschreibt die praktische Umsetzung.
Einen echten Datensatz prüfen#
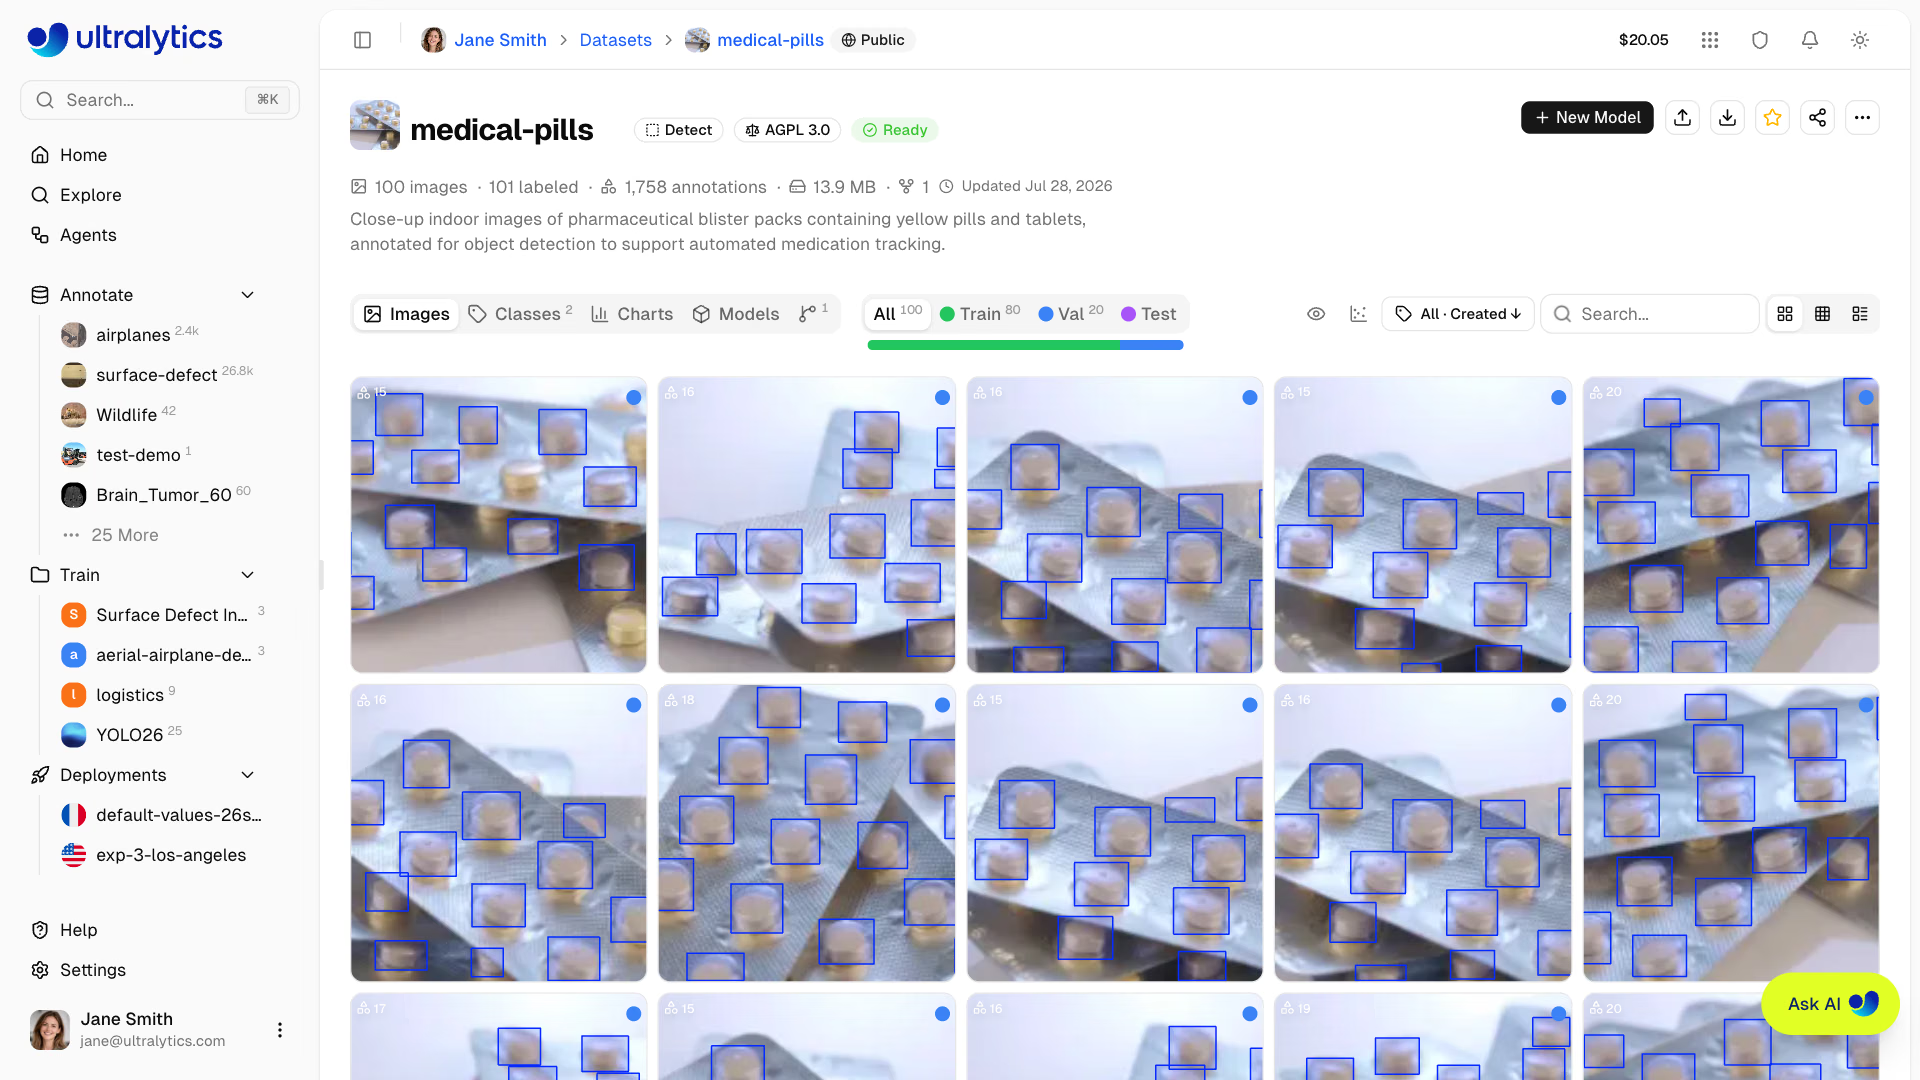
Der oben gezeigte Datensatz medical-pills – Nahaufnahmen von Blisterpackungen, bei denen jede Pille mit einer Box markiert ist – eignet sich gut für eine Prüfung. Die Ultralytics Platform zeigt die wichtigsten Kennzahlen auf der Datensatzseite an. Das folgende Skript berechnet die Zahlen, die Aufschluss über die Abdeckung geben, anhand der mit ultralytics ausgelieferten Kopie:
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)Lies die Ergebnisse als Abdeckungsbericht, mit einem Befund pro Zeile:
| Befund | Bedeutung | Maßnahme |
|---|---|---|
| Eine Auflösung, 1920×1080 | Eine Kamera, ein Aufbau | Erfasse Bilder von jedem Kameramodell, das du einsetzen wirst |
| Helligkeit nur zwischen 171 und 198 | Helles, gleichmäßiges Studiolicht, keine dunklen Aufnahmen | Erfasse dunkle, von hinten beleuchtete und gemischt beleuchtete Aufnahmen, bevor du das Modell an einer Apothekentheke einsetzt |
| 0 Hintergrundbilder | Das Modell sieht nie eine Szene ohne Pillen | Füge leere Blisterpackungen, andere Tabletten und leere Theken als schwierige Negativbeispiele hinzu |
| Die mittlere Box ist 1,4 % der Bildfläche groß; jede fünfte Box ist kleiner als 1 % | Kleine Objekte | Wähle imgsz groß genug und beziehe gezielt Aufnahmen aus größerer Entfernung ein |
Eine Klasse, pill | Keine Pillensorten | Für das Zählen ausreichend; füge nur dann Klassen hinzu, wenn eine Entscheidung sie erfordert |
Nichts davon schlägt sich im Validierungsergebnis nieder, weil die Validierungsdaten all diese Merkmale teilen.
Die vier Dimensionen der Abdeckung#
| Dimension | Was erfasst werden sollte | Typischer Fehler bei fehlender Abdeckung |
|---|---|---|
| Beleuchtung | Morgendämmerung, Mittag, Abenddämmerung, Nacht, Blendung, Gegenlicht, flackernde Leuchtstofflampen | Die Trefferquote bricht bei Schichtwechseln oder direkter Sonneneinstrahlung ein |
| Wetter und Atmosphäre | Regen, Nebel, Schnee, Staub, Kondensation auf der Linse | Fehlalarme bei Wassertropfen, Erkennungsfehler bei Dunst |
| Verdeckung und Bildunordnung | Teilweise verdeckte Ziele, überfüllte Szenen, Objekte, die am Bildrand abgeschnitten sind | Objekte werden übersehen, sobald sie nicht vollständig sichtbar sind |
| Kamera und Perspektive | Objektiv, Montagehöhe und -winkel, Auflösung, Komprimierung, Bewegungsunschärfe | Funktioniert mit der Pilotkamera, versagt am nächsten Standort |
Die Perspektive ist die Dimension, die im Beispiel mit dem Yachthafen fehlte: Dieselbe Klasse aus einem neuen Blickwinkel, und die Trefferquote sank auf null.
Schwierige Negativbeispiele und Hintergrundbilder#
Ein Detektor muss auch lernen, was nicht das Ziel ist. Schwierige Negativbeispiele sehen dem Ziel auf den ersten Blick ähnlich: bei einem Gabelstaplerdetektor etwa ein Hubwagen, eine Scherenhebebühne, die Spiegelung eines Gabelstaplers auf einem polierten Boden oder ein Sicherheitsplakat mit dem Bild eines Gabelstaplers.
Im YOLO-Format ist ein Hintergrundbild einfach ein Bild ohne Labeldatei – es gibt nichts einzuzeichnen. Die Trainingstipps von Ultralytics empfehlen etwa 0–10 % Hintergrundbilder, um Fehlalarme zu verringern; COCO selbst enthält ungefähr 1 %. Fülle diesen Anteil mit schwierigen Negativbeispielen aus deiner eigenen Umgebung statt mit beliebigen leeren Bildern. Mit Datenerweiterung lassen sich Helligkeit und Winkel variieren, aber sie kann keinen Hubwagen erzeugen, den das Modell noch nie gesehen hat.
Stolperfallen#
Symptom: 10.000 gekennzeichnete Bilder, alle bei Tageslicht und alle von der Pilotkamera. Lösung: Nimm ein paar Wochen lang Bilder von den Einsatzkameras unter dem gesamten Spektrum an Bedingungen auf, prüfe die Abdeckung und erst dann bezahlst du für die Kennzeichnung. Synthetische Daten können eine bekannte Lücke schließen, ersetzen aber keine echten Aufnahmen.
Symptom: Hoher mAP auf der Validierung, schlechte Ergebnisse am ersten neuen Standort. Lösung: Bedenke, dass die Validierung dieselben blinden Flecken wie der Datensatz hat. Nimm zehn zufällige Trainingsbilder und zehn Produktionsbilder und bitte ein Teammitglied, sie auseinanderzuhalten. Gelingt das, liegt eine Domänenverschiebung vor.
Für einen Stichprobenplan mit Zielzahlen pro Bedingung geht es weiter mit Hochwertige, repräsentative Daten sammeln in Leistungsstarke YOLO-Datensätze erstellen.
Lösung anzeigen
Für medical-pills, das unter gemischter Ladenbeleuchtung auf einer Apothekentheke eingesetzt wird, füllst du die Matrix anhand des Audits (Helligkeit 171–198, eine Quelle mit 1920×1080, keine Hintergründe) und eines kurzen Durchblätterns der Bilder aus. Dabei sind dieselben Packungen auf derselben hellen Fläche zu sehen, ohne Hände:
| Klasse | Helles Studiolicht | Gedämpftes oder warmes Ladenlicht | Gegenlicht / Blendung | Teilweise von einer Hand verdeckt | Handykamera |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| Hintergrund | 0 | 0 | 0 | — | 0 |
Nach Priorität geordneter Sammelplan:
- Gedämpftes oder warmes Ladenlicht — die übliche Beleuchtung an der Theke, derzeit mit null Bildern.
- Teilweise von einer Hand verdeckt — das passiert bei fast jeder echten Interaktion.
- Handykamera — ein zweiter Sensor und eine andere Auflösung.
- Gegenlicht / Blendung — Folienpackungen spiegeln Fenster und Deckenleuchten.
Schwierige Negativbeispiele: leere Blisterpackungen (dieselbe Folie, keine Tabletten) und andere runde Gegenstände auf der Theke — Münzen, Knöpfe, Süßigkeiten. Füge sie als Hintergrundbilder hinzu; sie sollten etwa 5–10 % des Datensatzes ausmachen.