Intelligente Annotation und Batch-Labeling
Wähle ein Labeling-Modell und eine Konfidenzschwelle, indem du den Prüfaufwand misst. Führe anschließend Batch Annotation aus und überprüfe das Ergebnis anhand der Bearbeitungsrate.
Von Hand gezeichnete Boxen schaffen vielleicht 100 Bilder pro Stunde; gute vorab erstellte Labels lassen sich oft um ein Mehrfaches schneller prüfen. Mit einer falschen Konfidenzschwelle kann ein Labeling-Modell aber mehr Arbeit verursachen, als es einspart. Und wenn du seine Vorhersagen ungeprüft lässt, lernt dein nächstes Modell daraus dieselben Fehler. In dieser Lektion misst du den Prüfaufwand bei jeder Schwelle anhand bereits gelabelter Daten. So kannst du die Schwelle anhand von Zahlen statt nach Gefühl auswählen.
Praxisnah
Drei Möglichkeiten für vorab erstellte Labels#
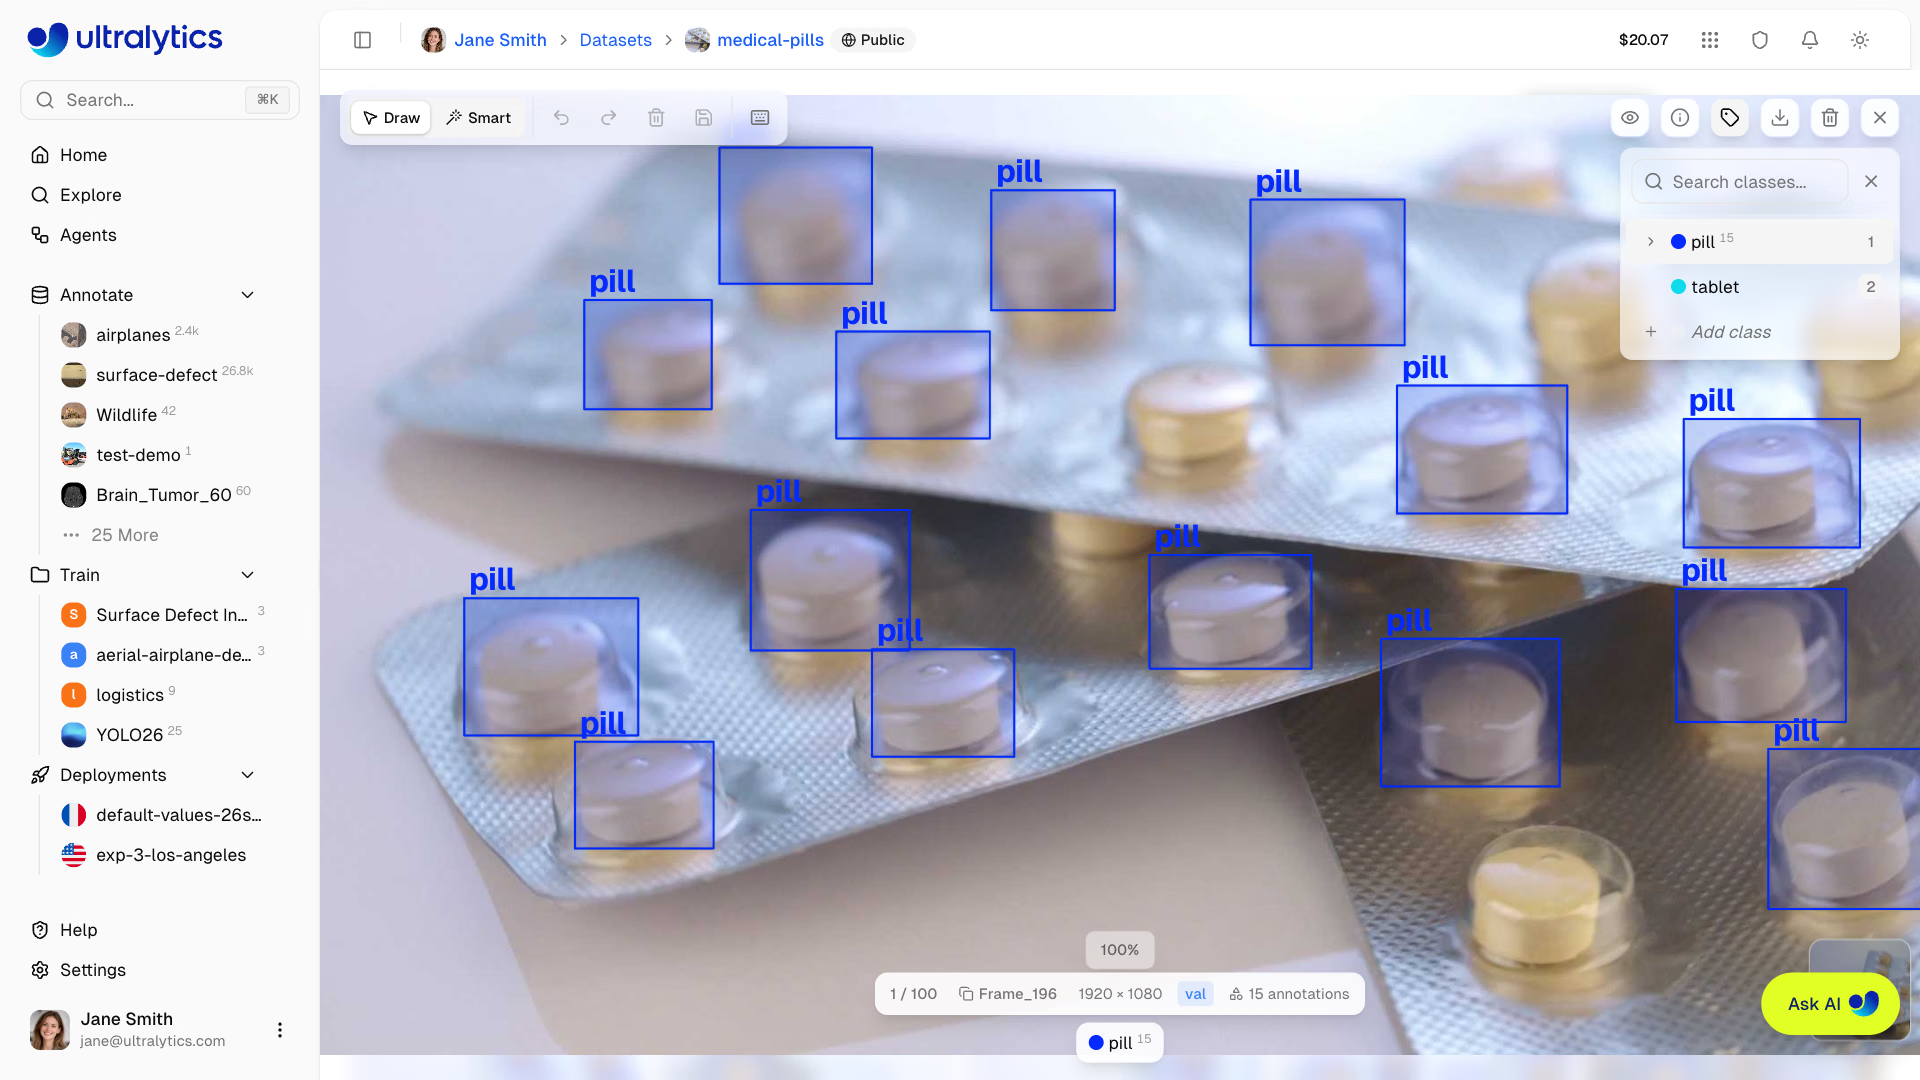
Im Annotationseditor ist Draw mode (V) der manuelle Modus. In Smart mode (S) schlägt ein Modell Labels vor:
| Familie | Funktionsweise | Aufgaben | Kosten |
|---|---|---|---|
| SAM (SAM 2.1 Tiny bis Large, SAM 3, SAM 3.1 als Standard) | Klicke auf ein Objekt, um eine Maske zu erstellen; klicke außerhalb, um etwas hinzuzufügen, und innerhalb, um etwas abzuziehen; A schaltet die automatische Anwendung um | Erkennung, Segmentierung, semantische Segmentierung, OBB | Free |
| YOLO (offizielle Modelle oder eigene Modelle) | Predict fügt die Erkennungen des Modells hinzu; „Map classes“ ordnet die Modellklassen den Datensatzklassen zu; Duplikate mit IoU ab 0.7 werden übersprungen | Erkennung, Segmentierung, semantische Segmentierung, OBB, Pose | Im Editor kostenlos |
| Klassenabfrage (Moondream 3.1 als Standard, YOLOE-26x, SAM 3 Text und weitere) | Findet die Klassennamen des Datensatzes im Bild; kostenpflichtige Anbietermodelle werden mit deinem eigenen API-Schlüssel ausgeführt | Erkennungsdatensätze mit 1–200 Klassen | Gehostete Modelle kostenlos |
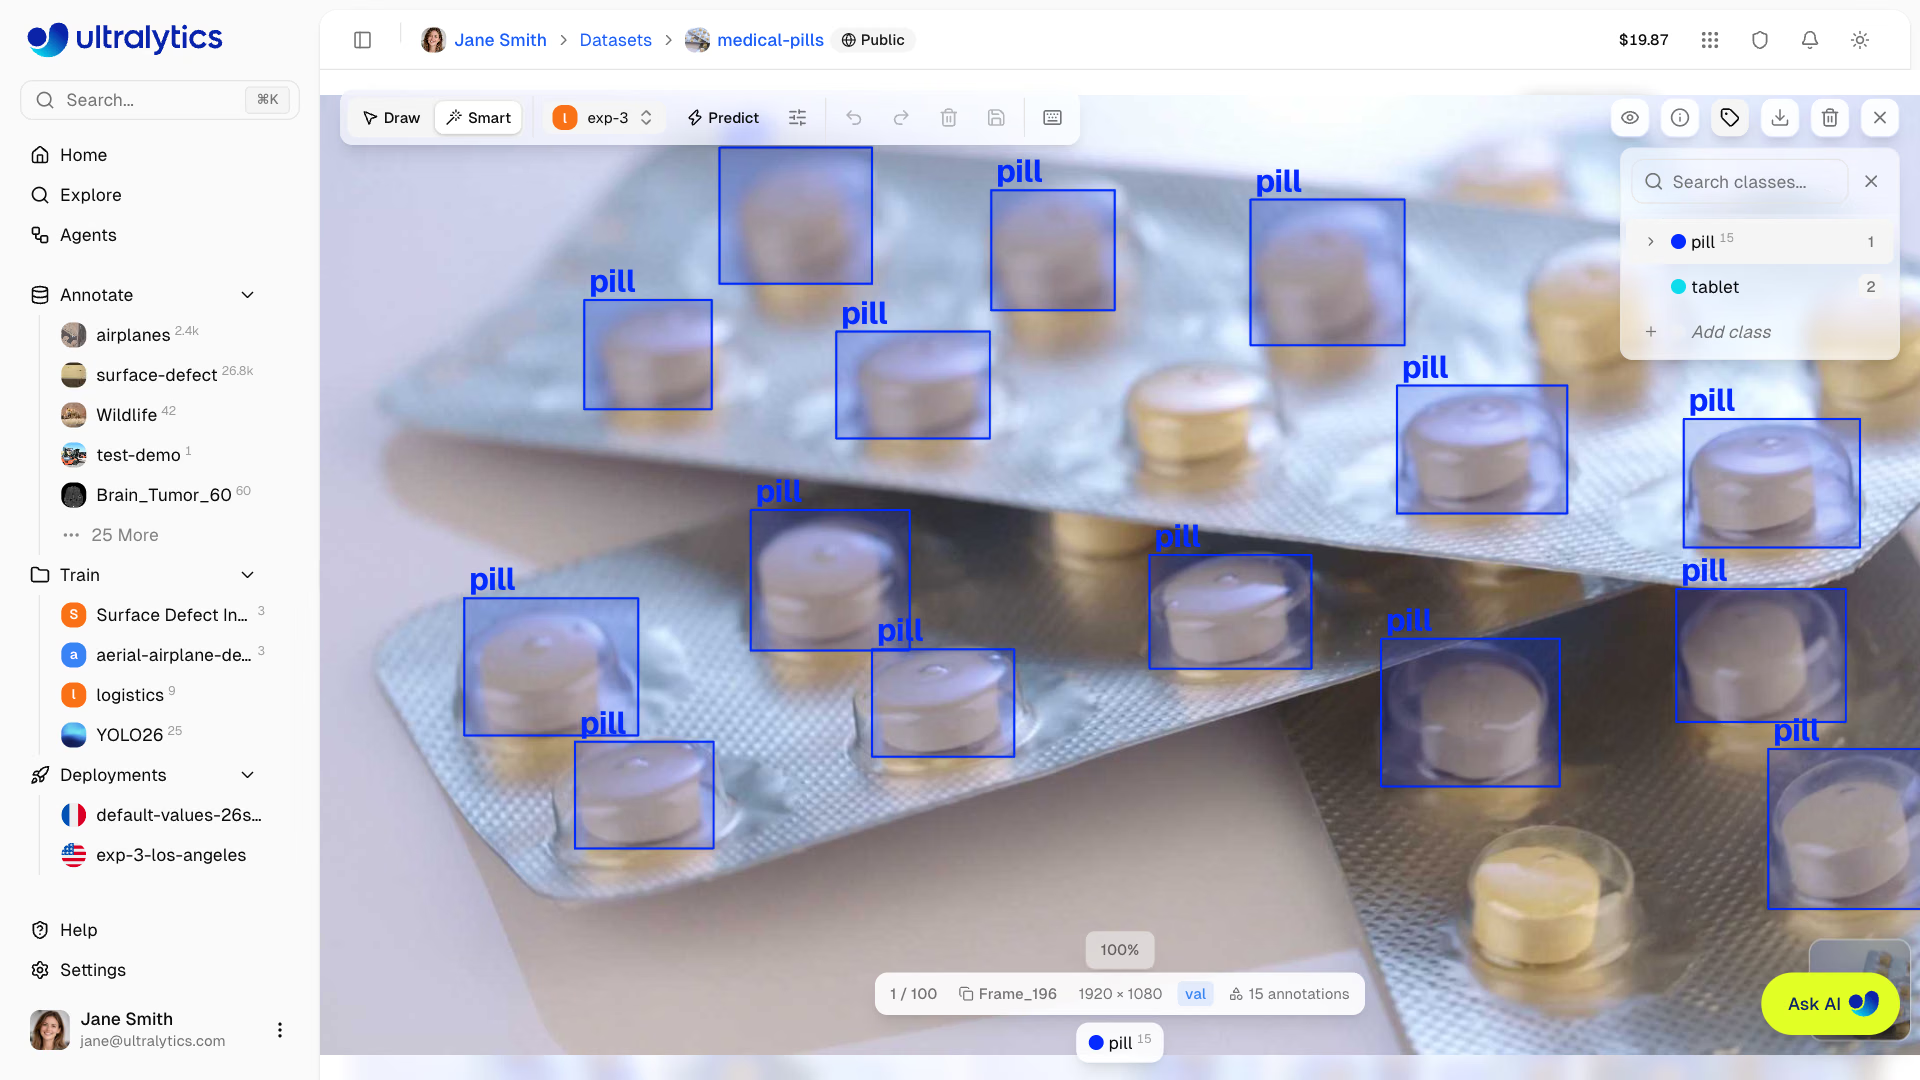
Für SAM ist ein Klick pro Objekt nötig und es liefert die präzisesten Formen. Modellvorhersagen erfordern einen Klick pro Bild und sind nur so gut wie das Modell. Im Rest dieser Lektion geht es daher darum, das passende Modell auszuwählen und einzustellen.
Wähle das Labeling-Modell aus#
Ein schwaches v0-Modell, das mit 100–200 manuell gelabelten Beispielen trainiert wurde, ist immer noch besser, als ganz von vorn anzufangen. Ab v1 ist es normalerweise ein nützlicher Partner für aktives Lernen. Die Leistung von Modellen mit Klassenabfrage variiert stark je nach Anwendungsbereich: Einige erkennen in alltäglichen Fotos fast alles, übersehen aber die meisten Objekte in Leiterplatten-, Röntgen- oder Einzelhandelsbildern. Prüfe daher zehn Vorhersagen, bevor du einem solchen Modell vertraust.
Praxisbeispiel: Miss den Prüfaufwand für jede Schwelle#
Die Konfidenzschwelle bestimmt, wofür Prüfende ihre Zeit aufwenden: Ist sie zu niedrig, löschen sie falsche Boxen; ist sie zu hoch, zeichnen sie die vom Modell übersehenen Boxen. Miss den Aufwand anhand von Bildern mit bereits korrekten Labels. Hier kommen die 128 gelabelten Bilder von COCO128 und ein vortrainiertes YOLO26n als Labeling-Modell zum Einsatz:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Funktionsweise und Aussage:
- Das Modell erstellt einmal Vorhersagen mit einem niedrigen Wert für
conf=0.05. Anschließend filtert jede Schwelle dieselben Vorhersagen, sodass der Test schnell läuft. review_workordnet jede Vorhersage einer Ground-Truth-Box derselben Klasse mit einem IoU von mindestens 0.5 zu. Nicht zugeordnete Vorhersagen sind Boxen, die Prüfende löschen; nicht zugeordnete Ground-Truth-Objekte sind Objekte, die Prüfende einzeichnen.- Bei 0.25–0.4 ist die Zahl der Bearbeitungen pro Bild mit 4.7 am niedrigsten. Darunter steigt die Zahl der Löschungen stark an, darüber die der übersehenen Objekte.
- Selbst bei der besten Schwelle zeichnen Prüfende etwa 3.6 Boxen pro Bild ein, denn die vielen kleinen Objekte in der langen COCO-Verteilung sind für ein Nano-Modell schwer zu erkennen.
Entscheidungsregeln: Wähle die Schwelle mit den wenigsten Bearbeitungen pro Bild. Überwiegt Einzeichnen bei allen Schwellen, ist das Labeling-Modell für die Daten zu schwach. Verwende dann ein größeres Modell oder dein feinabgestimmtes Modell. Überwiegt Löschen selbst bei 0.5, verwechselt das Modell ähnliche Klassen. Prüfe daher die Konfusionsmatrix, bevor du weitere Daten labelst. Führe für dein eigenes Projekt den Test mit deinem feinabgestimmten Modell auf 50–100 bereits gelabelten Bildern aus.
Batch Annotation ausführen#
Batch Annotation führt ein YOLO-Modell oder ein Modell mit Klassenabfrage über den gesamten Datensatz aus. Öffne die Funktion über More actions > Batch Annotation oder wähle nach einer Vorhersage im Editor in der Toast-Benachrichtigung Annotate all:
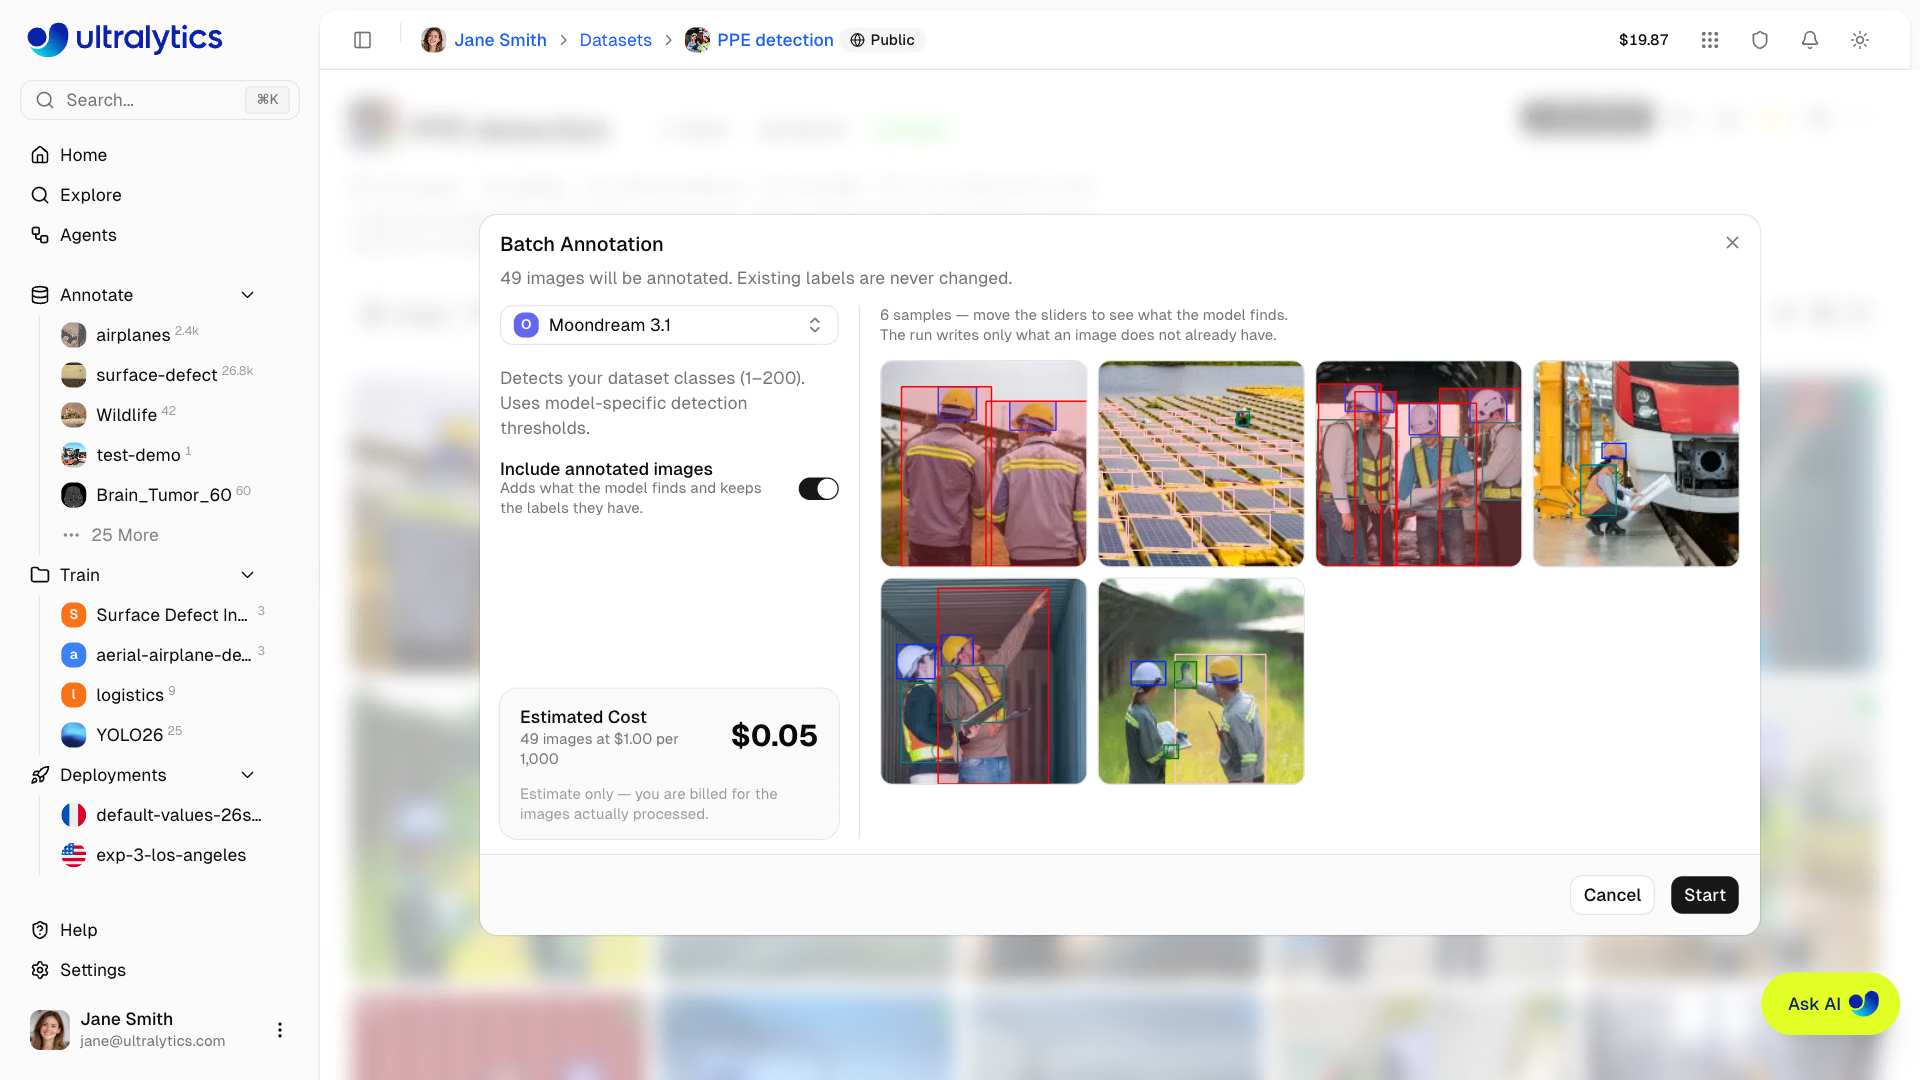
- Wähle das Modell aus. Bei Erkennungsdatensätzen ist Moondream 3.1 vorausgewählt. Wechsle zu deinem feinabgestimmten Modell oder einem YOLO-Modell.
- Lege bei einem YOLO-Modell die Konfidenz auf die vom Test ermittelte Schwelle fest (Standardwert:
0.25) und stelle den IoU-Wert auf0.7ein. Prüfe anschließend die Beispielvorschauen. - Lass Include annotated images deaktiviert, um nur ungelabelte Bilder zu labeln.
- Prüfe die Estimated Cost (1,00 $ pro 1.000 Bilder, mindestens 0,01 $) und klicke auf Start.
Beim Start eines Durchlaufs wird zuerst eine Datensatzversion gespeichert, sodass du den Zustand vor dem Durchlauf wiederherstellen kannst. Mit Stop bleiben die bis dahin verarbeiteten Bilder erhalten und werden abgerechnet.
Prüfe die Ergebnisse und miss anschließend die Bearbeitungsrate#
Die Vorhersagen werden als gewöhnliche Annotationen gespeichert und sind daher nicht als ungeprüft gekennzeichnet. Filtere nach Klasse, um zuerst seltene Klassen zu prüfen. Sortiere anschließend Annotations aufsteigend (möglicherweise übersehene Objekte) und absteigend (überfüllte Szenen, in denen Boxen zusammenlaufen). Erstelle danach eine Version, öffne im Tab „Versions“ die Option Compare versions und wähle v_auto als Version From:
| Anzahl | Bedeutung |
|---|---|
| Hinzugefügt | Vom Modell übersehene Objekte sowie die korrigierte Kopie jeder angepassten Box |
| Entfernt | Falsch positive Ergebnisse sowie das Original jeder angepassten Box |
| Bearbeitungsrate | (hinzugefügt + entfernt) ÷ Anzahl der Annotationen in v_auto; ein oberer Grenzwert, da eine korrigierte Box doppelt gezählt wird |
Verfolge die Bearbeitungsrate für jeden Batch. Ein Anstieg ist ein frühes Warnsignal dafür, dass sich neue Bilder von den Daten unterscheiden, die das Labeling-Modell kennt. In der Lektion zu den bewährten Methoden für Annotationen geht es um Labeling-Anleitungen und die Übereinstimmung zwischen Prüfenden.
Stolperfallen#
Symptom: Jedes erneute Training erzielt etwa denselben Wert, und dieselben Objekte werden immer übersehen. Lösung: Ungeprüfte Vorbeschriftungen übernehmen die systematischen Fehler des Beschriftungsmodells als vermeintliche Wahrheit in den Datensatz: eine ähnlich aussehende Klasse, eine regelmäßig zu locker gesetzte Boxkante oder Objekte, die das Modell nie erkennt. Prüfe jedes Bild, bevor es in eine Trainingsversion aufgenommen wird.
Symptom: Die Stapelbeschriftung ist abgeschlossen, aber die meisten Objekte sind weiterhin unbeschriftet. Lösung: Führe das Modell zuerst im Editor auf zehn repräsentativen Bildern aus. Wenn es mehr als ein paar Objekte übersieht, beschrifte manuell einen Startdatensatz und trainiere stattdessen eine Version 0.
Symptom: Die vorhergesagten Boxen tragen die falschen Klassennamen. Lösung: Wenn sich die Klassen des Modells von denen des Datensatzes unterscheiden, ordnet der Schritt Klassen zuordnen jede Modellklasse einer Datensatzklasse zu oder überspringt sie. Ordne die Klassen sorgfältig zu; eine falsche Zuordnung benennt jede Box dieser Klasse falsch.
Lösung anzeigen
Durchgearbeitetes Beispiel: Für eine Feinabstimmung zur Pilleninspektion wählt die Schwellenwertsuche 0.35 aus. Batch Annotation speichert v4 mit 1,240 Annotationen. Nach der Überprüfung zeigt Compare versions v4 → v5 96 hinzugefügte und 152 entfernte Annotationen an. Die Korrekturrate beträgt also (96 + 152) ÷ 1,240 = 20 %. Da mehr Annotationen entfernt als hinzugefügt wurden, sagt das Modell zu viel voraus: Bei der Überprüfung der entfernten Boxen zeigt sich, dass das Modell Reflexionen auf Blisterpackungen als Pillen markiert. Daraus folgen zwei Maßnahmen: Erhöhe die Konfidenz für den nächsten Durchlauf um eine Stufe (0.35 → 0.45) und prüfe, ob die Rate sinkt. Füge außerdem der nächsten Trainingsversion 30 überprüfte Bilder glänzender Packungen hinzu, damit die Feinabstimmung den Unterschied erlernt.