Läufe vergleichen und den Gewinner auswählen
Vergleiche Läufe in einem Platform-Projekt, halte fest, warum jeder Lauf durchgeführt wird, und entscheide mit einem Skript für die Freigabeprüfung, ob ein Kandidat veröffentlicht wird.
Größere Modelle schneiden bei der übergeordneten Metrik meist besser ab, verlieren dann aber bei einer Klasse, die niemand überprüft hat. Ohne vorher festgelegte Regel wird der Lauf veröffentlicht, der jemandem am besten gefallen hat. In dieser Lektion hältst du jeden Lauf fest, damit die Gründe später nachvollziehbar sind, und machst aus „Ist es besser?“ eine Prüfung, die PASS oder FAIL zurückgibt.
Praxisnah
Läufe in einem Projekt vergleichen#
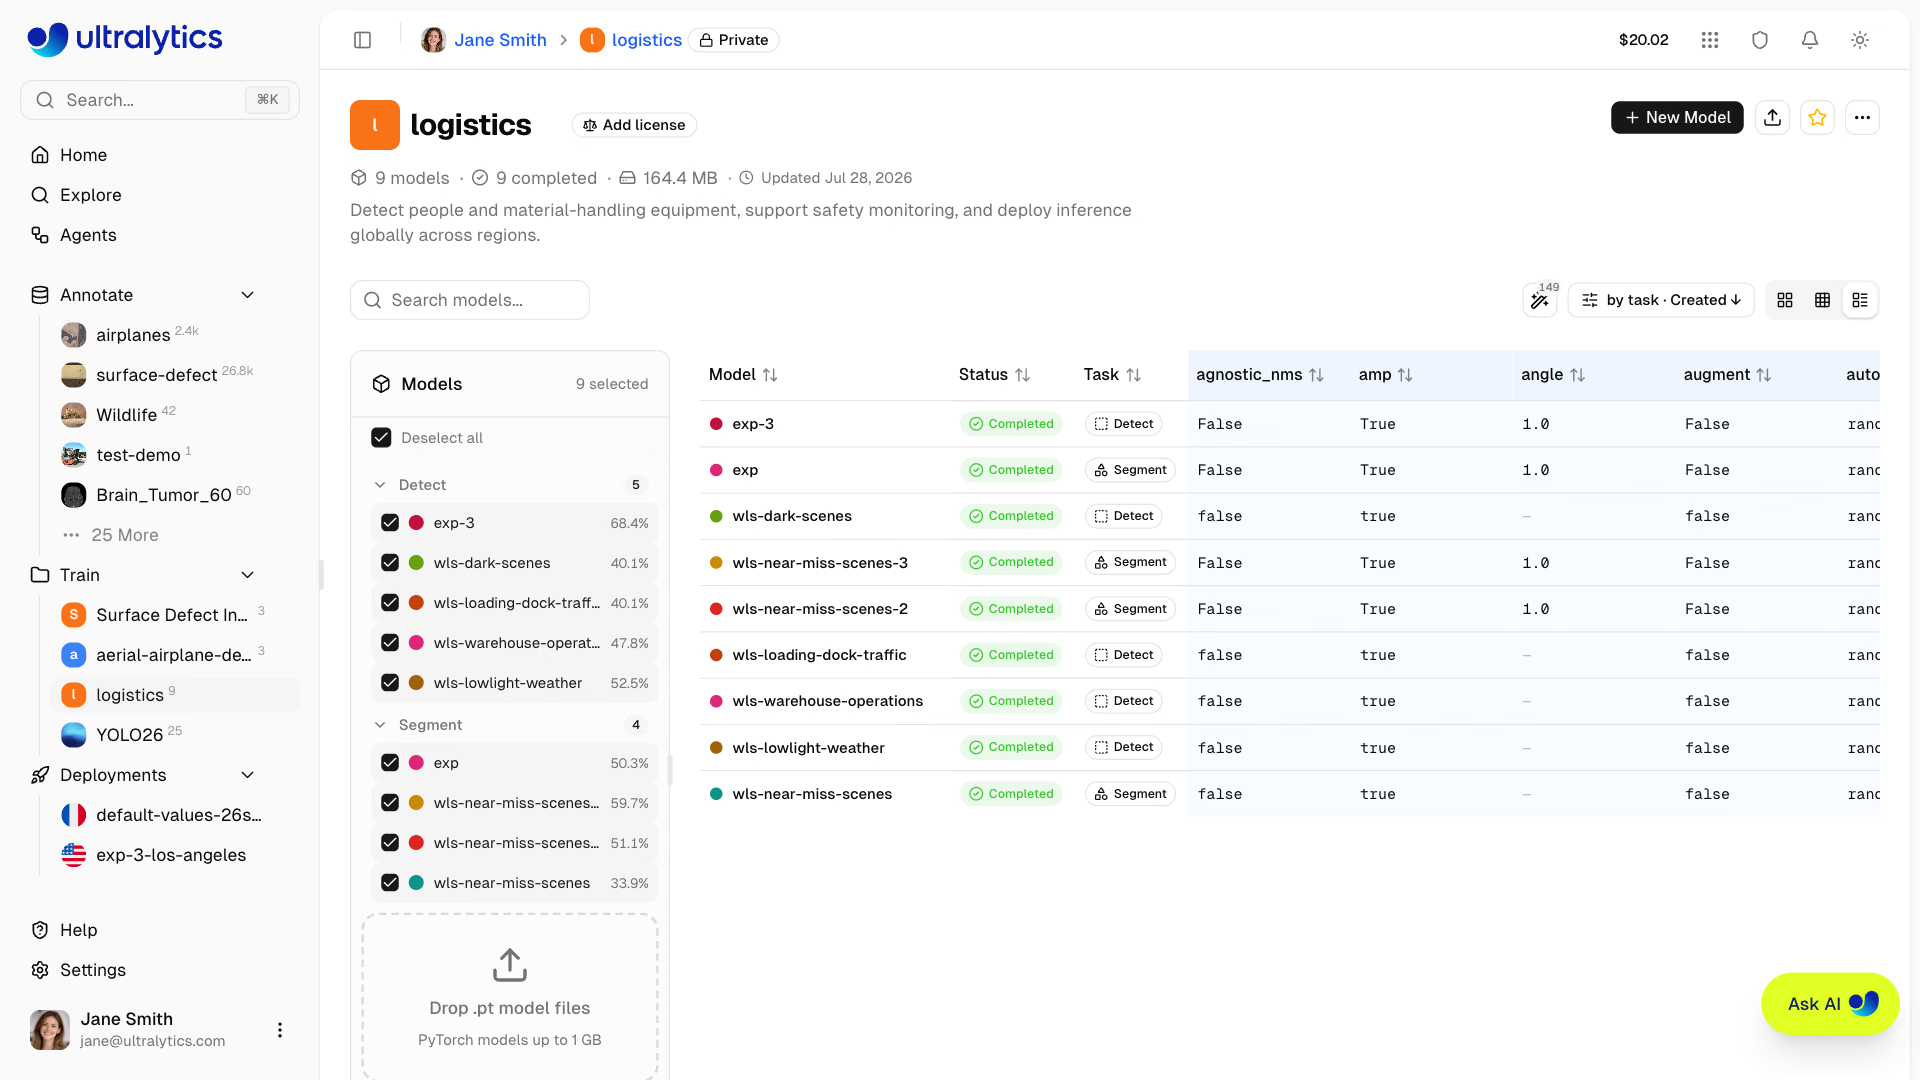
Ein Projekt führt seine Modelle mit Kontrollkästchen auf. Die ausgewählten Modelle werden im Dashboard Diagramme überlagert; die Ansicht Tabelle stellt Trainingsargumente und abschließende Metriken nebeneinander dar. Mit Vergleich werden identische Spalten ausgeblendet, sodass du sofort siehst, dass sich zwei Läufe nur in imgsz unterscheiden. Vergleiche sind nur innerhalb eines Projekts möglich. Fasse deshalb zusammengehörige Experimente zusammen (Modelle lassen sich zwischen Projekten ausschneiden und einfügen). Vergleiche beim Lesen der Kurven den Endwert, wie schnell jeder Lauf ihn erreicht hat und wie gleichmäßig der Verlauf war.

Wenn mindestens zwei Modelle abgeschlossen sind, kannst du mit Mit KI vergleichen Ask AI auffordern, Unterschiede zusammenzufassen und das nächste Experiment vorzuschlagen. Betrachte den Vorschlag als Hypothese für deinen nächsten Lauf, nicht als Urteil.
Jeden Lauf nachvollziehbar machen#
Der Name vermittelt die Bedeutung: run_5 sagt nichts aus, v3_pallets_added und v4_imgsz1024 geben Datensatzversion und Änderung an. Um die Überlegungen festzuhalten, öffne auf der Modellseite Weitere Aktionen > Informationen und speichere eine JSON-Notiz als Benutzerdefinierte Metadaten:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Platform speichert den Rest: Die Karte Laufinformationen zeigt GPU, Stundensatz, Gesamtkosten, Version von ultralytics, Host, übergeordnetes Modell, festgelegte Datensatzversion, falls verfügbar den Git-Commit und einen kopierbaren yolo train-Befehl. Vergleiche sind nur zwischen Läufen mit derselben Datensatzversion fair. Deshalb sollte für jeden Lauf eine Version festgelegt sein.
Metrik und Prüfkriterien vor der Ergebnisansicht festlegen#
| Messwert | Wann sie die richtige Wahl ist |
|---|---|
| mAP50-95 | Standard für Detect, Segment, Pose und OBB: belohnt präzise Boxen und ist stabil genug für Vergleiche |
| mAP50 | Große, klar voneinander getrennte Objekte, bei denen die Genauigkeit der Boxen wenig ausmacht |
| AP pro Klasse für eine einzelne Klasse | Eine Klasse bestimmt den geschäftlichen Nutzen |
| Recall bei festgelegter Precision | Sicherheits- und Alarmsysteme |
| Inferenzlatenz auf dem Zielsystem | Immer als feste Obergrenze |
Der Leitfaden zu YOLO-Leistungsmetriken erklärt die einzelnen Metriken. Ein Kandidat wird nur freigegeben, wenn er alle Prüfkriterien erfüllt:
Praxisbeispiel: Ein Skript für die Freigabeprüfung#
Lade die best.pt-Dateien der Finalisten herunter und werte sie mit demselben Code auf identischen Daten aus. Dieses Beispiel verwendet zwei offizielle Checkpoints, damit es überall ausgeführt werden kann:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsErgebnis: Das größere Modell liegt insgesamt um 2.4 Punkte vorn, aber bei zwei Klassen sinkt die AP um mehr als 10 %, sodass das Modell die Prüfung nicht besteht. Dieser Rückschritt bleibt bei einem Vergleich der Gesamtwerte verborgen. Das Dictionary pro Klasse stammt aus ap_class_index und ap und umfasst nur Klassen, die in den Daten vorkommen. Die Latenz wird auf dem Rechner gemessen, auf dem das Skript läuft. Führe die Prüfung daher auf Hardware aus, die deinem Zielsystem ähnelt. COCO8 enthält nur 8 Validierungsbilder und ist für eine fundierte Entscheidung bei Weitem zu klein. Verwende einen zurückgehaltenen Datensatz mit mindestens einigen Hundert Bildern und übergib split="test" genau einmal für die endgültige Entscheidung.
Schwache Bilder genauer untersuchen#
Bei Erkennungsläufen, die mit einer gespeicherten Datensatzversion trainiert wurden, enthält die Ansicht Validierung zusätzliche Validierungseinblicke: die Bilder mit den schlechtesten und besten F1-Werten pro Bild, dargestellt mit den Ground-Truth-Daten; einen Merkmalsexplorer, der F1 mit Bildgröße, Seitenverhältnis und Anzahl der Instanzen in Beziehung setzt; sowie die Klassen, die am häufigsten mit Fehlern verbunden sind. Mit Ähnliche finden kannst du zu den schlechtesten Bildern ähnliche Bilder als unbeschriftete Bilder zum Trainingssatz hinzufügen und so aus einer nicht bestandenen Prüfung eine konkrete Datenaufgabe machen.
Stolperfallen#
Symptom: Der angegebene Test-mAP ist hervorragend, doch im Produktivbetrieb ist das Ergebnis schlechter. Lösung: Stimme das Modell anhand der Validierungsdaten ab. Wenn du zehn Läufe anhand der Testdaten verglichen hast, wurde das Modell bereits darauf abgestimmt und der Wert ist zu optimistisch. Bewerte die Finalisten nur einmal anhand der Testdaten, ganz am Ende.
Symptom: Ein Lauf „gewinnt“ mit 4 Punkten Vorsprung, aber niemand kann erklären, warum. Lösung: Prüfe die angeheftete Datensatzversion auf der Karte „Laufinformationen“ jedes Laufs. Wenn die Versionen unterschiedlich sind, führe die Baseline auf der neuen Version erneut aus, bevor du die Ergebnisse vergleichst.
Symptom: Der Gewinner wechselt jedes Mal, wenn du mit einem neuen Seed erneut trainierst. Lösung: Unterschiede von weniger als etwa 0,5 mAP-Punkten sind bei den meisten Datensätzen laufbedingtes Rauschen. Behalte den Rauschgrenzwert im Gate bei und verwende eine größere Holdout-Menge, wenn die Ergebnisse so knapp beieinanderliegen.
Lösung anzeigen
Ausgearbeitetes Beispiel für das Pillenmodell: Baseline v1-baseline (10 Epochen) im Vergleich zum Kandidaten v2-finetune (5 weitere Epochen, SGD, lr0 0.001). Lege DATA = "medical-pills.yaml" und die beiden Gewichtungen in gate.py fest. Ausgabe: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms, Bewertung: „Kandidaten freigeben“. Benutzerdefinierte Metadaten für v2: Hypothese „v1 verbesserte sich in Epoche 10 noch“, Änderung „5 Epochen feinabstimmen, SGD lr0 0.001“, Ergebnis „mAP50-95 0.659 -> 0.687“. Halte als Einschränkung in den Metadaten fest: Die Validierungsdaten medical-pills flossen ebenfalls in das Training ein. Bestätige das Ergebnis daher vor dem Produktionseinsatz anhand einer separaten Holdout-Menge.