Zustand und Genauigkeit überwachen
Lies die Endpunktmetriken und Vorhersagestatistiken der Platform aus, richte Benachrichtigungen über eine zeitgesteuerte Zustandsprüfung ein und erkenne Genauigkeitsdrift mit einem Prüfdatensatz-Auftrag.
Ein Endpunkt kann bei jeder Anfrage 200 OK zurückgeben, während seine Genauigkeit um 5 Punkte sinkt, weil die Nachtschicht das Licht gedimmt hat. Die Platform zeigt, wie sich jeder Endpunkt verhält, benachrichtigt aber niemanden und kann die Genauigkeit ohne Labels nicht erkennen. In dieser Lektion erstellst du die beiden zeitgesteuerten Prüfungen, die diese Lücke schließen, und probst die Genauigkeitswarnung mit einer simulierten Nachtschicht.
Praxisnah
Was die Platform anzeigt#

| Signal | Wo | Wie lange die Daten verfügbar sind |
|---|---|---|
| HTTP-Anfragen, Fehlerrate (4xx und 5xx), P95-Latenz | Karten auf der Bereitstellungsseite und im Tab „Deployments“, Aktualisierung jede Minute | Karten decken 24 Stunden ab; die API stellt Daten für 1 Stunde bis 30 Tage bereit |
| Zustand | Karte Endpoint im Tab „Overview“ | Live; bei fehlerhaftem Zustand werden Prüfungen automatisch wiederholt |
| Protokolle | Tab Logs: die 20 neuesten Einträge, Filter Errors | Die API gibt bis zu 200 Einträge pro Anfrage mit Seitenumbruch zurück |
| Vorhersagestatistiken und temporäre Beispiele (bis zu 100 Bilder) | Tab Monitoring | Nur im Arbeitsspeicher der bereitstellenden Instanz |
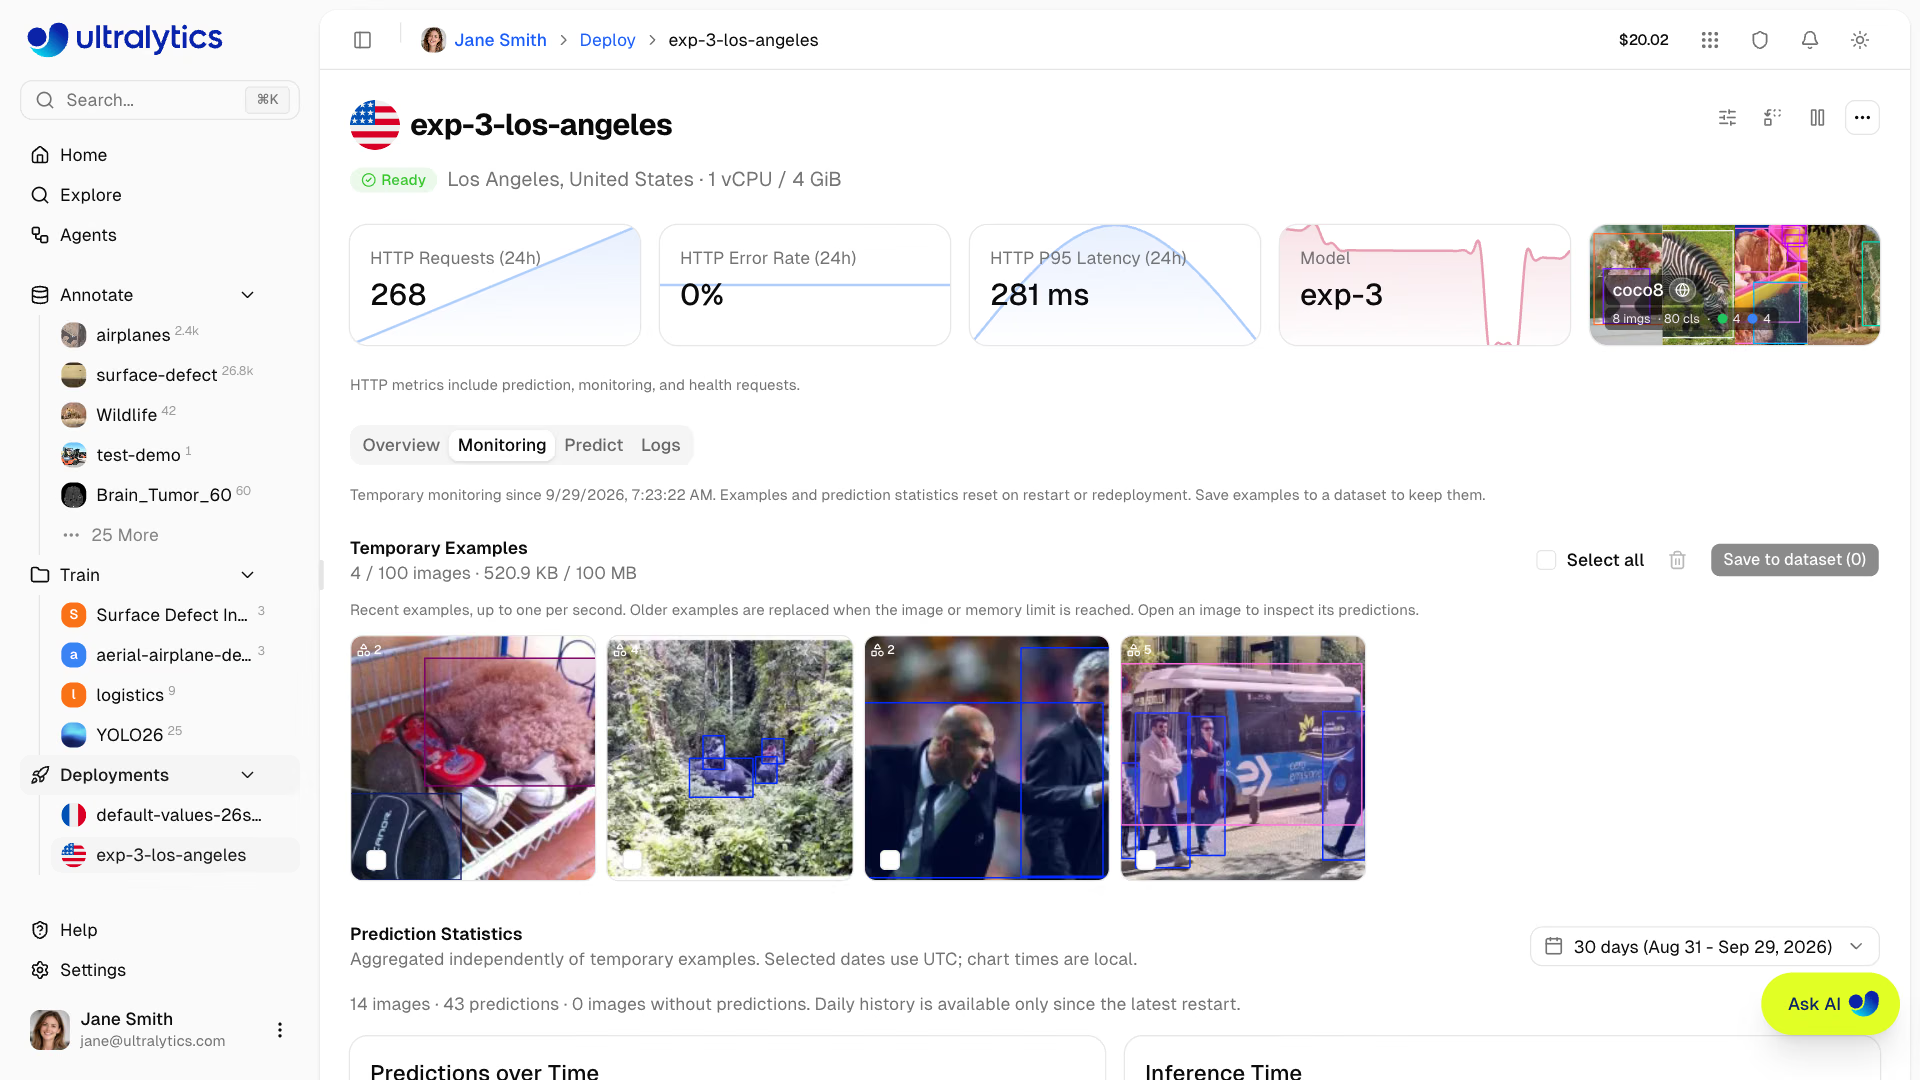
Zwei Einschränkungen bestimmen alles Weitere. Metriken werden nur erfasst, während der Endpunkt Ready ist; wenn du eine Bereitstellung löschst, endet der Zugriff auf ihren Verlauf. Statistiken und Beispiele im Tab „Monitoring“ gehen verloren, wenn der Endpunkt gestoppt oder neu gestartet, seine Größe geändert oder sein Modell ersetzt wird: Es handelt sich um eine Live-Ansicht, kein Archiv.
Praxisbeispiel: Eine zeitgesteuerte Endpunktprüfung#
Die Platform färbt die Karte zur Fehlerrate bei mehr als 5 % rot, und Slack kann melden, wenn eine Bereitstellung bereit ist oder nicht startet. Grenzwertwarnungen gibt es jedoch nicht. Führe diese Prüfung alle 5 Minuten über cron, CI oder deinen Monitoring-Agenten aus und löse bei einem Fehlercode eine Benachrichtigung aus:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
Bei Ausführung mit einer simulierten API, die einen fehlerfreien Endpunkt zurückgibt, gibt die Prüfung eine Zeile aus und endet mit dem Code 0; bei P95_BUDGET_MS = 100 liefern dieselben Daten den Fehlercode 1:
healthy=True requests=1200 p95=180 ms errors=0.40%healthprüft den Endpunkt und gibthealthy,statusundlatencyMszurück. Außerdem weckt es einen auf null skalierten Endpunkt auf; ein Zeitplan mit 5-Minuten-Abständen dient somit auch als Ping, der den Endpunkt warm hält.metrics(..., view="overview")gibttotalRequests,errorRate(einen Prozentsatz) undp95LatencyMsfür den Zeitraum zurück.logsruft die neuesten Fehler und Warnungen ab, sodass die Benachrichtigung bereits einen ersten Hinweis enthält.
Installiere das SDK mit pip install -U ultralytics-platform (das SDK erfordert Python 3.11+). Benachrichtige nur bei anhaltenden Grenzwertüberschreitungen, zum Beispiel nach drei fehlgeschlagenen Prüfungen in Folge, und ergänze jede Benachrichtigung um einen einzeiligen Runbook-Eintrag.
Praxisbeispiel: Genauigkeit mit einem Prüfdatensatz verfolgen#
Anfragemetriken können die Genauigkeit nicht erfassen. Ein Prüfdatensatz schon: 200–500 produktionsnahe Bilder, sorgfältig gelabelt, in einer eigenen privaten Datensatzversion, die nie für das Training verwendet wurde. Bewerte den bereitgestellten Checkpoint wöchentlich und ergänze eine Verlaufsdatei:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
Beim ersten Durchlauf wird der Ausgangswert vom Tag der Bereitstellung festgehalten. Probiere die Warnung anschließend aus, bevor du sie brauchst: Dieses Skript erstellt eine Kopie des Prüfdatensatzes für die „Nachtschicht“ mit denselben Labels und Bildern bei 15 % Helligkeit:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbookJede Anfrage während der Nachtschicht würde weiterhin 200 in Millisekunden zurückgeben, obwohl das Modell 5 mAP-Punkte verloren hat. Das erkennt nur der Prüfdatensatz. Aktualisiere den Prüfdatensatz vierteljährlich mit neu gelabelten Produktionsbildern und setze den Ausgangswert bei jeder Bereitstellung eines neuen Modells zurück. Der Leitfaden zur Modellüberwachung und die Lektion Beobachtbarkeit und Drift behandeln statistische Driftprüfungen.
Drift im Monitoring-Tab erkennen#
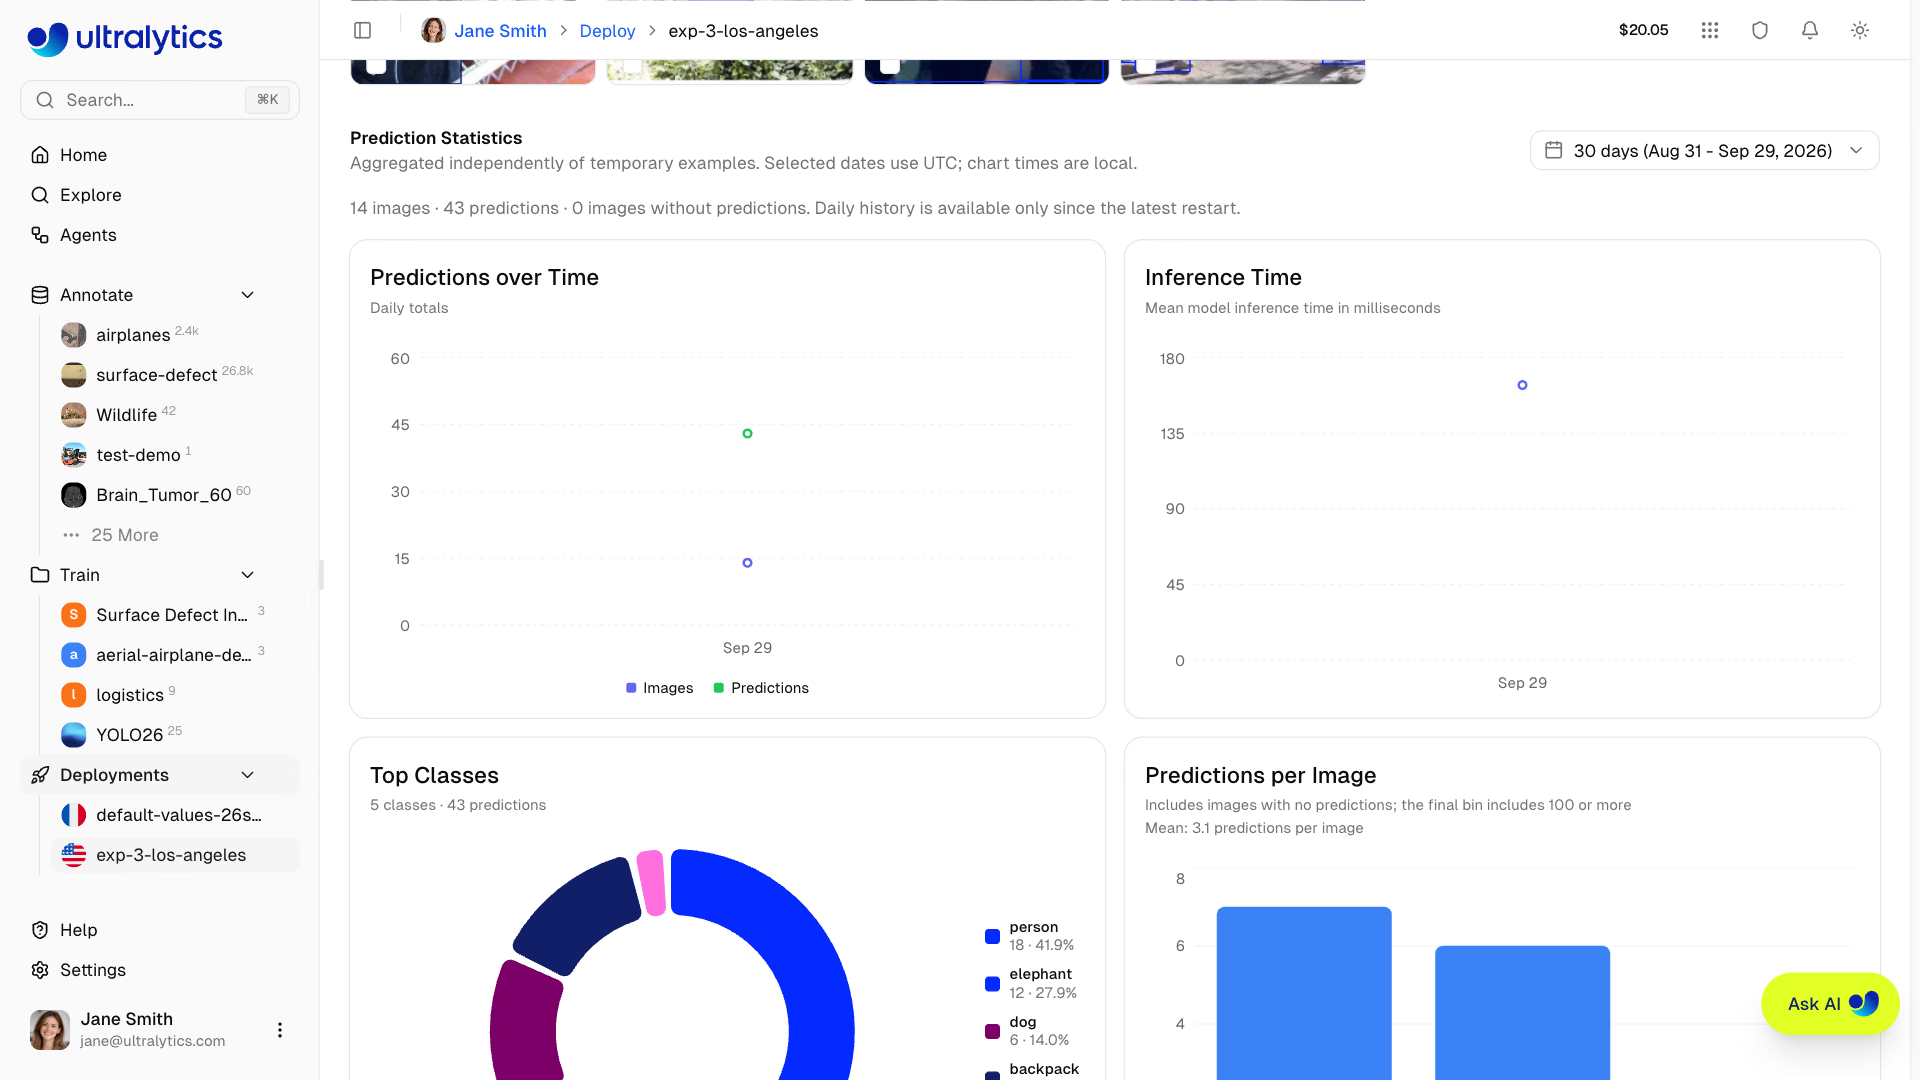
Notiere dir die Form der Diagramme in der Woche deiner Bereitstellung und vergleiche sie später. Die Konfidenz misst die Sicherheit, nicht die Korrektheit. Betrachte diese Diagramme daher gemeinsam mit dem Prüfdatensatz:
| Muster | Wahrscheinliche Ursache | Maßnahme |
|---|---|---|
| Konfidenz sinkt, Prüfdatensatz bleibt stabil | Unbedenkliche Domänenverschiebung | Beobachten; Beispiele für die nächste Datensatzversion speichern |
| Konfidenz und Prüfdatensatz verschlechtern sich | Tatsächlicher Genauigkeitsrückgang | Modell neu trainieren (Lektion 10) |
| Größen oder Positionen der Boxen verändern sich plötzlich | Kamera wurde bewegt, Objektiv oder Standort geändert | Kamera überprüfen, bevor du das Modell änderst |
| Weniger Vorhersagen pro Bild, Konfidenz stabil | Kamera offline, ruhigere Szene oder Fehler im Client | Ursache vorgelagert untersuchen |
| P95-Latenz steigt, Inferenzzeit bleibt konstant | Anfrageverarbeitung, Größe der Nutzdaten oder Kapazität | Infrastrukturproblem, nicht das Modell |
Produktionsbilder zurückführen#
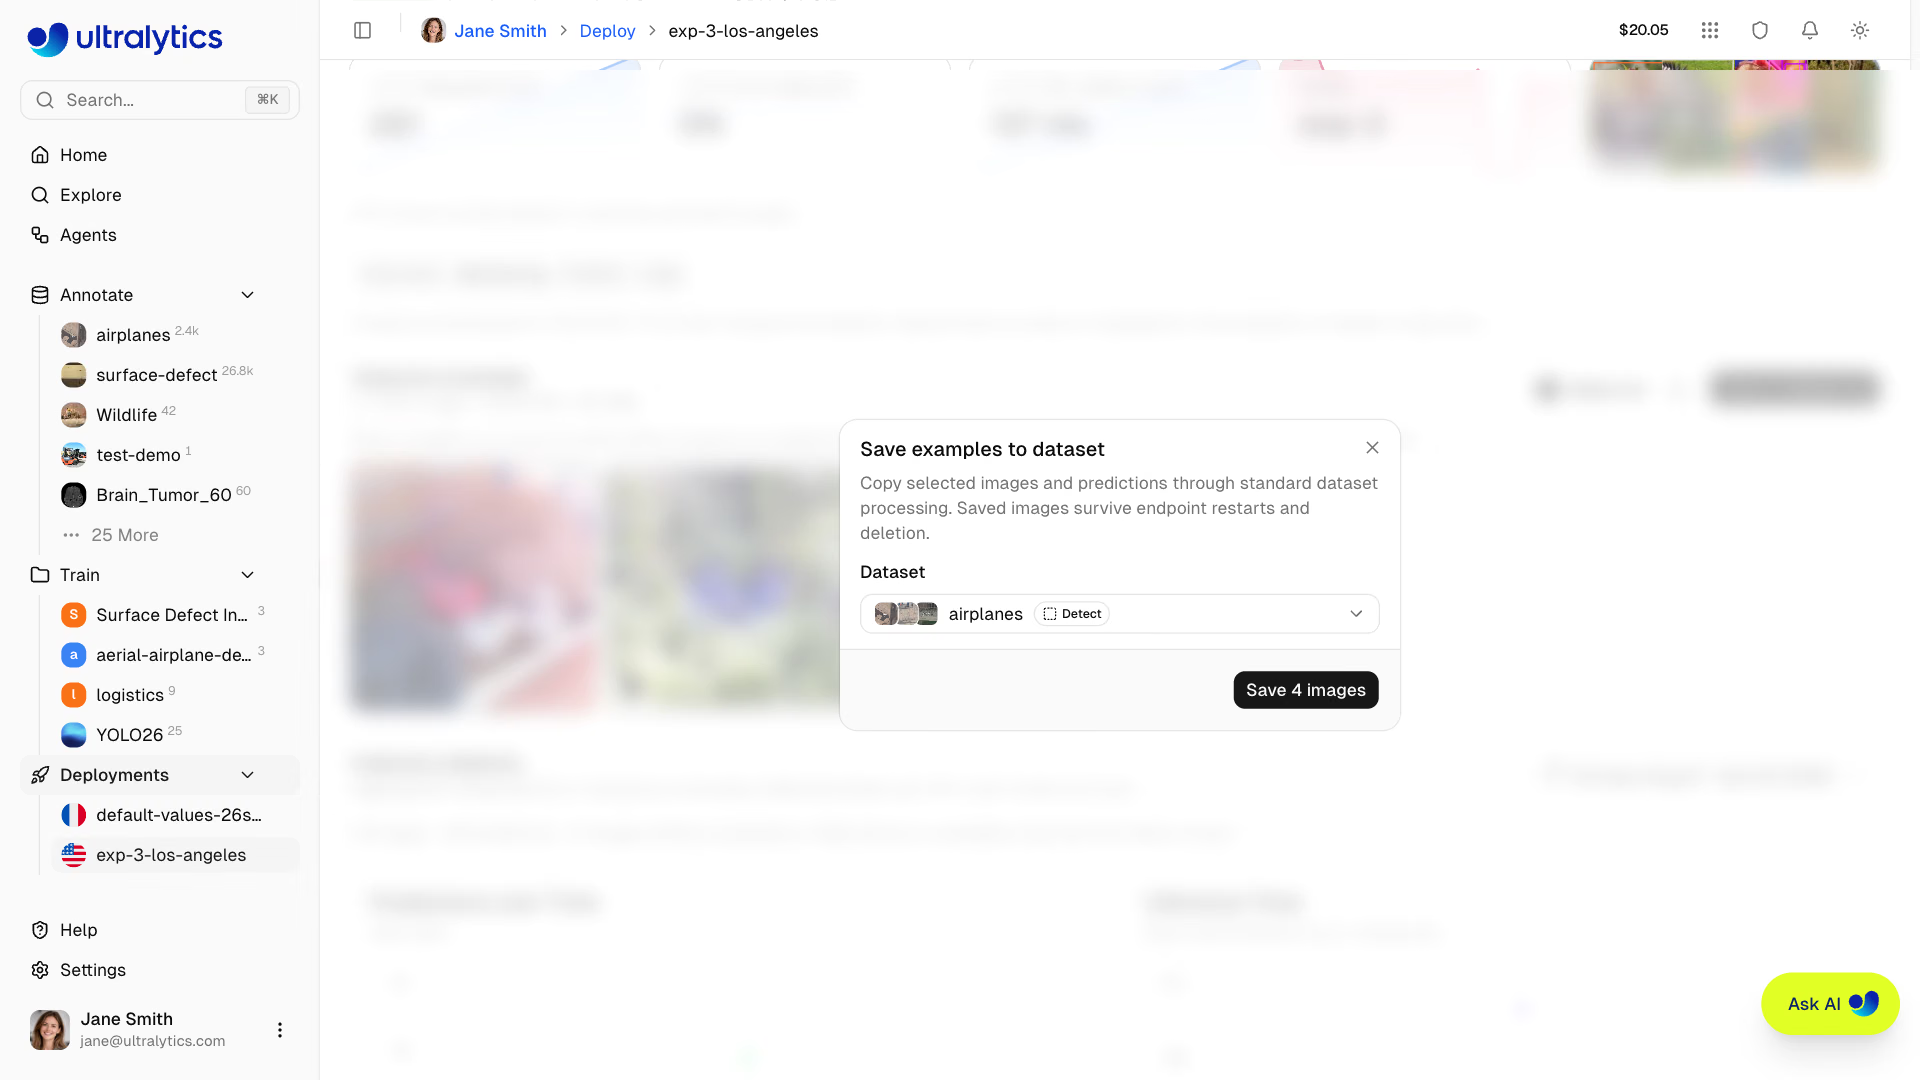
Wähle im Tab „Monitoring“ Beispiele aus und klicke auf Save to dataset. Sie werden zusammen mit ihren Vorhersagen wie gewohnt eingelesen; deploymentId und die Region bleiben in ihren Metadaten erhalten. Die Vorlage Collect Uncertain Detections der Agents erledigt dasselbe für einen gesamten Datensatz: Sie führt Vorhersagen über deine Bereitstellung aus und kopiert Bilder mit Erkennungen innerhalb eines Konfidenzbereichs in einen Prüfsatz.
Stolperfallen#
Symptom: Die Beispiele, die du beschriften wolltest, sind nach einer Größenänderung oder einem Modellwechsel verschwunden. Lösung: Sie befinden sich im Arbeitsspeicher der Serving-Instanz. Speichere sie in einem Datensatz und warte, bis die Datenaufnahme abgeschlossen ist, bevor du den Dienst stoppst, seine Größe änderst oder das Modell ersetzt.
Symptom: Die Holdout-Warnung wird unmittelbar nach der Bereitstellung eines besseren Modells ausgelöst oder nie wieder ausgelöst. Lösung: Die Baseline ist die erste Zeile im Verlauf. Beginne jedes Mal mit einem neuen holdout_history.jsonl (oder erfasse eine neue Baseline-Zeile), wenn du das Modell ersetzt.
Symptom: Während eines Verkehrsspitzen steigt die Fehlerrate, obwohl der Status „gesund“ anzeigt. Lösung: Antworten mit 429 werden als Fehler gezählt, bedeuten aber „Kapazität erreicht“. Prüfe die Protokolle. Wenn es sich um 429-Fehler handelt, verteile den Datenverkehr auf mehr Endpunkte oder verwende eine größere benutzerdefinierte Größe.
Lösung anzeigen
Beispiel für eine funktionierende Lösung für den Pillen-Endpunkt: ein Cron-Eintrag */5 * * * * python endpoint_check.py || ./page-oncall.sh mit P95_BUDGET_MS = 300 und MAX_ERROR_RATE = 1.0; wird das Budget bei einem tatsächlichen P95-Wert von 180 ms auf 100 ms gesetzt, endet der Job mit Exitcode 1 und löst einen Pager-Alarm aus – die Einrichtung funktioniert also. Der wöchentliche CI-Job führt holdout_check.py mit DEPLOYED = "pills-v2.pt" auf der privaten Holdout-Version mit 300 Bildern aus: Baseline 0.69. Bei der Nachtschicht-Probe sinkt der Wert um 0.05, und die ALERT-Zeile wird mit Exitcode 1 ausgegeben. Dadurch schlägt der CI-Job fehl und benachrichtigt den Kanal. Zwölf Monitoring-Beispiele aus der Abendschicht werden über „In Datensatz speichern“ in pill-review abgelegt; jedes Beispiel wird mit deploymentId und europe-west1 gekennzeichnet.