Ein Platform-Projekt planen und budgetieren
Ordne jede Phase des Projektlebenszyklus der Platform oder deinem eigenen Technologie-Stack zu und schätze die monatlichen Kosten, bevor du Guthaben ausgibst.
Bildverarbeitungsprojekte scheitern selten am Modell. Sie scheitern bei den Übergaben: eine Korrektur an einer Beschriftung, die nie in die Trainingskopie übernommen wird, ein Checkpoint, dessen Datenherkunft niemand nachvollziehen kann, ein ständig verfügbarer Endpunkt, der unbemerkt 150 $ im Monat kostet. Die Ultralytics Platform verbindet diese Übergaben in einem Arbeitsbereich. In dieser Lektion entscheidest du vor dem Hochladen, welche Phasen sie für dein Projekt übernimmt und was diese kosten werden.
Praxisnah
Die Platform verbindet den Kreislauf#
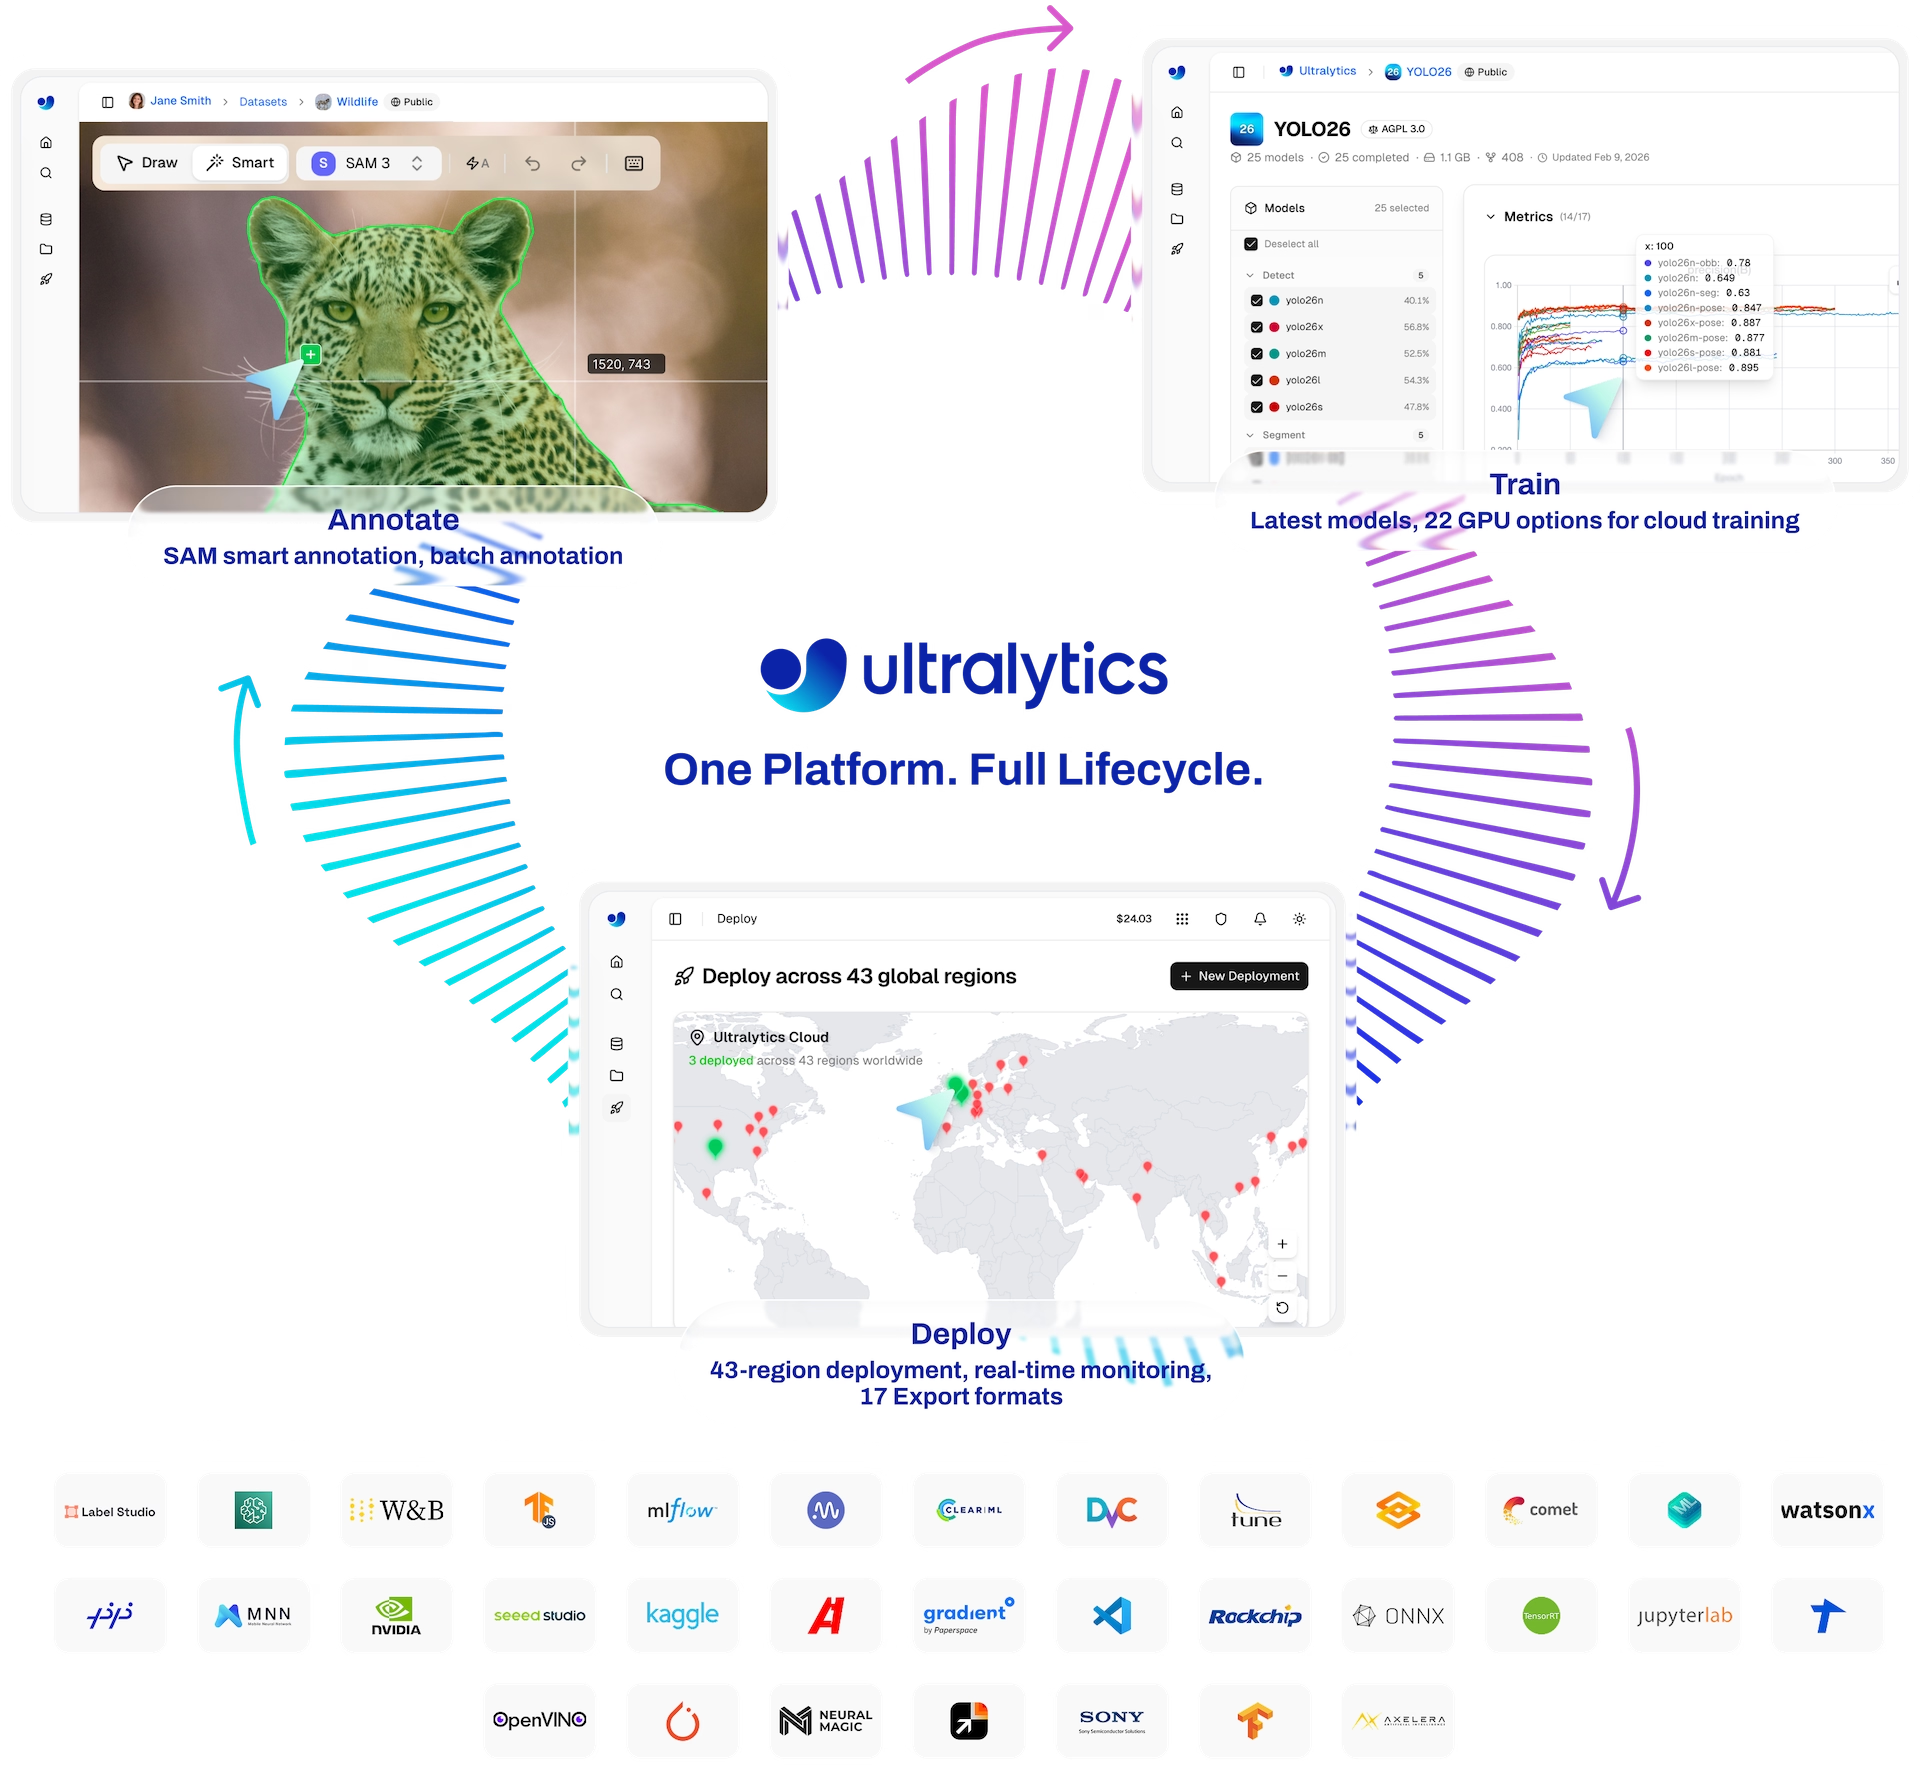
Jedes Bildverarbeitungssystem in der Produktion durchläuft denselben Kreislauf, und der kostspielige Teil ist der Pfeil zwischen zwei Kästen, nicht der Kasten selbst:
Der Vorteil der Platform ist, dass jede Phase festhält, was die nächste Phase benötigt. Nutze diese Tabelle als Übersicht; in der letzten Spalte steht die Lektion, in der die jeweilige Phase behandelt wird:
| Phase | Auf der Ultralytics Platform | Was an die nächste Phase übergeben wird | Lektion |
|---|---|---|---|
| Daten | Bilder, Videos und Archive (YOLO, COCO, NDJSON) hochladen; eine URL importieren; Google Cloud Storage, Amazon S3 oder Azure Blob Storage direkt einlesen (Pro); On Premise (Enterprise) | Ein Datensatz mit Aufgabentyp und Teilmengen | 2 |
| Annotieren | Manuelle Werkzeuge für alle YOLO-Aufgaben außer Tiefenschätzung (als gepaarte Karten importiert), SAM, YOLO und intelligente Annotation mit Klassenaufforderungen, Stapelannotation | Labels sowie eine vor jedem Stapellauf gespeicherte Version | 3 |
| Zusammenstellen | Clustering, ähnliche Bilder finden, Klassen zusammenführen, Werkzeuge zum Aufteilen, nummerierte Versionen | Eine unveränderliche Dataset-Version | 4 |
| Training | 26 Cloud-GPU-Typen mit Kostenschätzung oder lokal ausgeführte Läufe, die in ein Projekt übertragen werden | Ein Modell, verknüpft mit seiner Dataset-Version, den Kosten und dem Befehl | 5 |
| Vergleichen | Projektdiagramme, Tabellenansicht mit Diff, Validierungserkenntnisse | Der Lauf, den du bereitstellen solltest | 6 |
| Bereitstellen | Dedizierte Endpunkte in 42 Regionen; Modell unter derselben URL ersetzen | Eine Endpunkt-URL, verknüpft mit ihrem Modell | 7 |
| Überwachen | Metriken zu Anfragen, Fehlern und P95-Latenz, Protokolle, Vorhersagestatistiken, in Dataset speichern | Produktionsbilder zurück in einem Dataset | 8 |
Zwei Werkzeuge decken den gesamten Ablauf ab. Agents erstellen visuelle Workflows, etwa um unsichere Erkennungen in einem Prüf-Dataset zu sammeln, und Ask AI kann über eine Unterhaltung trainieren, vergleichen, annotieren, exportieren und bereitstellen – mit denselben Befehlen ul cloud, die du selbst ausführen kannst.
Entscheide, was weiterhin in deiner Verantwortung liegt#
Die Plattform hat einige bewusst gesetzte Grenzen. Bestimme für jede davon eine verantwortliche Person in deinem Plan:
- Frames aus proprietären Systemen abrufen (DICOM-Archive, OEM-Kameras, Anlagenhistorianer): Dein Code überträgt sie in einen Bucket oder lädt sie hoch.
- Alarmierung. Die Plattform zeigt Endpunktmetriken an und sendet Jobereignisse an Slack, löst aber keine Alarme bei Latenz- oder Fehlergrenzwerten aus. Diese Prüfung richtest du in Lektion 8 ein.
- Genauigkeit im Zeitverlauf. Ein gekennzeichneter Holdout-Datensatz und dessen Verlauf liegen in deiner Verantwortung (Lektion 8).
- Anwendungslogik. Zählung, Tracking und Zonenregeln gehören in deinen Dienst; Ultralytics Solutions und der Kurs Ultralytics YOLO in Production behandeln diese Themen.
- Datenverkehr weiterleiten. Endpunkte haben generierte URLs und keine benutzerdefinierten Domains. Daher brauchst du für Canaries, die Weiterleitung über mehrere Regionen und gebrandete Hostnamen ein eigenes Gateway.
Die Plattform ist kein separates Framework. Ein Plattformmodell wird als normales best.pt heruntergeladen, das YOLO("best.pt") lädt, validiert und exportiert. Ein lokales model.train(..., project="username/my-project") überträgt Daten mit gesetztem API-Schlüssel an die Plattform. Beim Wechsel zwischen beiden muss nichts konvertiert werden.
Praxisbeispiel: Plane das Projektbudget vor dem Start#
Drei Dinge kosten Credits: Cloud-Training (GPU-Tarif × genutzte Zeit), Stapelannotation und das Verwischen von Gesichtern im gesamten Dataset (1,00 $ pro 1.000 Bilder) sowie Endpunkte mit benutzerdefinierter Größe (Abrechnung pro Betriebsstunde). Alles andere in diesem Kurs ist kostenlos. Dieser Rechner verwendet die tatsächlichen Tarife der Plattform für ein kleines Erkennungsprojekt:
# Monthly Platform budget for a small detection project (rates from the billing and deployment docs)
TRAIN_RUNS = 8  # experiments per month
COST_PER_RUN = 0.23  # dialog estimate: ~1,000 images, YOLO26n, 100 epochs, RTX PRO 6000 ($2.09/h)
BATCH_ANNOTATION_IMAGES = 3_000  # $1.00 per 1,000 images
HOURS_PER_MONTH = 730

# Custom endpoint sizes keep one warm instance; us-central1 rates are $0.000024/vCPU-s and $0.0000025/GiB-s
warm_endpoint_hourly = (2 * 0.000024 + 4 * 0.0000025) * 3600  # 2 vCPU, 4 GiB

lines = {
    "cloud training": TRAIN_RUNS * COST_PER_RUN,
    "batch annotation": BATCH_ANNOTATION_IMAGES / 1000 * 1.00,
    "default endpoint (1 vCPU, 2 GiB, scales to zero)": 0.0,
    "warm endpoint (2 vCPU, 4 GiB, always on)": warm_endpoint_hourly * HOURS_PER_MONTH,
}
for item, usd in lines.items():
    print(f"{item:<50} ${usd:>7.2f}")
print(f"{'total with a warm endpoint':<50} ${sum(lines.values()):>7.2f}")
cloud training $ 1.84
batch annotation $ 3.00
default endpoint (1 vCPU, 2 GiB, scales to zero) $ 0.00
warm endpoint (2 vCPU, 4 GiB, always on) $ 152.42
total with a warm endpoint $ 157.26So liest du die Ergebnisse:
COST_PER_RUNstammt aus der Schätzung im Trainingsdialog, die Dataset-Größe, Modell, Epochen, Bildgröße und GPU berücksichtigt. Ersetze den Wert durch die Schätzung für dein eigenes Dataset (Lektion 5); 5.000 Bilder × YOLO26s × 100 Epochen auf einer H100 SXM kosten etwa 1,56 $.- Der Endpunktposten macht den größten Anteil aus. Training und Kennzeichnung eines kleinen Projekts kosten ein paar Dollar; ein 730 Stunden pro Monat laufender Rechner kostet in Iowa etwa 150 $ (die Tarife variieren je nach Region, und der Bereitstellungsdialog zeigt den genauen Stundensatz).
- Entscheidungsregel: Starte jeden Endpunkt mit der kostenlosen Standardgröße. Wechsle nur dann zu einer benutzerdefinierten Größe, wenn Nutzer keinen Kaltstart von bis zu einer Minute hinnehmen können und der Datenverkehr konstant genug ist, um die Kosten für die Betriebszeit zu rechtfertigen.
Tarife#
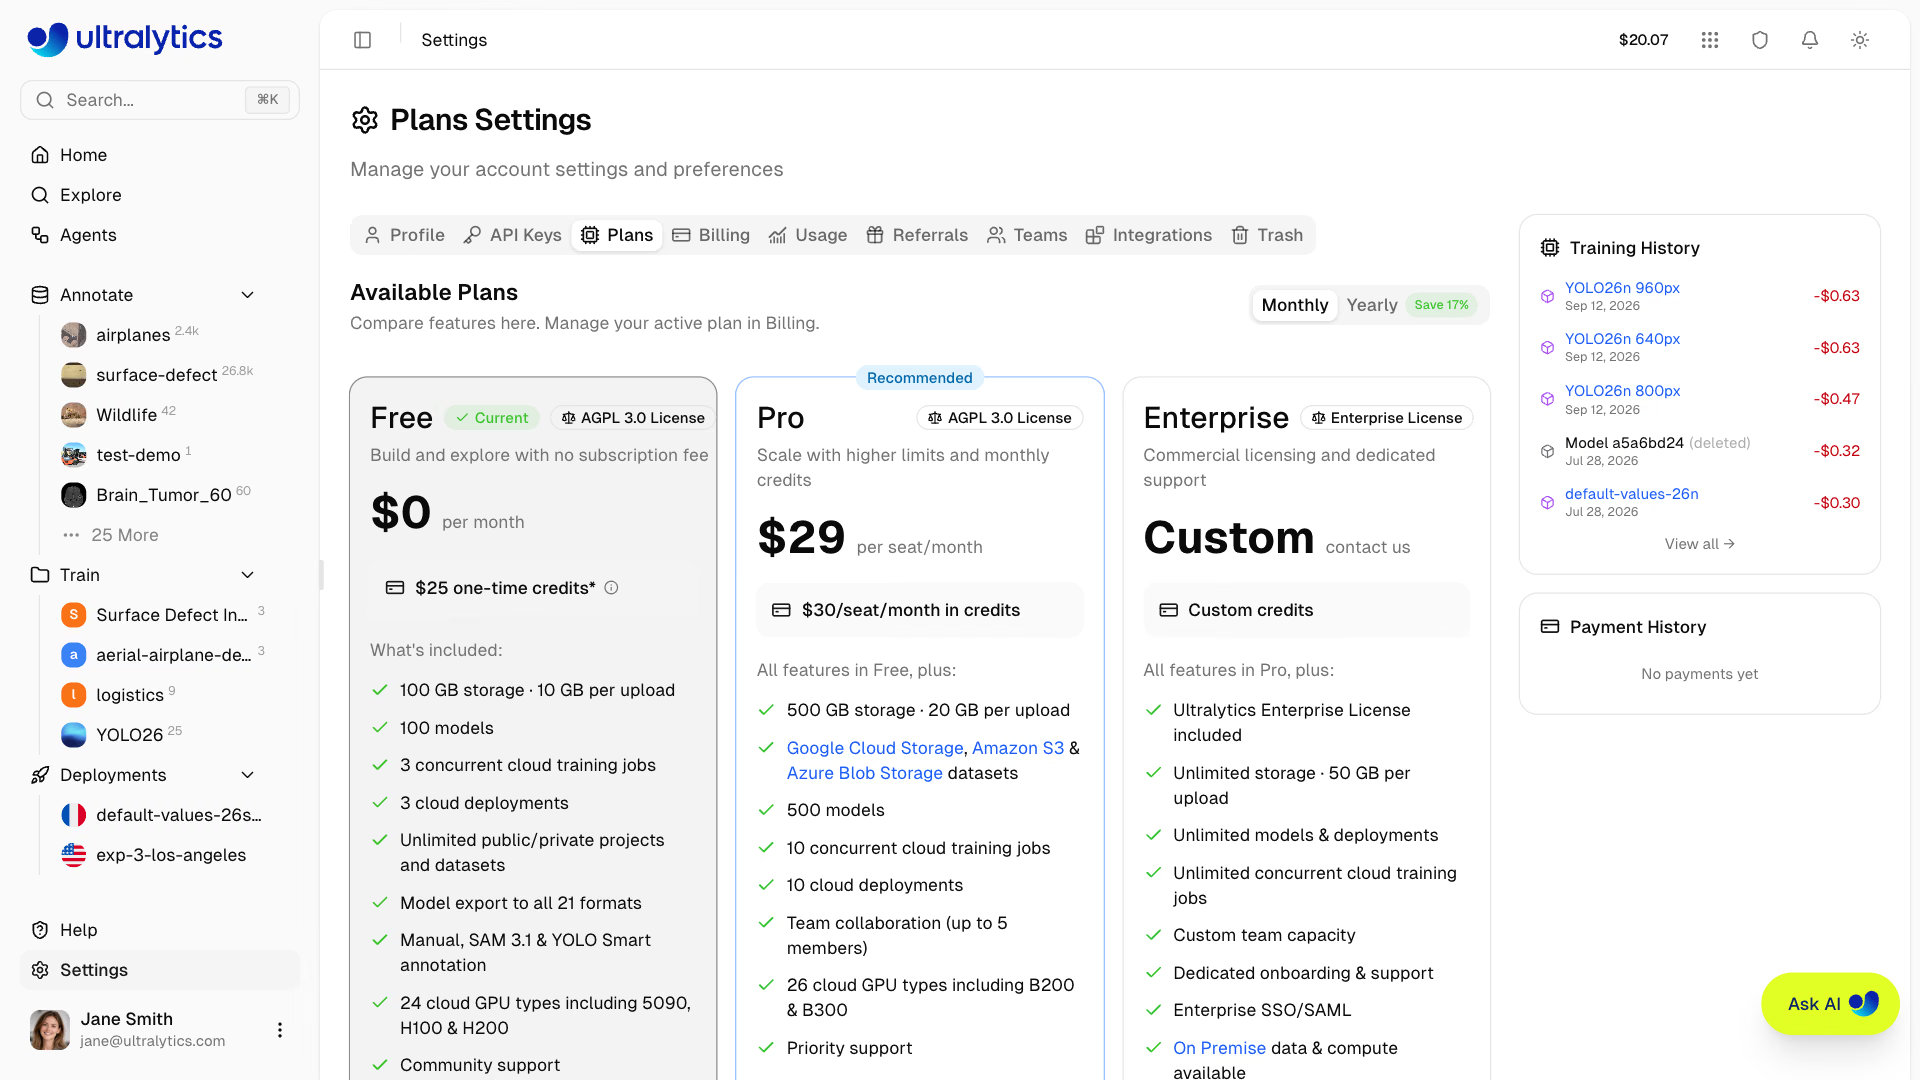
| Free | Pro (29 $/Platz/Monat) | Enterprise | |
|---|---|---|---|
| Credits | 5 $ bei der Registrierung, 25 $ mit verifizierter geschäftlicher E-Mail-Adresse | 30 $/Platz/Monat, keine Übertragung in den Folgemonat | Individuell |
| Speicher / einzelner Upload | 100 GB / 10 GB | 500 GB / 20 GB | Unbegrenzt / 50 GB |
| Modelle / gleichzeitige Trainingsläufe | 100 / 3 | 500 / 10 | Unbegrenzt |
| Dedizierte Bereitstellungen | 3 | 10 | Unbegrenzt |
| Cloud-GPU-Typen | 24 | 26 (zusätzlich B200, B300) | 26 |
| Cloud-Speicher-Datasets, Teams | — | Ja, bis zu 5 Mitglieder | Ja, benutzerdefinierte Größe |
| Vor-Ort-Betrieb, SSO, Enterprise-Lizenz | — | — | Ja |
Entscheidungsregel: Bleib beim Tarif Free, solange du dich noch einarbeitest; wechsle zu Pro, wenn du verbundenen Cloud-Speicher, ein Team, mehr als drei Endpunkte oder mehr als drei gleichzeitige Trainingsläufe brauchst. Die monatlichen 30 $ an Pro-Credits decken die Trainings- und Kennzeichnungsposten des obigen Budgets ab. In der Abrechnungsdokumentation sind alle Tarife aufgeführt.
Stolperfallen#
Symptom: Ein Datensatz mit Kundenbildern erscheint unter Explore und Fremde können ihn klonen. Lösung: Bei Free und Pro sind neue Datensätze und Projekte standardmäßig öffentlich. Ändere die Sichtbarkeit in den Dialogen Neuer Datensatz und Neues Projekt jedes Mal; wenn du einen Datensatz später privat machst, werden bereits vorhandene Klone nicht entfernt.
Symptom: Ein EU-Kunde verlangt, dass die Daten in der EU gespeichert werden, dein Workspace die Daten aber in den USA speichert. Lösung: Die Datenregion (US, EU oder AP) wird bei der Einrichtung ausgewählt und kann nur vom Support geändert werden. Entscheide anhand deiner Verträge, bevor du dich registrierst (Lektion 9).
Symptom: Ohne Datenverkehr werden täglich etwa 5 $ an Guthaben verbraucht. Lösung: Benutzerdefinierte Größen werden nach Laufzeit abgerechnet, unabhängig davon, ob sie gerade genutzt werden. Stoppe Endpunkte, die du nicht verwendest, oder setze sie auf die Standardgröße zurück, die kostenlos auf null herunterskaliert.
Lösung anzeigen
Beispielplan für eine Kamera an einer Tablettenprüflinie. Daten: nächtliche Frame-Exporte über einen Plattform-Upload (verantwortlich: Ana). Annotieren: Stapelannotation mit dem neuesten Fine-Tuning-Modell, anschließend Prüfung (Ana). Zusammenstellen, Trainieren, Vergleichen: Plattform (Ravi). Bereitstellen: ein Endpunkt in Standardgröße unter europe-west1, da die SPS der Linie ihn alle 30 Sekunden aufruft und er daher selten lange genug inaktiv ist, um auf null herunterskaliert zu werden (Ravi). Überwachen: Plattform-Dashboards sowie eine per Cron ausgeführte Zustandsprüfung und ein wöchentlicher Holdout-Lauf in der CI des Teams (Bereitschaftsdienst). Budget: 10 Läufe × 0,23 $ + 2.000 Bilder × 0,001 $ = etwa 4,30 $ pro Monat mit einem kostenlosen Endpunkt; abgedeckt durch Pro-Credits in Höhe von 30 $. Datenregion EU, da sich das Werk in Deutschland befindet; jedes Dataset ist privat.