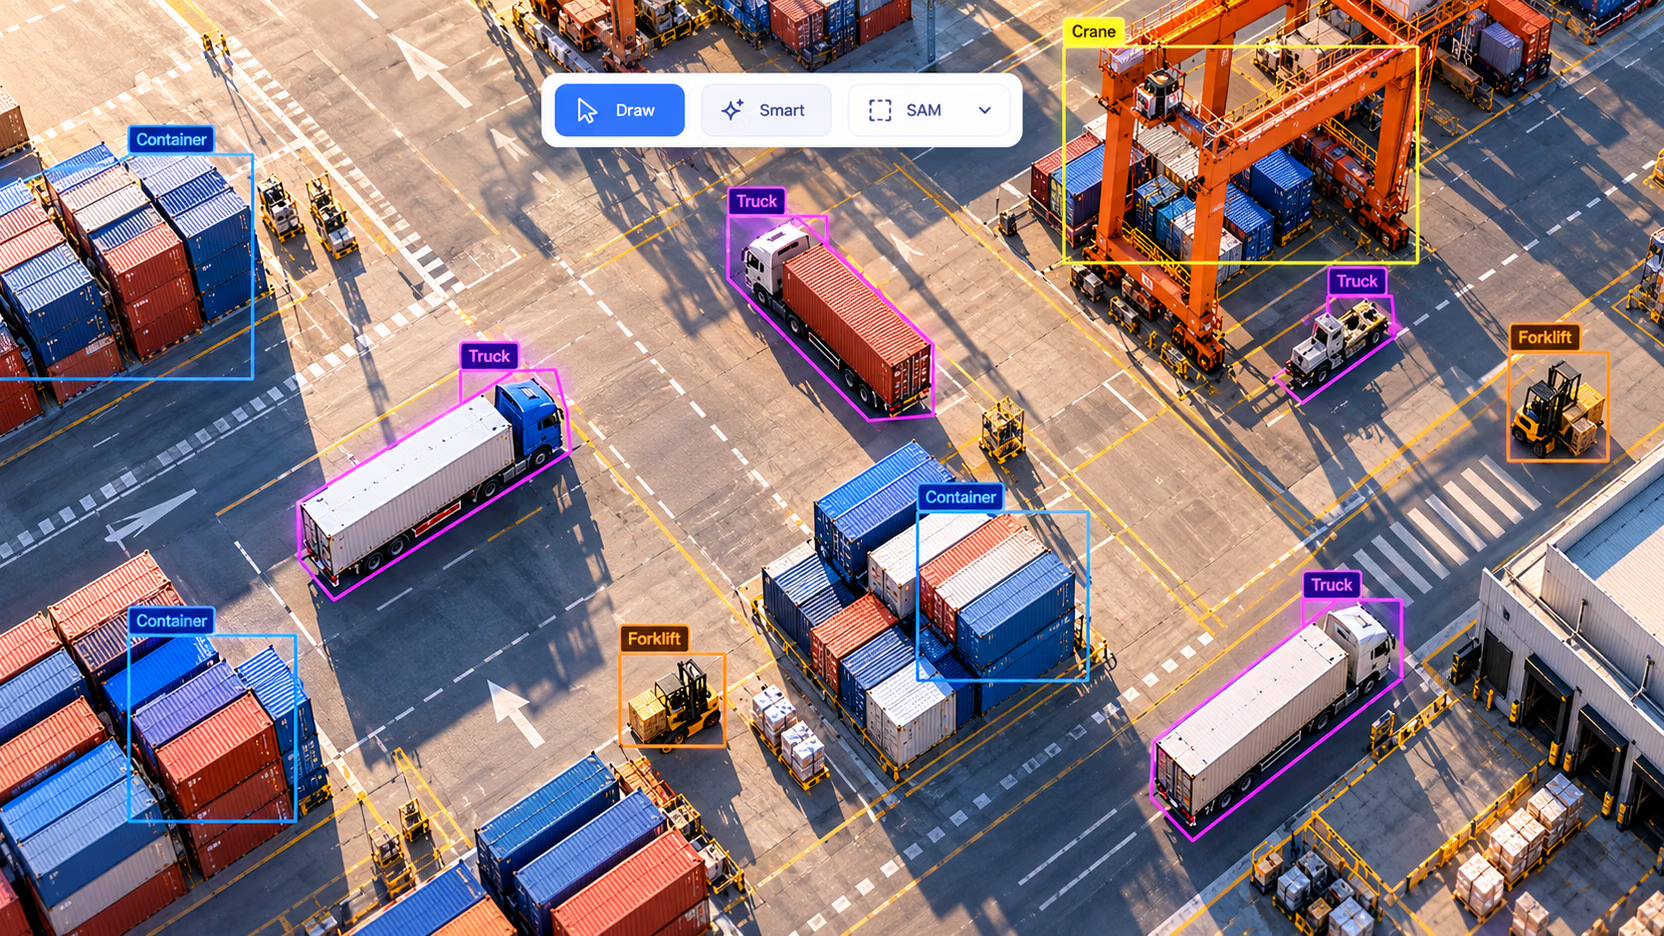
Mit der Ultralytics Platform entwickeln
Führe ein echtes Erkennungsprojekt auf der Ultralytics Platform durch: Lege ein Budget fest, importiere und beschrifte Daten, weise saubere Datensatzaufteilungen nach, trainiere und vergleiche Durchläufe, stelle einen dedizierten Endpunkt bereit, überwache die Genauigkeit und automatisiere die erneute Trainingsschleife.
Von Ultralytics Academy
Setze ein Bildverarbeitungsprojekt auf der Ultralytics Platform durchgängig um und nimm die Skripte und das Betriebshandbuch mit, die einen stabilen Betrieb sicherstellen: eine Prüfung vor dem Hochladen, eine Auswertung verschiedener Beschriftungsschwellenwerte, eine Prüfung auf Datenlecks, eine Freigabeschranke, einen robusten Endpunkt-Client sowie geplante Prüfungen von Zustand und Holdout-Datensatz.
Ordne dein Projekt der Platform zu und lege ein Budget fest, bevor du Guthaben ausgibst: für Training, Annotation und die Verfügbarkeit des Endpunkts.
Importiere Daten so, dass der Datensatz gleich beim ersten Versuch den Status Ready erreicht, einschließlich gezielter Stichproben aus Videos.
Wähle ein Beschriftungsmodell und einen Konfidenzschwellenwert, indem du den Prüfaufwand misst, und überprüfe dann die Stapelannotation anhand der Bearbeitungsrate.
Weise nach, dass eine Datensatzversion keine Duplikate zwischen Teilmengen und keine Datenlecks durch Kameras enthält und genügend Beispiele für jede Klasse bietet.
Starte budgetierte Cloud-Durchläufe, bewerte sie anhand ihrer Kurven und passe das Training an, ohne dass der Optimierer deine Lernrate unbemerkt ignoriert.
Entscheide anhand vorab festgelegter Kriterien, ob ein neuer Durchlauf die Baseline übertrifft, stelle ihn bereit und rufe ihn mit einem Client auf, der Kaltstarts übersteht.
Richte Benachrichtigungen für den Zustand des Endpunkts und die Genauigkeit auf dem Holdout-Datensatz ein, berücksichtige Regionen und personenbezogene Daten und automatisiere das erneute Training und die Freigabe.
Ein Projektplan mit einer Übersicht des Lebenszyklus und einem Monatsbudget.
Ein datensatzbereiter Datensatz mit Stichproben aus Videos, geprüften Beschriftungen, kontrollierten Aufteilungen und einer nummerierten Version.
Ein trainiertes Modell, das eine skriptgesteuerte Freigabeschranke im Vergleich zur Baseline bestanden hat.
Ein dedizierter Endpunkt mit einem Client, der Wiederholungsversuche ausführt, einer geplanten Zustandsprüfung und einem Verlauf der Genauigkeit auf dem Holdout-Datensatz.
Ein Betriebshandbuch für erneutes Training mit Auslöser, Schritten, Verantwortlichem, Rollback und einem automatisierten Freigabeschritt.
Ein Konto auf der Ultralytics Platform. Der Free-Tarif und sein Startguthaben decken den Kurs ab; für verbundenen Cloud-Speicher ist Pro erforderlich.
Python 3.11+ mit
ultralytics>=8.4.120undultralytics-platform, um die durchgearbeiteten Beispiele auszuführen; die in den API-Lektionen verwendeteultralytics-platformSDK erfordert Python 3.11 (Ultralytics selbst läuft mit Python 3.10+).Vertrautheit mit Ultralytics YOLO – empfohlen: Grundlagen der Computer Vision, Leistungsstarke YOLO-Datensätze erstellen und Trainiere dein erstes YOLO-Modell.
Ein kleiner Bilddatensatz (50–500 Bilder) und ein kurzes Video aus deinem eigenen Anwendungsbereich oder die in den Beispielen verwendeten öffentlichen Datensätze.
Kursinhalt
4 Module · 10 LektionenModul 1
Modul 2
Daten hinzufügen und vorbereiten
Prüfe ein Dataset lokal vor dem Upload, wähle Videoframes gezielt aus und bringe ein Plattform-Dataset gleich beim ersten Versuch auf „Ready“.
Intelligente Annotation und Batch-Labeling
Wähle ein Labeling-Modell und eine Konfidenzschwelle, indem du den Prüfaufwand misst. Führe anschließend Batch Annotation aus und überprüfe das Ergebnis anhand der Bearbeitungsrate.
Daten kuratieren, Duplikate entfernen und aufteilen
Finde mit zwei kurzen Skripten Duplikate zwischen den Aufteilungen und Lücken bei Klassen, teile die Daten nach der maßgeblichen Einheit auf und fixiere eine geprüfte Datensatzversion.
Modul 3
Durchläufe trainieren, auswerten und fein abstimmen
Starte einen budgetierten Cloud-Durchlauf, bewerte ihn anhand seiner Kurven pro Epoche und stimme das Modell fein ab, ohne dass der Standardoptimierer deine Lernrate ignoriert.
Läufe vergleichen und den Gewinner auswählen
Vergleiche Läufe in einem Platform-Projekt, halte fest, warum jeder Lauf durchgeführt wird, und entscheide mit einem Skript für die Freigabeprüfung, ob ein Kandidat veröffentlicht wird.
Modul 4
Einen Endpunkt bereitstellen und aufrufen
Erstelle in einer von 42 Regionen einen dedizierten Endpunkt, passe seine Größe an dein Anfrageaufkommen an und rufe ihn mit einem Client auf, der Kaltstarts, 429-Antworten und ungültige Schlüssel zuverlässig behandelt.
Zustand und Genauigkeit überwachen
Lies die Endpunktmetriken und Vorhersagestatistiken der Platform aus, richte Benachrichtigungen über eine zeitgesteuerte Zustandsprüfung ein und erkenne Genauigkeitsdrift mit einem Prüfdatensatz-Auftrag.
Datenschutz, Regionen und Compliance
Wähle Daten- und Deployment-Regionen gemäß deinen Verträgen aus, halte Daten privat, anonymisiere Bilder vor dem Upload und arbeite eine Compliance-Checkliste vor dem Start ab.
Den Nachschulungsprozess automatisieren
Verwandle ein Deployment in einen wiederholbaren Prozess: mit einem Runbook, einem skriptgesteuerten Freigabekriterium, einer automatisierten Veröffentlichung mit Rollback und einer wöchentlichen Überprüfung.