Einen Endpunkt bereitstellen und aufrufen
Erstelle in einer von 42 Regionen einen dedizierten Endpunkt, passe seine Größe an dein Anfrageaufkommen an und rufe ihn mit einem Client auf, der Kaltstarts, 429-Antworten und ungültige Schlüssel zuverlässig behandelt.
Bei einem kostenlosen Endpunkt, der bis auf null skaliert, kann die erste Anfrage bis zu einer Minute dauern. Ein einfacher Client führt dann zu einer Zeitüberschreitung, die Nutzer sehen. Ein durchgesickerter Schlüssel funktioniert auch nach dem Löschen weiter. In dieser Lektion stellst du dein Gewinner-Modell bereit, wählst bewusst die passende Endpunktgröße und schreibst einen kleinen Client, den jede Integration für den Produktionseinsatz benötigt.
Praxisnah
Gemeinsame Inferenz oder dedizierter Endpunkt#
Jedes Modell lässt sich bereits über die gemeinsame Inferenz-API von Platform aufrufen, die sich für Tests eignet. Für den Produktionseinsatz solltest du einen dedizierten Endpunkt verwenden:
| Gemeinsame Inferenz | Dedizierter Endpunkt | |
|---|---|---|
| Dienst | Von Platform-Nutzern gemeinsam genutzt | Ein Modell, einzelner Mandant |
| Regionen | Deine Datenregion (US, EU oder AP) | Eine von 42 Regionen |
| Ratenbegrenzung | 20 Anfragen pro Minute und Schlüssel | Keine Platform-Begrenzung für direkte Aufrufe |
| Anfragegröße | Etwa 4.5 MB | 32 MB, bis zu 1 Stunde pro Anfrage (Video wird unterstützt) |
| Authentifizierung | Beliebiger API-Schlüssel des Arbeitsbereichs | Nur der an die Bereitstellung gebundene Schlüssel |
Endpunkt erstellen und dimensionieren#
Öffne den Tab Deploy des Modells. Dein Browser misst die Latenz zu allen 42 Regionen (14 in Amerika, 13 in Europa, 12 im asiatisch-pazifischen Raum, 3 im Nahen Osten und in Afrika) und sortiert die Tabelle danach:
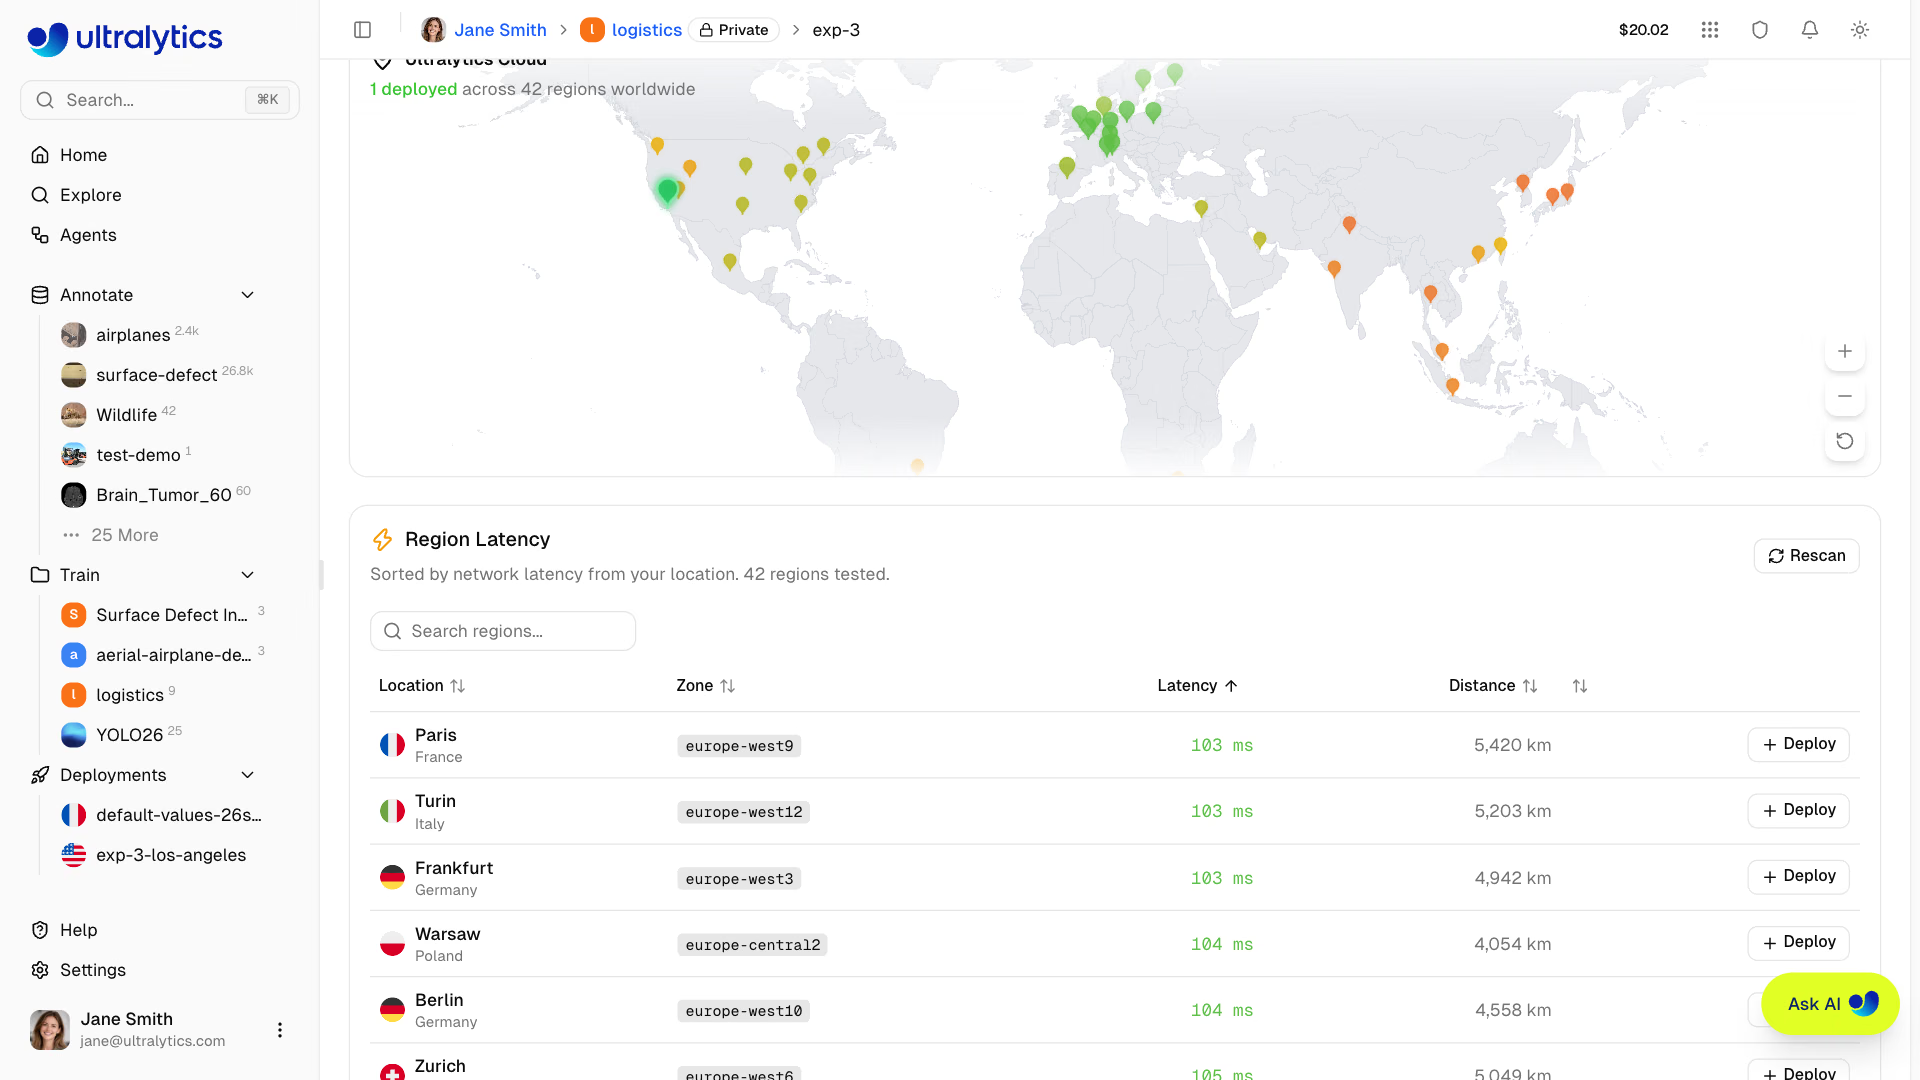
Klicke in der Zeile der Region, die deinen Aufrufern am nächsten liegt, auf Deploy, überprüfe CPU, Arbeitsspeicher, Preis und den generierten Namen (z. B. yolo26n-iowa) und klicke auf Create Deployment. Du kannst auch über New Deployment im Tab „Deployments“ deines Profils beginnen:
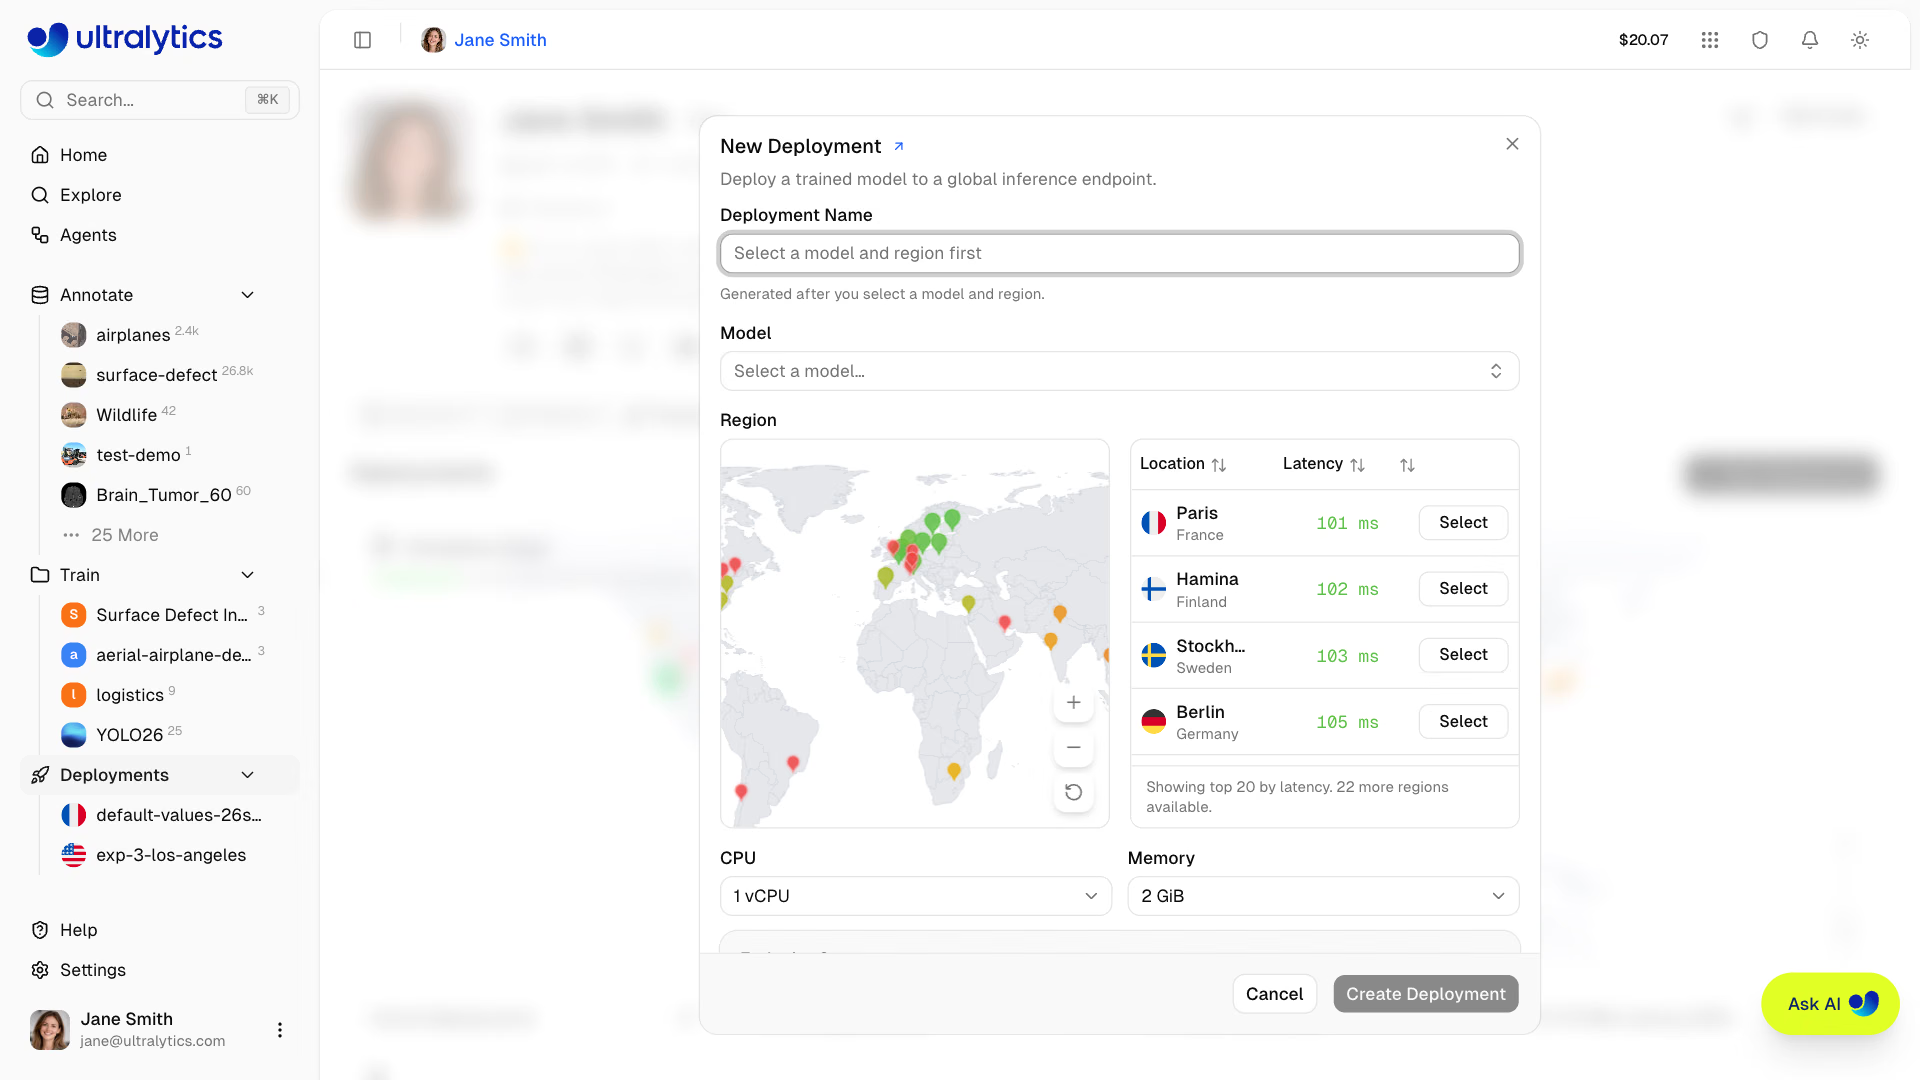
Dimensioniere nach dem Verkehrsmuster:
| Verkehr | Umfang | Kosten |
|---|---|---|
| Batch-Aufträge, interne Tools, Demos mit Lastspitzen | Standardmäßig 1 vCPU, 2 GiB; skaliert auf null | Bei jedem Tarif kostenlos |
| Gleichmäßiger Echtzeitverkehr, der nicht auf einen Kaltstart warten kann | Benutzerdefinierte Größe (1–8 vCPU, 2–32 GiB) mit einer warm gehaltenen Instanz | Ab Betriebsbereitschaft bis zum Stoppen stündliche Abrechnung, auch bei Leerlauf: etwa 0,12 $/h für 1 vCPU, 4 GiB in Iowa |
| Nutzer auf mehreren Kontinenten | Ein Endpunkt pro Region hinter deinem eigenen Router | Jeder Endpunkt wird entsprechend seiner Größe abgerechnet |
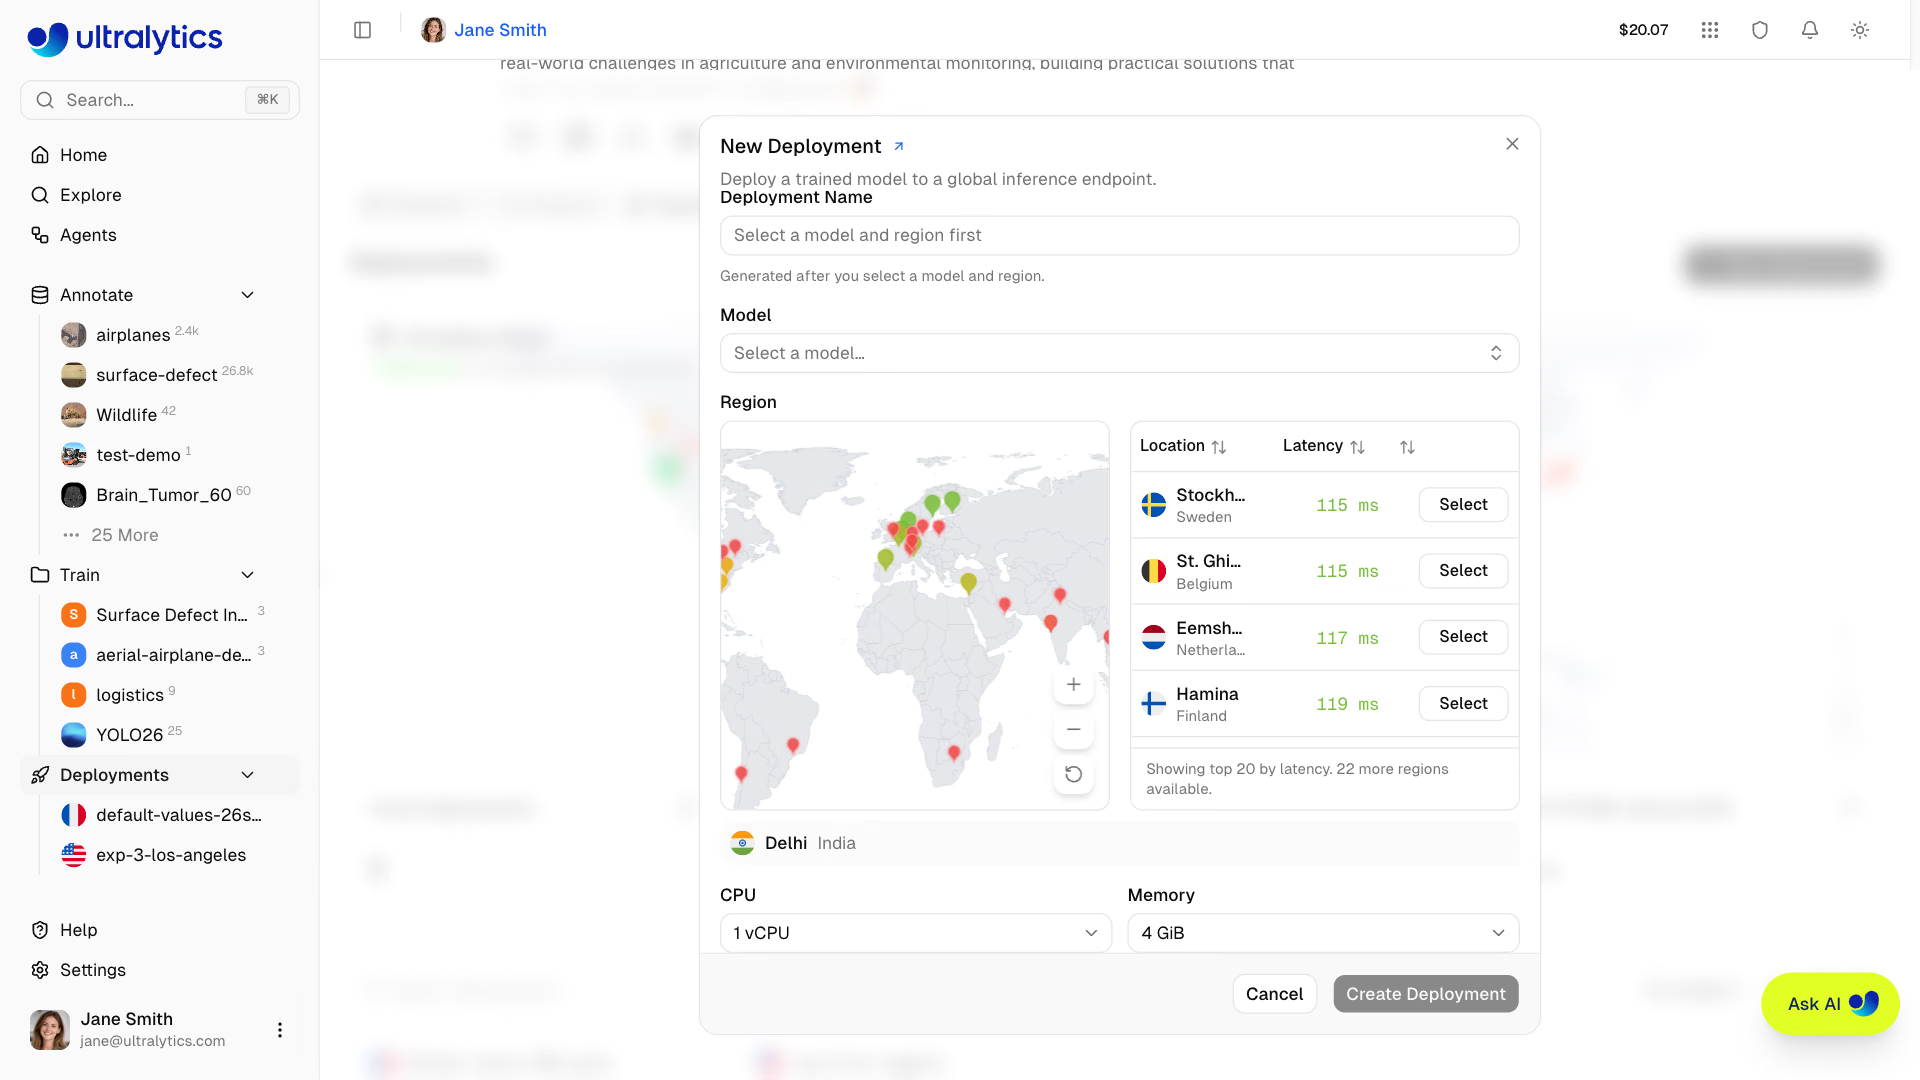
Die Tarife erlauben 3 (Free), 10 (Pro) oder unbegrenzt viele (Enterprise) Bereitstellungen; auch gestoppte Endpunkte werden mitgezählt. Der Endpunkt nimmt Traffic entgegen, sobald sein Status Ready anzeigt:
Praxisbeispiel: Ein Client, der den Produktivbetrieb übersteht#
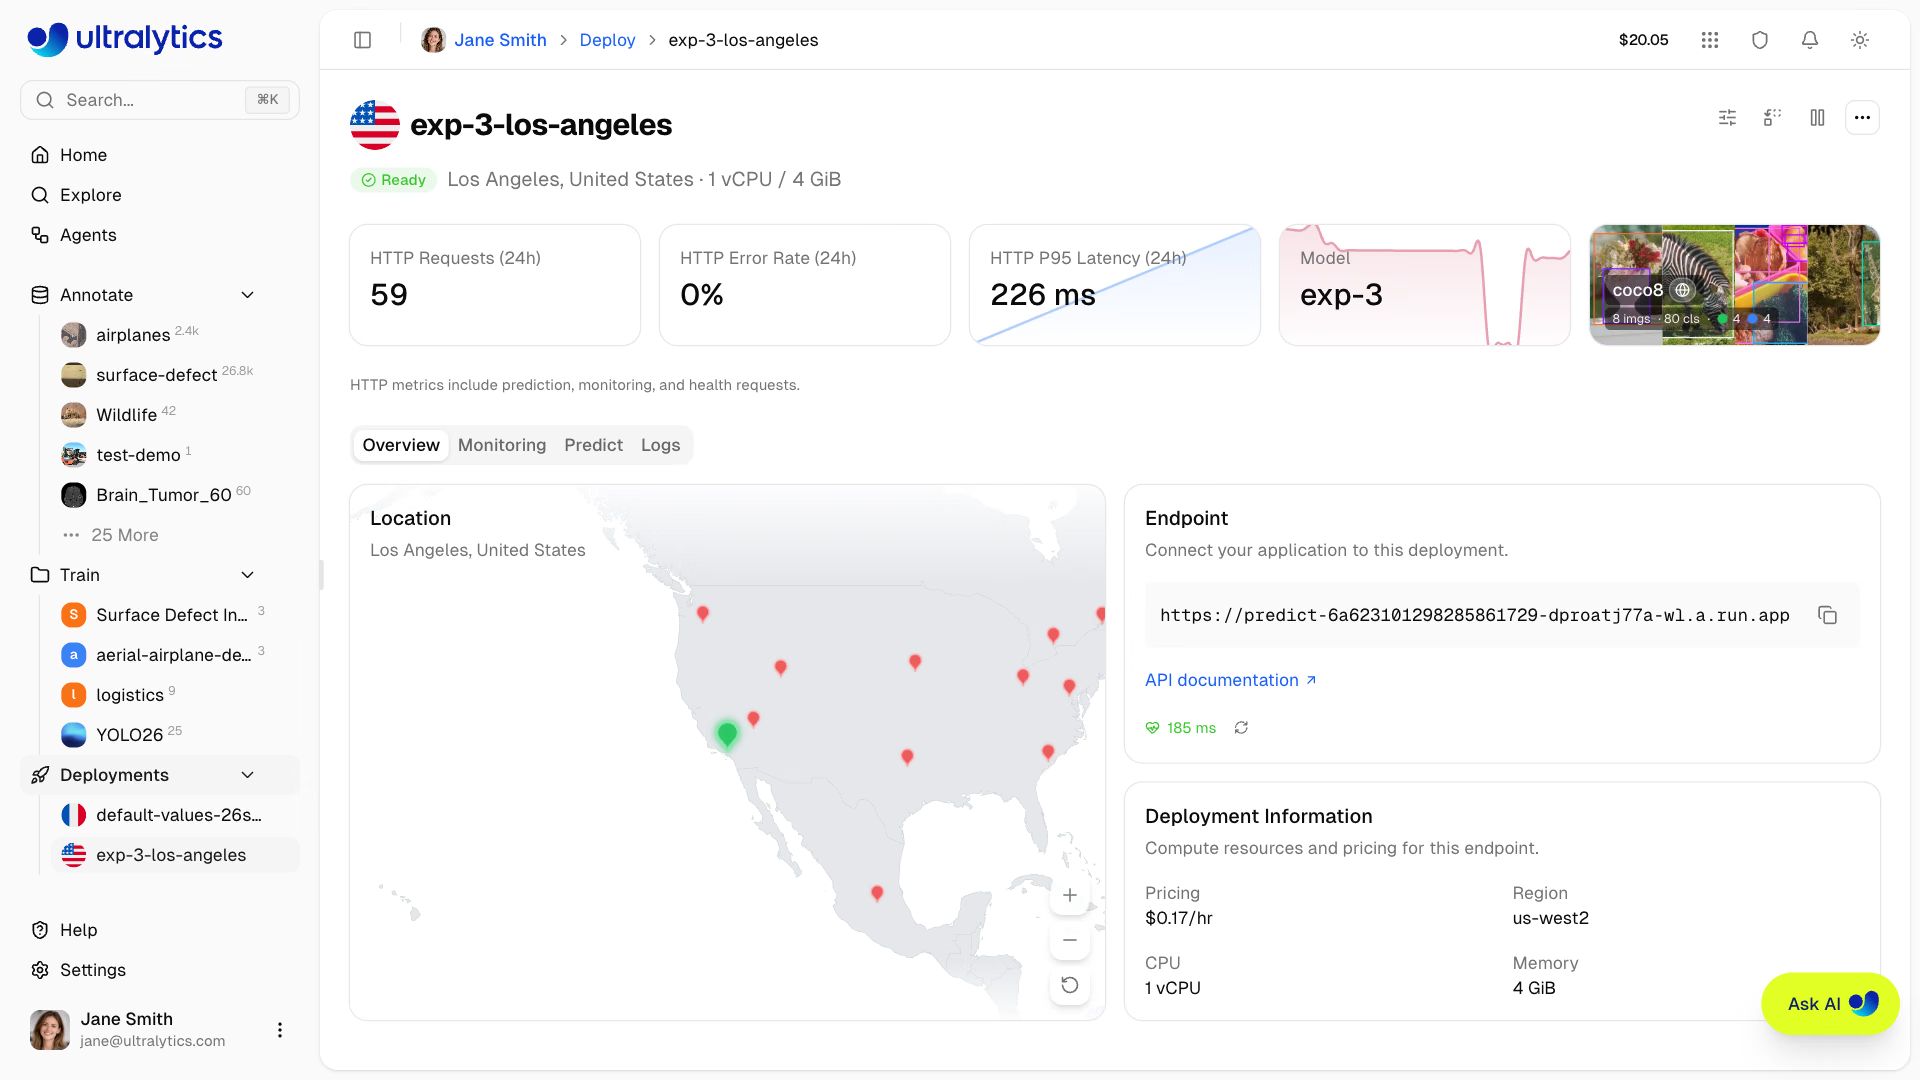
Jeder Endpunkt hat eine URL wie https://predict-<id>-<hash>-<region>.a.run.app und stellt /predict (POST), /health sowie eine interaktive Seite /docs bereit. Er akzeptiert nur den bei der Erstellung gebundenen API-Schlüssel; Eigentümer des Arbeitsbereichs sehen diesen Schlüssel im Tab Predict der Bereitstellung unter Docs vorausgefüllt, neben Codebeispielen für Python, JavaScript und cURL. Die Codebeispiele senden jeweils eine Anfrage; Produktivcode muss auch einen Kaltstart und eine ausgelastete Instanz überstehen:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Wir haben den Code mit einem lokalen Stub getestet, der einmal 429 zurückgibt und danach ein echtes YOLO26n-Ergebnis für bus.jpg im Antwortformat des Endpunkts liefert:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
Die wichtigen Entscheidungen im Einzelnen:
timeout=90deckt einen Kaltstart von bis zu etwa einer Minute ab; die Standard-Timeouts der meisten HTTP-Clients sind viel kürzer.- 429- und 5xx-Fehler werden erneut versucht; dabei wird
Retry-Afterberücksichtigt, wenn der Endpunkt diesen Wert sendet. Jeder Endpunkt verarbeitet Anfragen über eine einzelne Instanz und weist bei hoher Auslastung mit429Last ab. - Bei anderen 4xx-Fehlern wird der Vorgang sofort abgebrochen:
401bedeutet, dass der falsche Schlüssel verwendet wurde, und413, dass der Inhalt mehr als 32 MB umfasst. Keiner dieser Fehler behebt sich von selbst. - Die Antwort enthält in
imageseinen Eintrag pro Bild (oder Videobild), jeweils mitresults(class,name,confidence,boxmitx1,y1,x2,y2) undspeedin Millisekunden.
Optionale Formularfelder sind conf (Standardwert 0.25), iou (0.7), imgsz (Trainingsgröße des Modells), vid_stride für Video und normalize=true für Koordinaten im Bereich 0–1. Das entsprechende cURL-Beispiel enthält eine Zeile pro Feld:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Neue Versionen bereitstellen, ohne die URL zu ändern#
Mit Replace model auf der Bereitstellungsseite wird ein anderes fertiggestelltes Modell aus demselben Arbeitsbereich eingesetzt. Das alte Modell wird weiterverwendet, bis das neue bereit ist; URL, Region und Schlüssel bleiben gleich. Schlägt die Einführung fehl, bleibt das vorherige Modell aktiv. Für ein Rollback verwendest du dieselbe Aktion mit dem vorherigen Modell. Lass es daher im Projekt. Mit Update configuration änderst du die Größe direkt, und Stop pausiert die Abrechnung und behält die URL bei.
Für manche Änderungen brauchst du einen neuen Endpunkt: Regionen sind festgelegt (für einen Wechsel musst du den Endpunkt löschen und neu erstellen, wobei eine neue URL entsteht), und benutzerdefinierte Domains werden nicht unterstützt. Schalte daher dein eigenes Gateway vor, wenn Aufrufer einen stabilen, gebrandeten Hostnamen benötigen. Um das Modell außerhalb der Platform auszuführen, exportiere das Modell (Für die Bereitstellung exportieren) oder hoste es selbst hinter dem Triton Inference Server.
Stolperfallen#
Symptom: Dein Endpunkt erhält Zugriffe, die du nicht zuordnen kannst. Lösung: Hinterlege den Schlüssel niemals in einer Web- oder Mobilanwendung, sondern rufe den Endpunkt von deinem Backend aus auf. Das Löschen oder Deaktivieren des gebundenen Schlüssels sperrt den Endpunkt nicht, da dieser weiterhin genau diese Schlüsselzeichenfolge akzeptiert. Um den Zugriff zu widerrufen, stoppe oder lösche die Bereitstellung und erstelle eine neue, an einen neuen Schlüssel gebundene Bereitstellung.
Symptom: Die erste Anfrage am Morgen schlägt fehl, beim erneuten Versuch funktioniert es. Lösung: Endpunkte in der Standardgröße skalieren auf null herunter. Verwende ein Zeitlimit von mindestens 90 Sekunden, wärme den Endpunkt mit einem /health-Aufruf vor dem erwarteten Datenverkehr auf oder wechsle zu einer benutzerdefinierten Größe, wenn jede Anfrage schnell beantwortet werden muss.
Symptom: Uploads schlagen mit 413 fehl. Lösung: Dedizierte Endpunkte akzeptieren Anfrageinhalte mit einer Größe von bis zu 32 MB. Teile lange Videos in kürzere Clips auf oder sende ausgewählte Einzelbilder und übergib vid_stride, damit Einzelbilder serverseitig übersprungen werden.
Lösung anzeigen
Beispielantwort für die Pillenlinienkamera: Stelle v2-finetune in europe-west1 (St. Ghislain, die Region mit der niedrigsten Latenz zum deutschen Werk) mit der Standardgröße bereit. Kaltstart-Anfrage nach einer Stunde Leerlauf: 38 s, was der Timeout von 90 Sekunden abfängt; Warmstart-Anfrage: 0,3 s. Entscheidung: Die SPS der Linie sendet während der Schichten alle 30 Sekunden ein Bild, sodass der Endpunkt während der gesamten Schicht warm bleibt und nur beim ersten Bild ein Kaltstart anfällt. Ein Aufruf von /health durch den Liniencontroller 2 Minuten vor jeder Schicht verhindert auch das, sodass die kostenlose Standardgröße ausreicht und gegenüber einer benutzerdefinierten Instanz mit 1 vCPU und 4 GiB etwa 90 $ pro Monat gespart werden. Wenn du das Modell wieder durch v1-baseline ersetzt, liefert dieselbe URL die Ergebnisse von v1; ersetze es zum Abschluss erneut durch v2.