Trainiere dein erstes Modell
Passe YOLO26 mit einem einzigen Aufruf an deinen Datensatz an, lies das Trainingsprotokoll live Zeile für Zeile und finde best.pt sowie die wichtigen Diagramme im Ausführungsordner.
Das Training eines Detektors von Grund auf dauert Tage und erfordert riesige Datensätze. Das Anpassen eines vortrainierten YOLO26-Modells mit etwa hundert Bildern dauert auf einer Laptop-CPU ungefähr eine Minute, weil beim Transferlernen das Wissen des Modells über Kanten, Formen und Objekte wiederverwendet wird.
In dieser Lektion trainierst du mit dem Pillendatensatz, beobachtest, wie die mAP50-95 innerhalb von zehn Epochen von einem Wert nahe null auf 0.66 steigt, und lernst, frühzeitig am Protokoll zu erkennen, ob ein Trainingslauf gut verläuft oder deine Zeit verschwendet.
Praxisnah
Beispiel: Pillendetektor trainieren#
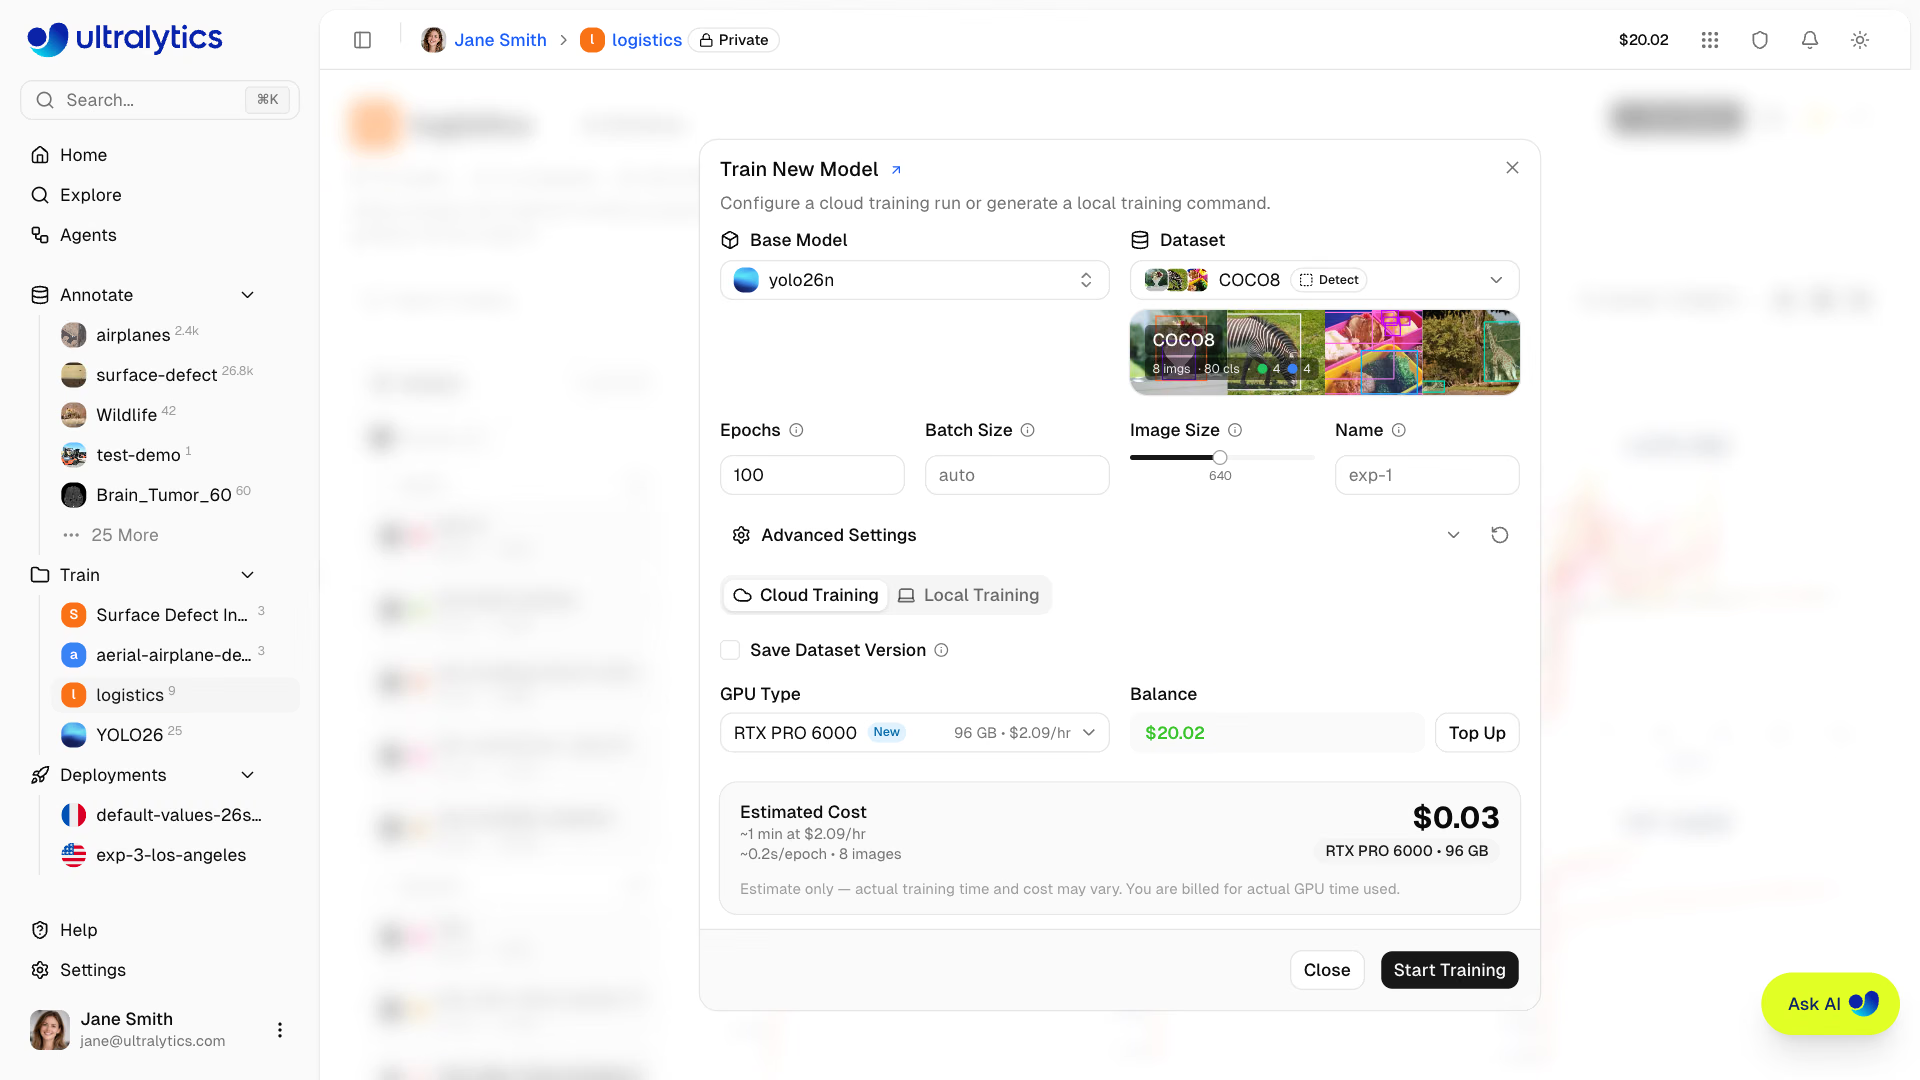
Der Dialog „Neues Modell trainieren“ der Ultralytics Platform fragt nach denselben Einstellungen wie der folgende Code — Basismodell, Datensatz, Epochen und Bildgröße — und führt den Trainingslauf entweder auf Cloud-GPUs aus oder erzeugt den passenden lokalen Befehl. Mit diesen Einstellungen dauert das Training auf einer Laptop-CPU ungefähr eine Minute:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # auf COCO vortrainiert
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI und Python sind gleichwertig. epochs=10 und imgsz=320 halten Trainingsläufe auf der CPU kurz; mit einer GPU kannst du beide weglassen und die Standardwerte übernehmen (epochs=100, imgsz=640), denn mehr Epochen und Pixel sind fast immer hilfreich. Der Trainingsmodus führt diese Schleife für dich aus:
Das Protokoll Zeile für Zeile lesen#
Echte Ausgabe, gekürzt auf die ersten und letzten beiden Epochen:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): Der Standardwertoptimizer=autohat Optimierer und Lernrate für dich ausgewählt.Using 92 train, 23 val images: Prüfe, ob diese Werte mit deinem Datensatz übereinstimmen. Eine kleinere Zahl bedeutet, dass Bilder übersprungen wurden.GPU_mem 0G: Das Training läuft auf der CPU. Auf einer GPU würdest du hier den Speicherverbrauch sehen;0Gauf einem Rechner mit GPU bedeutet, dass die GPU nicht verwendet wird.- Erste Zeile jeder Epoche: die drei Verluste für den Trainingssplit sowie die Anzahl der gelabelten Objekte im letzten Batch (
Instances) und die Bildgröße. - Zeile
alljeder Epoche: Präzision, Trefferquote, mAP50 und mAP50-95 für den Validierungssplit. Auf diese Zeile kommt es an.
| Spalte | Bedeutung | Guter Verlauf |
|---|---|---|
box_loss | Abstand der vorhergesagten Boxen zu den annotierten Boxen | Sinkt und flacht dann ab |
cls_loss | Wie stark die Klassenwerte danebenliegen | Sinkt und flacht dann ab |
l1_loss | YOLO26s direkter Fehler bei den Boxkoordinaten | Sinkt |
P, R | Präzision und Trefferquote beim Validierungssplit | Steigen und bleiben ausgeglichen |
mAP50, mAP50-95 | Erkennungsqualität; mAP50-95 belohnt auch eng anliegende Boxen | Steigt und erreicht dann ein Plateau |
Hier stieg die mAP50-95 vom Ausgangswert 0.0002 auf 0.548 nach einer Epoche und 0.659 nach zehn. Die Präzision sank in Epoche 4 auf 0.80 und erholte sich wieder: Bei 23 Validierungsbildern schwanken einzelne Epochen stark. Beurteile daher den Verlauf, nicht eine einzelne Zeile. Entscheidungshilfen für einen laufenden Trainingslauf:
- Die Verluste sinken und die mAP steigt: Lass den Lauf weiterlaufen.
- Die Verluste bleiben ab Epoche 1 unverändert: Beende den Lauf mit Ctrl+C und prüfe die Labels und die YAML-Datei.
- Die Präzision ist viel höher als die Trefferquote: Das Modell ist vorsichtig und übersieht Objekte. Die Trefferquote ist viel höher als die Präzision: Das Modell erkennt Objekte, die gar nicht vorhanden sind.
- Die mAP bleibt über viele Epochen unverändert: Weitere Epochen helfen nicht; ändere die Daten oder
imgsz.
Die drei Verluste sind die Bestandteile der Verlustfunktion von YOLO26; der Leitfaden zu Leistungsmetriken erläutert jede Metrik ausführlich.
Ergebnisse des Trainingslaufs finden#
Alles landet in runs/detect/pills_v1/:
| Datei | Verwendungszweck |
|---|---|
weights/best.pt | Checkpoint mit der besten Validierungsleistung über alle Epochen; verwende ihn für Inferenz und Export |
weights/last.pt | Neuester Checkpoint; dient zum Fortsetzen eines unterbrochenen Trainingslaufs |
args.yaml | Alle Argumente des Trainingslaufs zur Reproduktion |
results.csv, results.png | Verluste und Metriken für jede Epoche, als Daten und Diagramme |
labels.jpg | Klassenanzahlen sowie Histogramme zu Größe und Position der Boxen |
train_batch*.jpg | Augmentierte Trainings-Batches mit eingezeichneten Labels |
val_batch*_labels.jpg, val_batch*_pred.jpg | Ground Truth und Vorhersagen auf Validierungsbildern |
confusion_matrix*.png, Box*_curve.png | Konfusionsmatrix sowie Präzisions-, Trefferquoten-, F1- und PR-Kurven |
Öffne zuerst train_batch0.jpg. Wenn die Boxen nicht auf den Objekten liegen, sind die Labels falsch, und keine Anzahl von Epochen kann das beheben.
Diese Argumente solltest du zuerst ändern#
| Argument | Standard | Ändern, wenn |
|---|---|---|
epochs | 100 | Kurze CPU-Experimente oder winzige Datensätze, bei denen Overfitting einsetzt (niedriger); große Datensätze, deren Leistung sich weiter verbessert (höher, 200–300) |
imgsz | 640 | Kleine Objekte (auf 1024 oder 1280 erhöhen) oder CPU-Experimente (verringern) |
batch | 16 | Batchgröße: Bei Speicherfehlern verringern oder -1 verwenden, um sie automatisch auf etwa 60 % des GPU-Speichers festzulegen |
patience | 100 | Den Trainingslauf vorzeitig beenden, wenn sich die Validierungsleistung N Epochen lang nicht verbessert hat, z. B. mit patience=20 |
device | auto | cpu, mps, einen GPU-Index wie 0 oder mehrere Indizes wie [0, 1] erzwingen |
name | train | Immer: Trainingsläufe nach der jeweiligen Änderung benennen |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")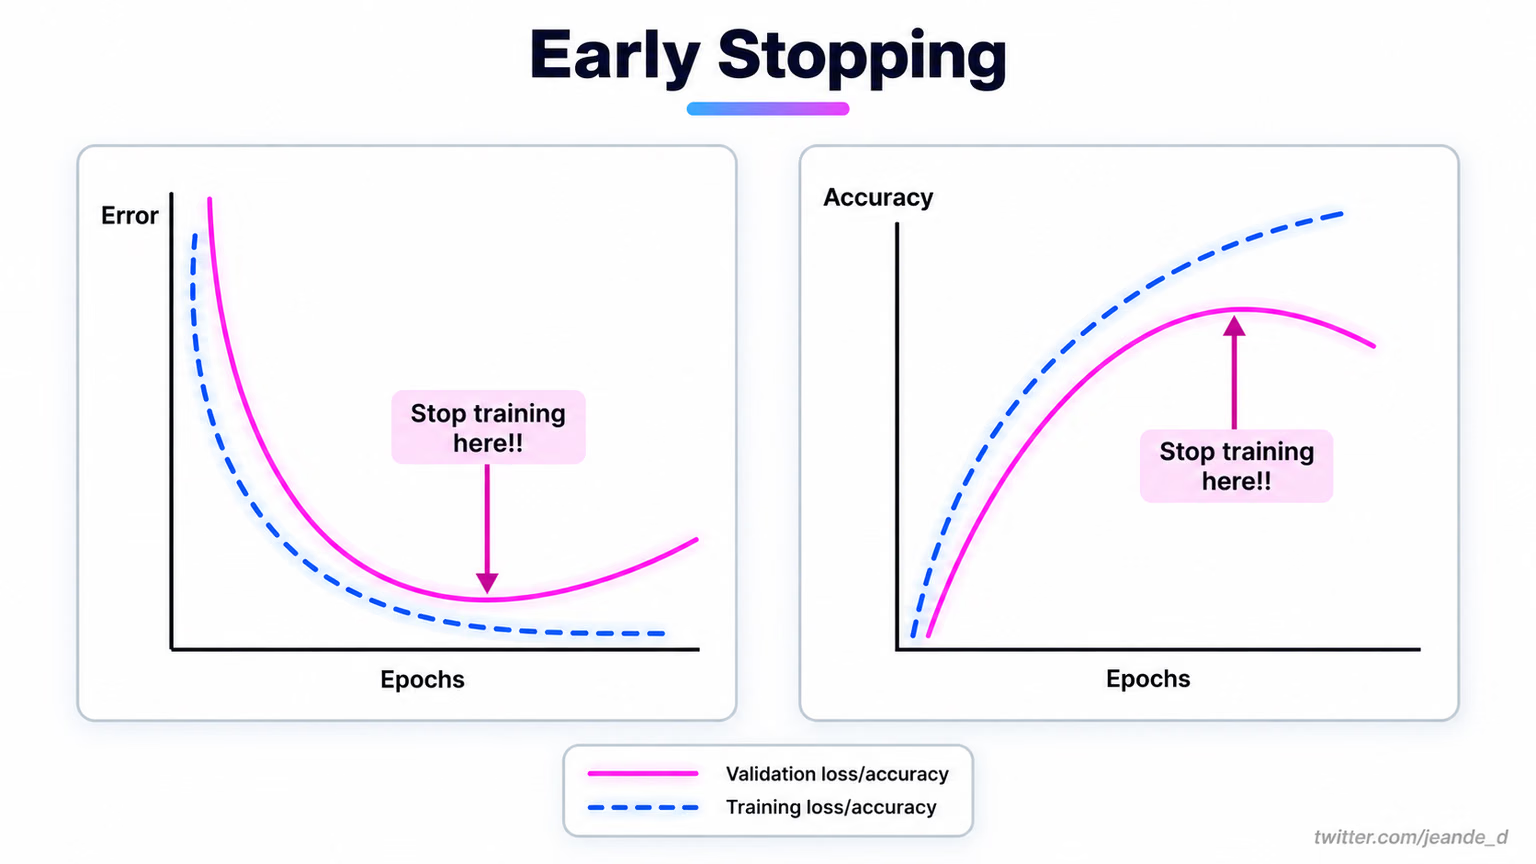
Der Standardwert 100 für patience bedeutet, dass ein Lauf mit 100 Epochen nie vorzeitig beendet wird. Ein niedrigerer Wert beendet einen stagnierenden Lauf an dem Punkt, den die obigen Kurven anzeigen; best.pt wird in jedem Fall gespeichert.
Bei mehreren GPUs übergibst du eine Liste wie device=[0, 1, 2, 3]: Ultralytics startet für dich das verteilte Training mit datenparalleler Verarbeitung (DDP), batch bezeichnet die Gesamtzahl über alle GPUs, und standardmäßig wird beim Training gemischte Präzision verwendet (amp=True). Wenn dein Laptop für einen Trainingslauf nicht mehr ausreicht, kannst du denselben Datensatz und dieselben Argumente auf Cloud-GPUs der Ultralytics Platform ausführen, wie unter Trainingsläufe trainieren, auswerten und anpassen beschrieben.
Diese Fehler vermeiden#
Symptom: mAP nahe null nach vielen Epochen auf einem kleinen Datensatz. Ursache: Das Modell stammt aus yolo26n.yaml (zufällige Gewichte) statt aus yolo26n.pt. Lösung: Beginne immer mit einem vortrainierten .pt. Training von Grund auf lohnt sich nur für Forschung an Backbones oder sehr große Datensätze.
Symptom: CUDA out of memory in der ersten Epoche. Lösung: Halbiere batch oder setze batch=-1, damit AutoBatch eine passende Größe auswählt. Ein niedrigerer Wert für imgsz hilft ebenfalls, verändert aber, was das Modell sehen kann.
last.pt ist die letzte Epoche, die schlechter als eine frühere sein kann. best.pt ist die Epoche mit der besten Validierungsleistung; genau diese solltest du validieren, exportieren und bereitstellen.
Der Leitfaden mit Tipps zum Modelltraining behandelt die übrigen Argumente; der Leitfaden zur Hyperparameteroptimierung erläutert Lernraten-Suchläufe und den genetischen Optimierer. Der Leitfaden zur Modellanpassung behandelt das Einfrieren von Schichten.
Lösung anzeigen
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsDie genauen Werte variieren leicht je nach Hardware und Paketversion.