Validieren und Fehler diagnostizieren
Validiere best.pt anhand eines Basismodells, lies die Konfusionsmatrix, die klassenbezogenen Werte und die Vorhersagebilder und leite daraus eine konkrete Liste von Verbesserungen ab.
Eine einzelne mAP-Zahl verrät dir, wie viel das Modell falsch macht, aber nicht was. Übersehene kleine Objekte, miteinander verwechselte Klassen und zu locker sitzende Boxen senken die mAP, und jedes dieser Probleme erfordert eine andere Lösung. Wenn du die Ursache falsch einschätzt, verbringst du eine Woche damit, die falschen Daten zu sammeln.
In dieser Lektion führst du den Validierungsmodus für best.pt aus, vergleichst die Ergebnisse mit dem Basismodell und wertest die Konfusionsmatrix sowie die Vorhersagebilder aus, bis du eine Liste von Verbesserungen für die nächste Runde erstellen kannst. Der Leitfaden zu Leistungsmetriken bietet eine ausführliche Ergänzung.
Praxisnah
Beispiel: best.pt validieren#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Echte Ausgabe von val.py:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
Die Diagramme werden in einem neuen Ordner runs/detect/val gespeichert (danach val-2 usw.). Stelle die Werte neben die des Basismodells:
| Modell | mAP50 | mAP50-95 |
|---|---|---|
Vortrainiertes yolo26n.pt (keine Pillenklasse) | 0.001 | 0.0002 |
pills_v1 (10 Epochen, imgsz 320, CPU) | 0.977 | 0.659 |
Was die Zahlen aussagen:
- Präzision 0.970, Recall 0.957: ausgewogen. Wenige Fehlalarme, wenige übersehene Objekte.
- mAP50 0.977: Bei einer großzügigen Überlappungsanforderung findet das Modell fast jede Pille.
- mAP50-95 0.659: Bei strenger Überlappung sind viele Boxen nicht eng genug. Eine so große Lücke deutet eher auf die Lokalisierung hin – mehr Epochen, ein größeres
imgszoder präzisere Labels – als auf fehlende Daten.
Wie Präzision, Recall und mAP gegeneinander abgewogen werden, erfährst du in Detection-Metriken richtig interpretieren.
Welche Datei beantwortet welche Frage?#
| Frage | Datei |
|---|---|
| Welche Klassen werden verwechselt, und welche werden übersehen? | confusion_matrix_normalized.png |
| Wie wird bei jeder Klasse Präzision gegen Recall abgewogen? | BoxPR_curve.png |
| Bei welchem Konfidenz-Schwellenwert soll das Modell eingesetzt werden? | BoxF1_curve.png: Der Spitzenwert ist ein guter Ausgangspunkt für conf. |
| Wie sehen die Fehler aus? | val_batch0_labels.jpg im Vergleich zu val_batch0_pred.jpg |
| Ist das Modell überangepasst? | results.png im Trainingsordner |
Die Konfusionsmatrix lesen#
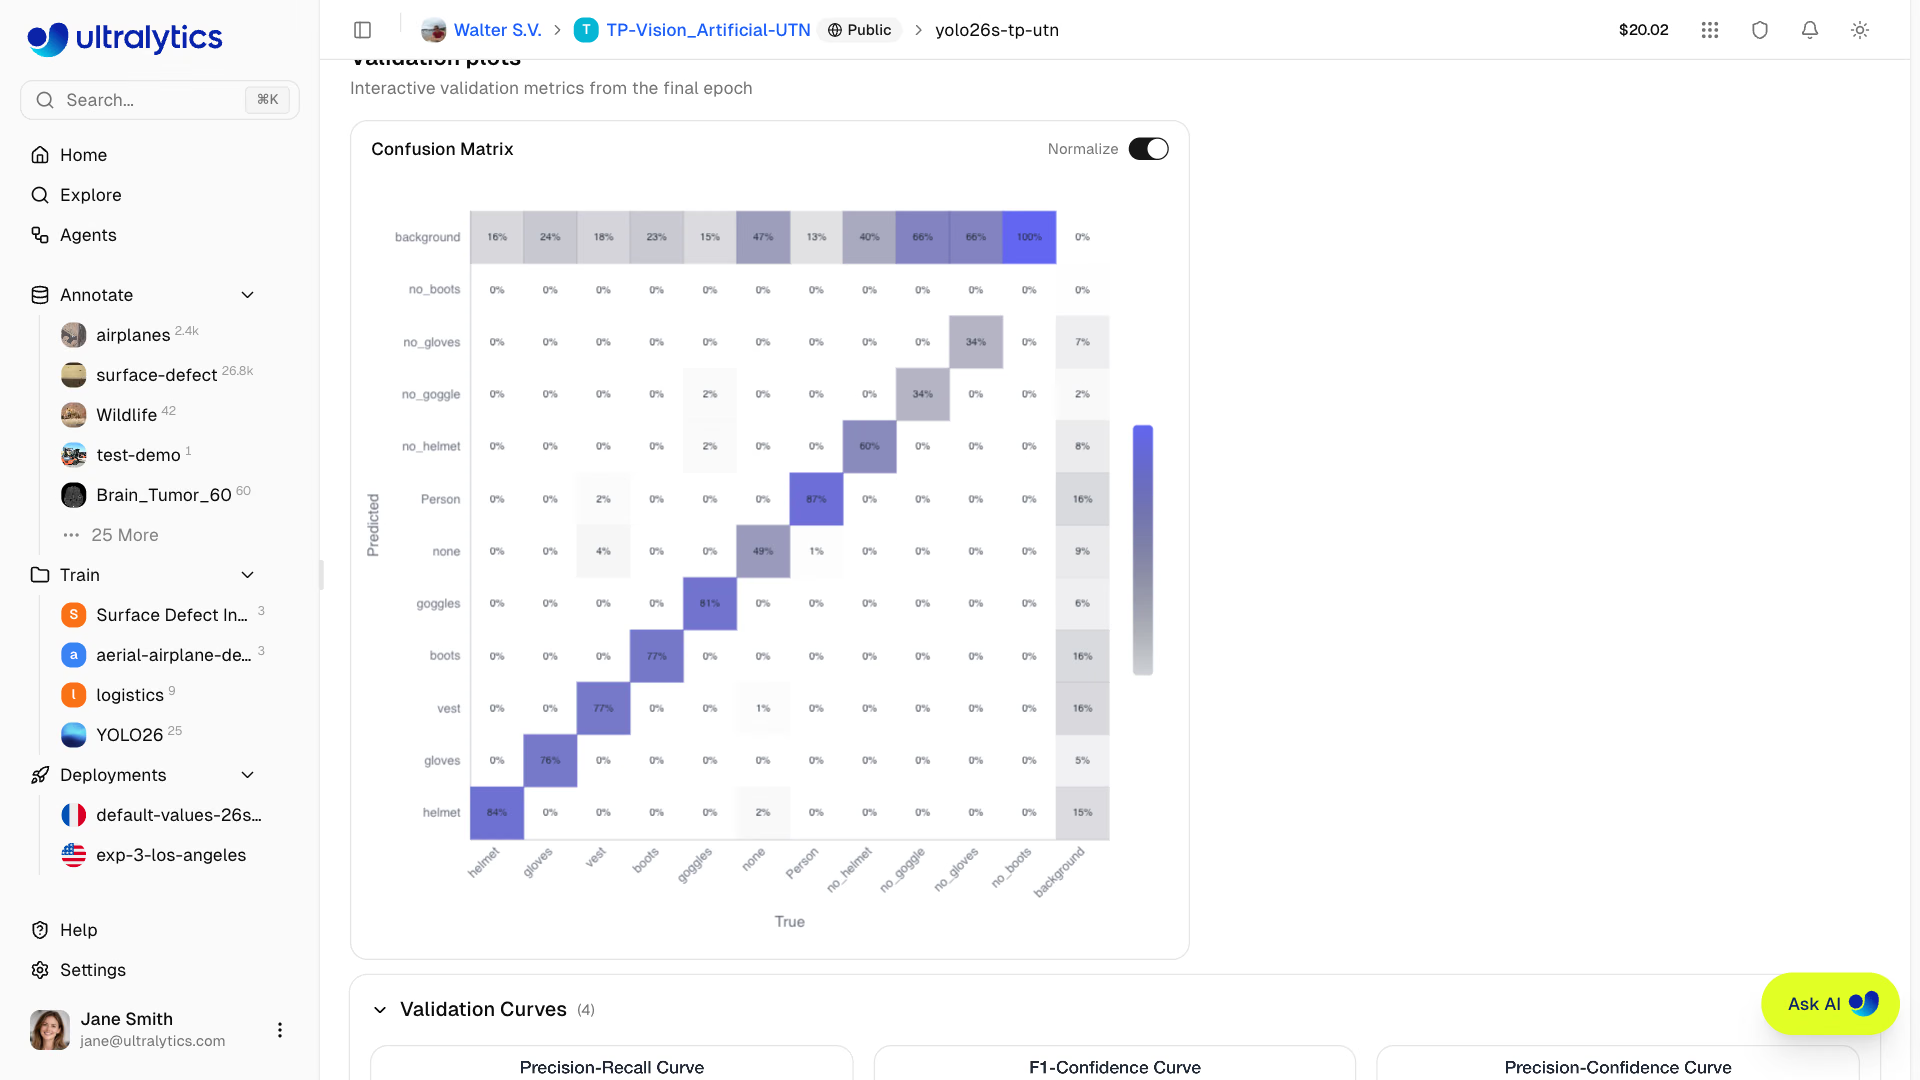
Die Konfusionsmatrix ist das mit Abstand nützlichste Diagnosewerkzeug. In Ultralytics-Diagrammen stehen die tatsächlichen Klassen in den Spalten und die vorhergesagten Klassen in den Zeilen, ergänzt um eine background-Zeile und -Spalte. Bei der normalisierten Version wird jede Spalte durch ihre Summe geteilt. So zeigt jede Spalte, wo die Objekte dieser Klasse zugeordnet wurden. Im Pillen-Datensatz gibt es nur eine Klasse; übe deshalb mit diesem Beispiel aus einem Lager mit drei Klassen (Beispielwerte):
| Vorhergesagt ↓ / Tatsächlich → | Gabelstapler | Person | Palette | Hintergrund |
|---|---|---|---|---|
| Gabelstapler | 0.78 | 0.03 | 0.18 | 0.45 |
| Person | 0.04 | 0.91 | 0.00 | 0.20 |
| Palette | 0.10 | 0.00 | 0.65 | 0.35 |
| Hintergrund | 0.08 | 0.06 | 0.17 | — |
- Diagonale: Anteil jeder Klasse, der korrekt erkannt wurde. Die Palette ist mit 0.65 die schwächste Klasse.
- Außerhalb der Diagonalen: Verwechslungen. 18 % der tatsächlichen Paletten wurden als Gabelstapler vorhergesagt und 10 % der Gabelstapler als Paletten.
- Hintergrundzeile: übersehene Objekte. 17 % der Paletten wurden überhaupt nicht erkannt.
- Hintergrundspalte: falsch-positive Erkennungen, also Boxen auf leerem Bildbereich. 45 % davon wurden als Gabelstapler eingestuft.
Jeder Zelltyp weist auf eine mögliche Abhilfe hin:
| Muster | Lösung |
|---|---|
| Zwei Klassen verwechseln sich gegenseitig | Füge Beispiele hinzu, die sie voneinander unterscheiden: Gabelstapler mit Paletten, Paletten neben Gabelstaplern gestapelt |
| Hoher Wert in der Hintergrundzeile (übersehene Objekte) | Mehr Beispiele für diese Klasse unter den Bedingungen, bei denen sie übersehen wird |
| Hoher Wert in der Hintergrundspalte (Fehlalarme) | Hintergrundbilder von Szenen, die diese Fehlalarme auslösen, etwa leere Gänge |
Die Zahlen für einzelne Klassen lesen#
Bei mehreren Klassen gibt das Validierungsprotokoll eine Zeile pro Klasse aus. metrics.box.maps enthält die mAP50-95-Werte je Klasse für den Code. Weiter mit dem Lagerbeispiel:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet liegt deutlich unter den anderen Werten und umfasst nur 7 Instanzen in der Validierung. Entweder erkennt das Modell Paletten schlecht, oder es gibt zu wenige Validierungsdaten, um das festzustellen. In beiden Fällen ist der nächste Schritt derselbe: Sammle mehr Palettenbilder für Training und Validierung.
Die Fehler untersuchen#
Öffne val_batch0_labels.jpg und val_batch0_pred.jpg nebeneinander. Die Unterschiede zeigen die Fehler als Bilder; Muster darin helfen bei der Diagnose: übersehene Objekte am Bildrand, kleine Objekte, bestimmte Lichtverhältnisse oder ähnlich aussehende Objekte, die leicht verwechselt werden. Solche Muster im Datensatz sind fast immer wichtiger als die Optimierung der Hyperparameter.
Auf den Validierungsbildern des Pillenmodells erhalten deutlich sichtbare Pillen Konfidenzwerte nahe 1.0. Boxen mit niedriger Konfidenz von etwa 0.3–0.5 häufen sich bei Pillen, die teilweise von einer anderen Blisterpackung verdeckt werden, und bei Pillen, die am Bildrand abgeschnitten sind. Das lässt sich nicht durch Optimieren von conf beheben; es ist eine Frage der Richtlinien für die Beschriftung. Soll eine halb verdeckte Pille mitgezählt werden? Entscheide dich, halte die Regel schriftlich fest und beschrifte jedes Bild einheitlich.
Öffne anschließend results.png. Trainings- und Validierungsverluste sollten gemeinsam sinken. Sinkt der Trainingsverlust weiter, während der Validierungsverlust steigt, liegt Überanpassung vor; bleiben beide hoch, liegt Unteranpassung vor. Der Bias-Varianz-Kompromiss hilft, beides einzuordnen.
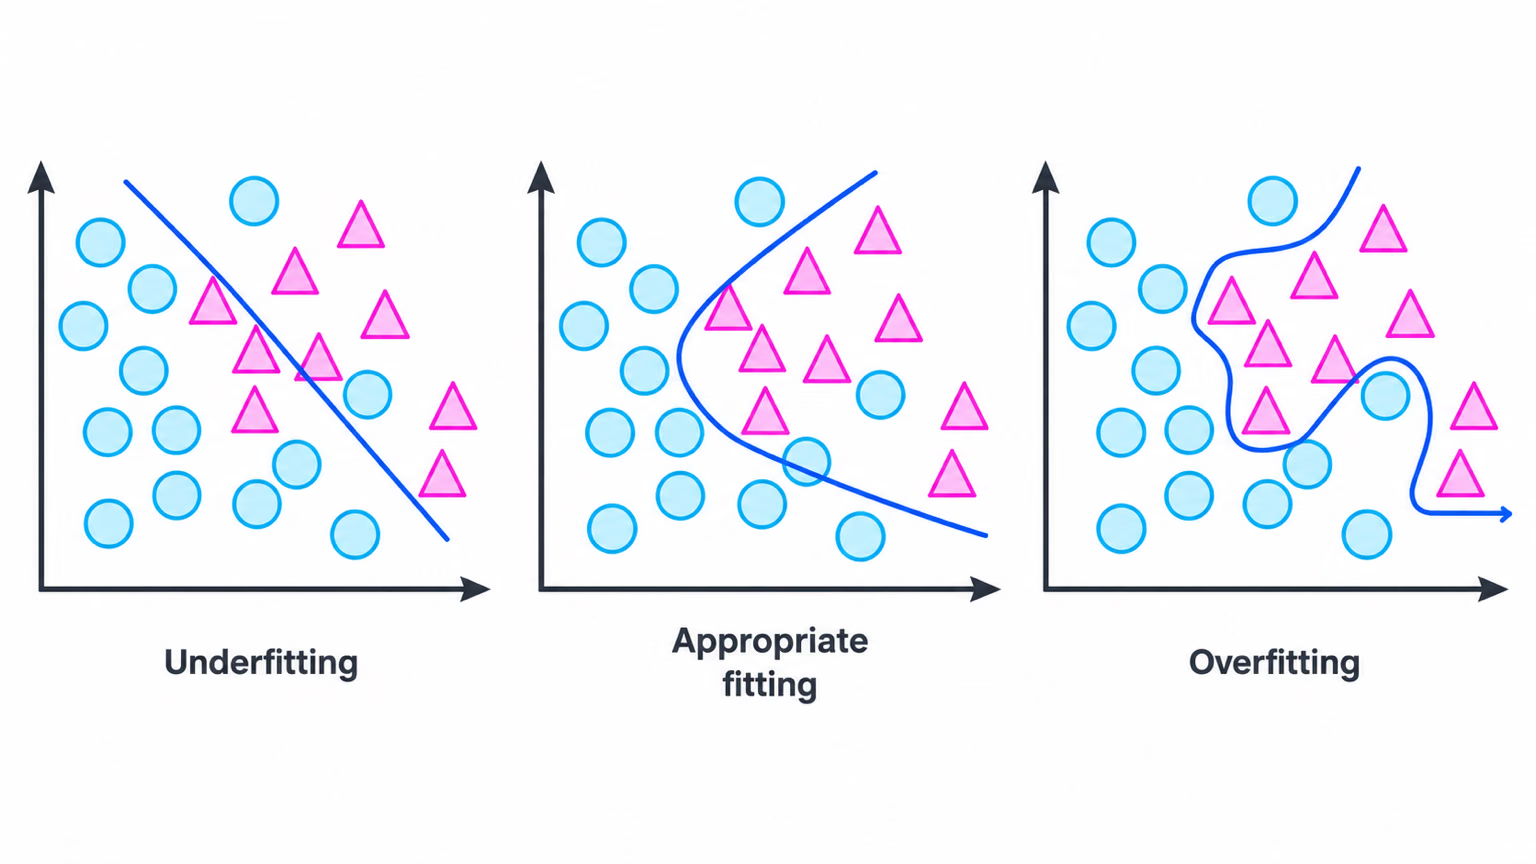
Bei Überanpassung helfen diese Maßnahmen, sortiert danach, wie häufig sie wirken: vielfältigere Daten; weniger Epochen oder ein kleineres patience; und Datenerweiterung (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). Die Standardwerte für die Datenerweiterung sind bereits wirkungsvoll. Ändere sie nur aus einem konkreten Grund, etwa um fliplr auszuschalten, wenn links und rechts eine Rolle spielen.
Erkenntnisse in eine Liste konkreter Maßnahmen umsetzen#
Verbessere die Daten, bevor du die Hyperparameter optimierst, und ändere pro Durchlauf nur eine Sache, damit du weißt, was geholfen hat. Die Arbeit am Datensatz in diesem Prozess wird unter Erste Feinabstimmung und der Iterationsprozess behandelt.
Diese Fehler vermeiden#
Symptom: Ein Modell, das 0.659 mAP50-95 erreichte, erzielt plötzlich nur noch 0.403. Ursache: pills_v1 wurde mit imgsz=320 trainiert und mit imgsz=640 validiert; Objekte erscheinen doppelt so groß wie alles, was das Modell gelernt hat. Lösung: Validiere und stelle das Modell mit der Trainingsgröße imgsz bereit und vergleiche Läufe nur bei gleicher Größe.
Bei der Validierung wird conf=0.001 verwendet, damit die vollständige Precision-Recall-Kurve ermittelt werden kann. Deshalb zeigt val_batch0_pred.jpg Boxen an, die deine Anwendung niemals ausgeben würde. Wähle den Schwellenwert für die Bereitstellung anhand von BoxF1_curve.png und prüfe ihn anschließend mit predict.
Bei 23 Bildern schwankte die Precision einer Epoche von 0.93 auf 0.80 und wieder zurück. Beurteile Trends über mehrere Epochen und Läufe hinweg und erweitere den Validierungsdatensatz, bevor du Unterschieden von ein oder zwei Punkten vertraust.
Lösung anzeigen
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.